Статьи по Delphi (029)…
| Обратный поиск строки в TRichEdit. |
Code: {+------------------------------------------------------------ | Function FindTextBackwards. | | Parameters : | findWhat: text to find. | inString: string to find it in. | startAt : character index to start at (1-based). | caseSensitive: determines whether search is case-sensitive. | words : if true the characters immediately surrounding. | a found location must not be alphanumeric. | Returns : | character index (1-based) of first character of a found. | location, or 0, if the text was not found. | Description: | Performs a simple sequential search for a string in a larger. | string, starting at the specified position and working towards. | the start of the string. | Error Conditions: none. | Created: 27.02.99 by P. Below. +------------------------------------------------------------} Function FindTextBackwards(findWhat, inString : string; StartAt : integer; CaseSensitive, words : boolean): integer; Var. I, patternlen, findpos : integer; Lastchar, firstchar : char; Begin. Result := 0; { assume failure }. Patternlen := Length(findWhat); { Do a few sanity checks on the parameters }. If (patternlen = 0) or. (startAt < patternlen) or. (Length(inString) < patternlen) then. Exit; If not caseSensitive then. Begin. { convert both strings to lower case }. FindWhat := AnsiLowercase(findWhat); InString := AnsiLowercase(inString); End; { If }. I := startAt; Lastchar := findWhat[patternlen]; Firstchar := findWhat[1]; While (Result = 0) and (i >= patternlen) do. Begin. If inString[i] = lastchar then. Begin. FindPos := i - patternlen + 1; If inString[findPos] = firstchar then. Begin. { We have a candidate. Compare the substring of length. Patternlen starting at findPos with findWhat. With. AnsiStrLComp we can do that without having to copy. The substring to a temp string first. }. If AnsiStrLComp(@findWhat[1], @inString[findPos], Patternlen) = 0 then. Begin. { We have a match! }. Result := findPos; If words then. Begin. { Check the characters surrounding the hit. For the hit. To constitute a word they must not be alphanumeric. }. If (findPos > 1) and. IsCharAlphanumeric(inString[findPos - 1]) then. Begin. { Not a match after all, <sigh>. }. Result := 0; End { If }. Else. Begin. If (i < Length(inString)) and. IsCharAlphanumeric(inString[i + 1]) then. Begin. { Not a match after all, <sigh>. }. Result := 0; End; { If }. End; { Else }. End; { If }. End; { If }. End; { If }. End; { If }. Dec(i); End; { While }. End; { FindTextBackwards }. Procedure TForm1.Button1Click(Sender : TObject); Var. FindPos : integer; Begin. FindPos := FindTextBackwards(findEdit.Text, Richedit1.Text, Richedit1.selstart + 1, CaseCheckbox.Checked, WordsCheckbox.Checked); If findPos > 0 then. Begin. With richedit1 do. Begin. Selstart := findPos - 1; Sellength := findEdit.GetTextLen; Perform(em_scrollcaret, 0, 0); SetFocus; End; End. Else. ShowMessage('Text not found'); End;
| Печать |
Печать
После всех настроек и просмотра печати можно переходить непосредственно к печати документа. Для этого будем использовать метод PrintOut объекта "Лист" коллекции Sheets. В функции Print в качестве аргументов передаем номер или имя листа и количество копий для печати.
Code: Function Print (sheet:variant;copies:integer):boolean; Begin. Print:=true; Try. E.ActiveWorkbook.Sheets.Item. [sheet].PrintOut(Copies:=copies); Except. Print:=false; End; End;
| Печать в delphi. |
Печать в delphi Объект printer автоматически создается в случае, если в программе указана ссылка на модуль printers. Этот объект предоставляет программисту все необходимое для того, чтобы научить приложение выводить данные на один из подключенных к компьютеру принтеров.
Вывод на принтер в windows ничем не отличается от вывода на экран: в распоряжение программиста предоставляется свойство canvas объекта printer, содержащее набор чертежных инструментов, и методы, свойственные классу tcanvas. Размер листа бумаги в пикселах определяют свойства height и width, а набор принтерных шрифтов – свойство fonts.
Печать текста Существует множество способов печати текста на принтере. Прежде всего следует назвать глобальную процедуру assignprn (она определена в модуле printers), позволяющую использовать принтер как текстовый файл и печатать текстовые строки с помощью процедуры writeln. В листинге 1 (printtext.dpr) приведен полный текст модуля, на форме которого расположены многострочный текстовый редактор memo1 и четыре кнопки: для выбора текстового файла и ввода его содержимого в редактор, для выбора нужного шрифта отображения/печати документа, для инициации процесса печати и для завершения работы программы.
Листинг 1 unit unit1;
Code: Interface. Uses. Windows, messages, sysutils, classes, graphics, controls, forms, dialogs, stdctrls, buttons; Type. Tform1 = class(tform). Memo1: tmemo; Button1: tbutton; Button2: tbutton; Opendialog1: topendialog; Bitbtn1: tbitbtn; Button3: tbutton; Fontdialog1: tfontdialog; Procedure button1click(sender: tobject); Procedure button2click(sender: tobject); Procedure button3click(sender: tobject); Private. { private declarations }. Public. { public declarations }. End; Var. Form1: tform1; Implementation. Uses printers; // Эта ссылка обязательна! {$r *.dfm}. Procedure tform1.button1click(sender: tobject); // Выбор файла с текстом и его загрузка в редактор. Begin. If opendialog1.execute then. Memo1.lines.loadfromfile(opendialog1.filename). End; Procedure tform1.button3click(sender: tobject); // Выбор шрифта и связывание его с memo1. Begin. If fontdialog1.execute then. Memo1.font := fontdialog1.font. End; Procedure tform1.button2click(sender: tobject); // Печать содержимого редактора как вывод в текстовый файл. Var. Prn: textfile; K: integer; Begin. Assignprn(prn); // Переназначаем вывод в файл на вывод в принтер. Rewrite(prn); // Готовим принтер к печати (аналог begindoc). { Для печати используем такой же шрифт, как и для показа. В редакторе: }. Printer.canvas.font := memo1.font; // Цикл печати: For k := 0 to memo1.lines.count-1 do. Writeln(prn, memo1.lines[k]); Closefile(prn); // Аналог enddoc. End; End.
| Печать изображения |
Code: { Печать изображения. Использует модуль Printers. Должно работать со всеми типами графики: битмепами, метафайлами и иконками. (c) Alexey Torgashin, 2007. Последняя версия функции всегда доступна в исходниках компонента ATViewer: Http://atorg.net.ru/delphi/atviewer.htm. Параметры: - AImage: TImage объект. - ACopies: число копий (можно задать 0 для одной копии). - AFitToPage: умещать картинку в страницу принтера. Если картинка меньше. Страницы и AFitOnlyLarger=False, то картинка будет растянута. - AFitOnlyLarger: разрешает умещать только картинки, бОльшие размера страницы. - ACenter: центрировать картинку по странице. - APixelsPerInch: число точек на дюйм на экране. Передавайте сюда значение. Св-ва PixelsPerInch Вашей формы или объекта Screen. - ACaption: заголовок задания печати в Print Manager. ----------------------------------- Image printing. Uses Printers unit. Should work with all graphics: bitmaps, metafiles and icons. Parameters: - AImage: TImage object. - ACopies: number of copies (you may set 0 for a single copy). - AFitToPage: fit image to a printer page. If image is smaller than a page and. AFitOnlyLarger=False then image will be stretched up to a page. - AFitOnlyLarger: allows to stretch images smaller than a page. - ACenter: center image on a page. - APixelsPerInch: pass here value of PixelsPerInch property of your form or. Of a Screen object (Screen.PixelsPerInch). - ACaption: print job caption in Print Manager. } Function ImagePrint( AImage: TImage; ACopies: word; AFitToPage, AFitOnlyLarger, ACenter: boolean; APixelsPerInch: integer; Const ACaption: string): boolean; Var. Bmp: TBitmap; Begin. Bmp:= TBitmap.Create; Try. Bmp.PixelFormat:= pf24bit; {$ifdef ADV_IMAGE_CONV}. If not CorrectImageToBitmap(AImage, bmp, clWhite) then. Begin. Result:= false; Exit. End; {$else}. With AImage.Picture do. Begin. Bmp.Width:= Graphic.Width; Bmp.Height:= Graphic.Height; Bmp.Canvas.Draw(0, 0, Graphic); End; {$endif}. Result:= BitmapPrint( //Declared below. Bmp, ACopies, AFitToPage, AFitOnlyLarger, ACenter, APixelsPerInch, ACaption); Finally. Bmp.Free; End; End; Function BitmapPrint( ABitmap: TBitmap; ACopies: word; AFitToPage, AFitOnlyLarger, ACenter: boolean; APixelsPerInch: integer; Const ACaption: string): boolean; Var. Scale, ScalePX, ScalePY, ScaleX, ScaleY: Double; SizeX, SizeY, RectSizeX, RectSizeY, RectOffsetX, RectOffsetY: integer; I: integer; Begin. Result:= true; Assert( Assigned(ABitmap) and (ABitmap.Width>0) and (ABitmap.Height>0), 'BitmapPrint: bitmap is empty.'); If ACopies = 0 then. Inc(ACopies); With Printer do. Begin. SizeX:= PageWidth; SizeY:= PageHeight; ScalePX:= GetDeviceCaps(Handle, LOGPIXELSX) / APixelsPerInch; ScalePY:= GetDeviceCaps(Handle, LOGPIXELSY) / APixelsPerInch; ScaleX:= SizeX / ABitmap.Width / ScalePX; ScaleY:= SizeY / ABitmap.Height / ScalePY; If ScaleX < ScaleY then. Scale:= ScaleX. Else. Scale:= ScaleY; If (not AFitToPage) or (AFitOnlyLarger and (Scale > 1.0)) then. Scale:= 1.0; RectSizeX:= Trunc(ABitmap.Width * Scale * ScalePX); RectSizeY:= Trunc(ABitmap.Height * Scale * ScalePY); If ACenter then. Begin. RectOffsetX:= (SizeX - RectSizeX) div 2; RectOffsetY:= (SizeY - RectSizeY) div 2; End. Else. Begin. RectOffsetX:= 0; RectOffsetY:= 0; End; Title:= ACaption; Try. BeginDoc; Try. For i:= 1 to ACopies do. Begin. Canvas.StretchDraw( Rect( RectOffsetX, RectOffsetY, RectOffsetX + RectSizeX, RectOffsetY + RectSizeY), ABitmap. ); If i < ACopies then. NewPage; End; Finally. EndDoc; End; Except. Result:= false; End; End; End;
| Первый CORBA сервер |
Code: Unit uMyFirstCorbaServer; Interface. Uses. Windows, Messages, SysUtils, Classes, Graphics, Controls, ComObj, StdVcl, CorbaObj, FirstCorbaServer_TLB; Type. TMyFirstCorbaServer = class(TCorbaImplementation, IMyFirstCorbaServer). Private. { Private declarations }. Public. { Public declarations }. Protected. Procedure SayHelloWorld; safecall; End; Implementation. Uses CorbInit; Procedure TMyFirstCorbaServer.SayHelloWorld; Begin. End; Initialization. TCorbaObjectFactory.Create('MyFirstCorbaServerFactory', 'MyFirstCorbaServer', 'IDL:FirstCorbaServer/MyFirstCorbaServerFactory:1.0', IMyFirstCorbaServer, TMyFirstCorbaServer, iMultiInstance, tmSingleThread); End.
Назад в будущее.
| Назад в будущее |
15. Назад в будущее.
ВВЕДЕНИЕ.
Могло ли действительно пройти четыре года с тех пор, как я написал четырнадцатую главу этой серии? Действительно ли возможно, что шесть долгих лет прошли с тех пор как я начал ее? Забавно, как летит время когда вы весело его проводите, не так ли?
Я не буду тратить много времени на извинения; просто подчеркну, что это случилось, и приоритеты меняются. За четыре года, начиная с четырнадцатой главы, я сумел стать уволенным, развестись, получить нервный срыв, начал новую карьеру как писатель, начал другую как консультант, двигался, работал на две системы реального времени и вырастил четырнадцать птенцов, трех голубей, шесть опоссумов и утку. Некоторое время синтаксический анализ исходного кода был не слишком высоко в моем списке приоритетов. Не написал ни одной вещи бесплатно, только за деньги. Но я пытаюсь быть верным и понимаю и чувствую свою ответственность перед вами, читателями, закончить то, что начал. Как сказала черепаха в одной из старых историй моего сына, я возможно медленная, но я надежная. Я уверен, что есть люди, стремящиеся увидеть последнюю катушку этого фильма, и я собираюсь дать им ее. Так что, если вы один из тех, кто ждал более или менее терпеливо, что из этого получится, благодарю за ваше терпение. Я приношу извинения за задержку. Давайте продолжим.
НОВОЕ НАЧАЛО, СТАРОЕ НАПРАВЛЕНИЕ.
Подобно многим другим вещам, языки программирования и стили программирования изменяются со временем. В 1994 году кажется немного анахроничным программировать на Turbo Pascal, когда остальной мир кажется сходит с ума по C++. Также кажется немного странным программировать в классическом стиле, когда остальной мир переключился на объектно-ориентированные методы. Однако, несмотря на четырехлетнюю паузу, было бы слишком тяжело сейчас переключиться, скажем, на C++ с объектной ориентацией. Во всяком случае, Pascal все еще не только мощный язык программирования (фактически больше, чем когда либо), но это и замечательная среда для обучения. Си - известно трудный для чтения язык... он часто был обвиняем, наряду с Forth, как "язык только для записи". Когда я программирую на C++ я трачу по крайней мере 50% своего времени на борьбу с синтаксисом языка а не с концепциями. Сбивающие с толку "&" или "*" могут не только изменить функционирование программы, но также и ее правильность. Наоборот, код Паскаля обычно совершенно ясен и прост для чтения даже если вы не знаете языка. Что вы видите, то вы почти всегда и получите, и мы можем сконцентрироваться на концепциях, а не тонкостях реализации. Я сказал в начале, что целью этой обучающей серии была не генерация самого быстрого в мире компилятора, а изучение основ технологии компиляции, с наименьшими затратами времени на борьбу с синтаксисом языка или другими аспектами реализации программного обеспечения. Наконец, так как многое из того, что мы делаем в этом курсе, составляет программное экспериментирование, важно иметь компилятор и связанную с ним среду, который компилирует быстро и без суеты. По моему мнению наиболее значимым мерилом времени при разработке программного обеспечения является скорость цикла редактирование/компиляция/тестирование. В этом отделе Turbo Pascal - король. Скорость компиляции блестяще быстрая, и продолжает становиться быстрее с каждым выпуском (как им это удается?). Несмотря на крупные усовершенствования в быстродействии компиляции C за последние годы, даже Borland-овский самый быстрый компилятор C/C++ все еще не сравним с Turbo Pascal. Далее, редактор, встроенный в его IDE, средство make, и даже их превосходный умный компоновщик, все дополняют друг друга чтобы получить замечательную среду для быстрой разработки. По всем этим причинам, я собираюсь придерживаться Паскаля в продолжение этой серии. Мы будем использовать Turbo Pascal for Windows, один из компиляторов, предоставляемый Borland Pascal with Objects, версия 7.0. Если у вас нет этого компилятора не волнуйтесь... ничего из того, что мы делаем здесь не будет рассчитано на то, что вы имеете последнюю версию. Использование Windows версии сильно помогает мне, позволяя использовать Clipboard для копирования кода из редактора компилятора в эти документы. Она также должна помочь вам по крайней мере копировать код в обратном направлении.
Я думал долго и трудно о том, надо ли представить нашему обсуждению объекты. Я большой защитник объектно-ориентированных методов для всех применений и такие методы определенно имеют свое место в технологии компиляции. Фактически, я написал несколько статей только на эти темы (ссылки 1-3). Но архитектура компилятора, основанного на объектно-ориентированных подходах, значительно отличается от архитектуры более классического компилятора, который мы строим. Кроме того, коней на переправе не меняют. Как я сказал, изменяются стили программирования. Кто знает, может быть пройдут еще шесть лет прежде чем мы закончим эти дела, и если мы будем изменять код каждый раз при изменении стиля программирования мы можем никогда не закончить.
Так что теперь, по крайней мере, я определился продолжать классический стиль в Pascal, хотя мы действительно могли бы обсуждать объекты и объектную ориентацию по ходу дела. Аналогично, целевой машиной останется семейство Motorola 68000. Из всех решений, которые буду приняты здесь, это было самым простым. Хотя я знаю, что многие из вас хотели бы видеть код для 80x86, 68000 является, вообще-то, даже более популярным как платформа для встроенных систем, и это то применение ради которого это все изначально и начиналось. Компилируя для PC, платформы MSDOS, мы должны были бы иметь дело со всеми проблемами системных вызовов DOS, форматов компоновщика DOS, файловой системы PC и аппаратными средствами и всеми другие осложнениями среды DOS. Встроенная система, с другой стороны, должна выполняться автономно и я всегда представлял, что для такого вида применений, как альтернатива ассемблеру, язык подобный KISS процветал бы. В любом случае, кто хочет иметь дело с архитектурой 80x86 если они не должны?
Одна из возможностей Turbo Pascal которую я собираюсь серьезно использовать это модули. В прошлом мы должны были делать компромиссы между размером кода, сложностью и функциональными возможностями программы. Многое из нашей работы было по природе компьютерным экспериментированием, рассматриванием только одного аспекта технологии компиляции в один момент времени. Мы делали это чтобы избежать возни с большими программами, исследуя только простые понятия. В процессе, мы заново изобретали колесо и заново программировали те же самые функции больше раз, чем я могу сосчитать. Модули Turbo предоставляют замечательный способ получить функциональность и простоту одновременно: вы пишете многократно используемый код и вызываете его в одной строке. Ваша тестовая программа остается маленькой, но она может делать мощные вещи.
Одна из возможностей модулей Turbo Pascal - их блок инициализации. Как в пакете Ada, любой код в основном блоке begin-end модуля выполняется когда программа инициализирована. Как вы увидите позже, это иногда дает нам хорошее упрощение кода. Наша процедура Init, которая была с нами начиная с Главы 1, полностью исчезает когда мы используем модули. Различные подпрограммы в Cradle, другие ключевые возможности нашего подхода, будут распределены по модулям.
Концепция модулей, конечно, ничем не отличается от модулей Си. Однако в C (и C++) интерфейс между модулями происходит через операторы include препроцессора и заголовочные файлы. Как кто-то, кто читал множество программ других людей на C, я всегда находил это довольно сбивающим с толку. Всегда кажется, что любая структура данных, о который вы бы хотели знать, находится в каком-то другом файле. Модули Turbo проще по той причине, за которую они критикуются некоторыми: интерфейсы функций и их реализации включены в тот же самый файл. В то время, когда эта организация может создать проблемы с защитой кода, она также уменьшает количество файлов наполовину, что не в два раза хуже. Связывание объектных файлов также просто, потому что компилятор Turbo заботится об этом без необходимости в файлах типа make или других механизмах.
НАЧИНАЕМ ЗАНОВО?
Четыре года назад, в Главе 14, я обещал вам, что наши дни повторного изобретения колеса и написания одних и тех же программ на каждом уроке, прошли и что с этого момента мы будем придерживаться более завершенных программ, к которым мы должны просто добавлять новые возможности. Я все еще собираюсь сдержать это обещание; это одна из основных целей использования модулей. Однако, из-за прошествия длительного времени с главы 14, естественно хотелось бы сделать по крайней мере небольшой обзор и в любом случае мы окажемся перед необходимостью сделать довольно обширные изменения кода, чтобы выполнить переход к модулям. Кроме того, если откровенно, после всего этого времени я не могу помнить всех хороших идей, которые я имел в моей голове четыре года назад. Для меня лучший способ вспомнить их - заново пройти некоторые шаги, которые привели нас к Главе 14. Так что я надеюсь, что вы поймете и смиритесь со мной когда мы возвратимся к своим корням, в некотором смысле, и перестроим ядро программы, распределяя подпрограммы по различным модулям, и вытащим сами себя назад к точке где мы были многие луны тому назад. Как всегда бывало, вы увидите все мои ошибки и смены направлений в реальном режиме времени. Пожалуйста, будьте терпеливы... мы доберемся до новых вещей раньше чем вы успеете оглянуться.
Так как в нашем новом подходе мы собираемся использовать множественные модули, мы должны обратиться к проблеме управления файлами. Если вы проследовали через все другие разделы этой обучающей серии, вы знаете, что поскольку наша программа развивается, мы заменяем старые, более простые модули на более совершенные. Это приводит нас к проблеме контроля версий. Почти обязательно будут возникать ситуации, когда мы будем перекрывать простой файл (модуль), но позднее захотим иметь его снова. Данный случай воплощен в нашей склонности к использованию одно-символьных имен переменных, ключевых слов и т.д. для проверки основных понятий не захлебываясь в деталях лексического анализатора. Благодаря использованию модулей мы будем намного меньше делать это в будущем. Однако, я не только предполагаю, но я уверен, что мы будем должны сохранять некоторые старые версии файлов для специальных целей, даже при том, что они заменяются более новыми, более совершенными.
Для решения этой проблемы я предлагаю, чтобы вы создали различные каталоги с различными версиями модулей. Если мы сделаем это правильно, код в каждом каталоге останется само непротиворечивым. Я в порядке эксперимента создал четыре каталога: SINGLE (для одно-символьных экспериментов), MULTI (для, конечно, много символьной версии), TINY и KISS.
Достаточно сказано о философии и деталях. Давайте продолжим восстановление программы.
МОДУЛЬ INPUT.
Ключевой концепцией, которую мы использовали начиная с первого дня, была идея входного потока с одним предсказывающим символом. Все подпрограммы синтаксического анализа проверяют этот символ, не изменяя его, чтобы решить, что они должны делать дальше. (Сравните этот подход с подходом C/Unix, использующим getchar и unget, и я думаю вы согласитесь, что наш подход проще). Мы начнем нашу экскурсию в будущее перенеся эту концепцию в нашу новую модульную организацию. Первый модуль, соответствующее названный Input, показан ниже:
Code: Unit Input; Interface. Var Look: char; { Lookahead character }. Procedure GetChar; { Read new character }. Implementation. { Read New Character From Input Stream }. Procedure GetChar; Begin. Read(Look); End; { Unit Initialization }. Begin. GetChar; End.
Как вы можете видеть, здесь нет ничего очень заумного и конечно ничего сложного, так как он состоит только из одной процедуры. Но мы уже можем видеть как использование модулей дает нам преимущества. Обратите внимание на выполнимый код в блоке инициализации. Этот код "запускает помпу" входного потока для нас, нечто такое мы всегда делали раньше вставляя вызовы GetChar в процедуру Init. На этот раз вызов происходит без каких-либо специальных обращений к ней с нашей стороны, за исключением самого модуля. Как я предсказывал ранее, этот механизм сделает нашу жизнь в будущем значительно проще. Я полагаю это одна из наиболее полезных возможностей Turbo Pascal и я буду сильно на нее полагаться.
Скопируйте этот модуль в IDE вашего компилятора и откомпилируйте его. Чтобы проверить программу, конечно, нам всегда нужна основная программа. Я использовал следующую, действительно сложную тестовую программу, которую позже мы разовьем в главную для нашего компилятора:
Code: Program Main; Uses WinCRT, Input; Begin. WriteLn(Look); End.
Обратите внимание на использование предоставляемого Borland модуля WinCRT. Этот модуль необходим, если вы предполагаете использовать стандартные подпрограммы ввода/вывода Паскаля Read, ReadLn, Write и WriteLn, которые мы конечно предполагаем использовать. Если вы забудете включить этот модуль в раздел "uses" вы получите действительно причудливое и непонятное сообщение во время выполнения.
Заметьте также, что мы можем обращаться к предсказывающему символу даже при том, что он не объявлен в основной программе. Все переменные, объявленные в разделе interface модуля, являются глобальными, но они скрыты от любопытных глаз; в какой-то степени мы получаем чуточку сокрытия информации. Конечно, если бы мы писали в объектно-ориентированном стиле, мы не должны были бы позволять обращаться к внутренним переменным модуля снаружи. Но хотя модули Turbo имеют много общего с объектами, мы не собираемся здесь реализовывать объектно-ориентированный дизайн или код, так что мы используем Look соответствующее.
Продолжим и сохраним тестовую программу как Main.pas. Чтобы сделать жизнь проще когда файлов будет становиться все больше и больше, вам возможно захотелось бы использовать возможность объявить этот файл как Primary файл компилятора. Таким способом вы можете выполнять программу из любого файла. Иначе, если вы нажмете Cntl-F9 для компиляции и выполнения одного из модулей, вы получите сообщение об ошибке. Вы устанавливаете primary-файл используя главное подменю "Compile" в Turbo IDE.
Я тороплюсь отметить, как я делал раньше, что функционально модуль Input является, и всегда был, макетом настоящей версии. В серийной версии компилятора входной поток будет, конечно, скорее исходить из файла, а не клавиатуры. И это почти обязательно включает буферизацию строки, по крайней мере, и более вероятно, довольно большой текстовый буфер для поддержки эффективного дискового ввода/вывода. Хорошая сторона модулей в том, что как и с объектами, мы можем делать код модуля таким простым или таким сложным как нам угодно. До тех пор, пока интерфейс, встроенный в общедоступные процедуры и предсказывающий символ не изменяются, остальная часть программы абсолютно не затрагивается. И так как модули компилируются, а не просто включаются, время необходимое для связывания их вместе практически равно нулю. Снова, результат таков, что мы можем получить все преимущества сложной реализации без необходимости возиться с кодом как лишним багажом.
В следующих главах я предполагаю предоставить полноценный IDE для компилятора KISS используя настоящее Windows приложение, сгенерированное с помощью среды разработки Borland OWL. Сейчас, тем не менее, мы удовлетворим мое первое правило: Делать Это Проще.
МОДУЛЬ OUTPUT.
Конечно, каждая приличная программа должна выводить результат и наша не исключение. Наши подпрограммы вывода включают функции Emit. Код для соответствующего модуля показан дальше:
Code: Unit Output; Interface. Procedure Emit(s: string); { Emit an instruction }. Procedure EmitLn(s: string); { Emit an instruction line }. Implementation. Const TAB = ^I; { Emit an Instruction }. Procedure Emit(s: string); Begin. Write(TAB, s); End; { Emit an Instruction, Followed By a Newline }. Procedure EmitLn(s: string); Begin. Emit(s); WriteLn; End; End.
(Заметьте, что этот модуль не имеет раздела инициализации, так что он не требует блока begin.).
Проверьте этот модуль с помощью следующей основной программы:
Code: Program Test; Uses WinCRT, Input, Output, Scanner, Parser; Begin. WriteLn('MAIN:'); EmitLn('Hello, world!'); End.
Увидели ли вы что-либо, что удивило вас? Вы возможно были удивлены видеть, что вам было необходимо что-то набрать даже хотя основная программа не требует никакого ввода. Дело в разделе инициализации модуля Input, который все еще требует поместить что-либо в предсказывающий символ. Жаль, нет никакого способа выйти из этого, или скорее, мы не хотим выходить. За исключением простых тестовых случаев, как этот, нам всегда будет необходим допустимый предсказывающий символ, так что самое лучшее, что мы можем сделать с этой "проблемой" это... ничего.
Возможно более удивительно то что символ TAB не имеет никакого эффекта; наша строка "инструкций" начинается с первой колонки, так же как и фальшивая метка... Правильно: WinCRT не поддерживает табуляцию. У нас проблема.
Есть несколько способов, с помощью которых мы можем решить эту проблему. Один из вариантов того что мы можем сделать - просто игнорировать ее. Каждый ассемблер, который я когда либо использовал, резервируют колонку 1 для меток и взбунтуется когда увидит, что в ней начинаются инструкции. Так что, по крайней мере, мы должны сдвинуть инструкции на одну колонку чтобы сделать ассемблер счастливым. Это достаточно просто сделать: просто измените в процедуре Emit строку:
Write(TAB, s);
На.
Write(' ', s);
Я должен признать что сталкивался с этой проблемой раньше и находил себя меняющим свое мнение так часто как хамелеон меняет цвет. Для наших целей, 99% которых будет проверка выходного кода при выводе на CRT, было бы хорошо видеть аккуратно сгруппированный "объектный" код. Строка:
SUB1: MOVE #4,D0.
Просто выглядит более опрятно, чем отличающийся, но функционально идентичный код:
SUB1:
MOVE #4,D0.
В тестовой версии моего кода я включил более сложную версию процедуры PostLabel, которая позволяет избежать размещения меток на раздельных строках, задерживая печать метки чтобы она оказалась на той же самой строке, что и связанная инструкция. Не позднее чем час назад, моя версия модуля Output предоставляла полную поддержку табуляции с использованием внутренней переменной счетчика столбцов и подпрограммы для ее управления. Я имел некоторый довольно изящный код для поддержки механизма табуляции с минимальным увеличением кода. Было ужасное искушение показать вам эту "красивую" версию, единственно чтобы покрасоваться элегантностью.
Однако, код "элегантной" версии был значительно более сложным и большим. После этого у меня появилась вторая мысль. Несмотря на наше желание видеть красивый вывод, неизбежный факт то, что две версии MAIN: фрагменты кода, показанные выше функционально идентичны; ассемблер, который является конечной целью кода, не интересует какую версию он получает, за исключением того, что красивая версия будет содержать больше символов, следовательно будет использовать больше дискового пространства и дольше ассемблироваться. Но красивая версия не только генерирует больше кода, но дает больший выходной файл, с гораздо большим количество пустых символов чем минимально необходимо. Когда вы посмотрите на это с такой стороны, то не трудно будет решить какой подход использовать, не так ли?
То что наконец решило для меня этот вопрос было напоминанием считаться с моей первой заповедью: KISS. Хотя я был довольно горд всеми своими изящными приемчиками для реализации табуляции, я напомнил себе, что перефразируя сенатора Барри Голдватера, элегантность в поисках сложности не является достоинством. Другой мудрый человек однажды написал: "Любой идиот может разработать Роллс-Ройс. Требуется гений, чтобы разработать VW". Так что изящная, дружественная табуляции версия Output в прошлом, и то, что вы видите, это простая компактная VW версия.
МОДУЛЬ ERROR.
Наш следующий набор подпрограмм обрабатывает ошибки. Чтобы освежить вашу память мы возьмем подход, заданный Borland в Turbo Pascal - останавливаться на первой ошибке. Это не только значительно упрощает наш код, полностью устраняя назойливую проблему восстановления после ошибок, но это также имеет намного больший смысл, по моему мнению, в интерактивной среде. Я знаю, что это может быть крайней позицией, но я считаю практику сообщать обо всех ошибках в программе анахронизмом, пережитком со времен пакетной обработки. Пришло время прекратить такую практику. Так вот.
В нашем оригинальном Cradle мы имели две процедуры обработки ошибок: Error, которая не останавливалась, и Abort, которая останавливалась. Но я не думаю, что мы когда-либо найдем применение процедуре, которая не останавливается, так что в новом, тощем и скромном модуле Errors, показанном ниже, процедура Error занимает место Abort.
Code: Unit Errors; Interface. Procedure Error(s: string); Procedure Expected(s: string); Implementation. { Write error Message and Halt }. Procedure Error(s: string); Begin. WriteLn; WriteLn(^G, 'Error: ', s, '.'); Halt; End; { Write "<something> Expected" }. Procedure Expected(s: string); Begin. Error(s + ' Expected'); End; End. Как обычно, вот программа для проверки: Program Test; Uses WinCRT, Input, Output, Errors; Begin. Expected('Integer'); End.
Вы заметили, что строка "uses" в нашей основной программе становится длиннее? Это нормально. В конечной версии основная программа будет вызывать процедуры только из нашего синтаксического анализатора, так что раздел uses будет иметь только пару записей. Но сейчас возможно самое лучшее включить все модули, чтобы мы могли протестировать процедуры в них.
ЛЕКСИЧЕСКИЙ И СИНТАКСИЧЕСКИЙ АНАЛИЗ.
Классическая архитектура компилятора основана на отдельных модулях для лексического анализатора, который предоставляет лексемы языка, и синтаксического анализатора, который пытается определить смысл токенов как синтаксических элементов. Если вы еще не забыли что мы делали в более ранних главах, вы вспомните, что мы не делали ничего подобного. Поскольку мы используем предсказывающий синтаксический анализатор, мы можем почти всегда сказать, какой элемент языка следует дальше, всего лишь исследуя предсказывающий символ. Следовательно, нам не нужно предварительно выбирать токен, как делал бы сканер.
Но даже хотя здесь и нет функциональной процедуры, названной "Scanner", все еще имеет смысл отделить функции лексического анализа от функций синтаксического анализа. Так что я создал еще два модуля, названных, достаточно удивительно, Scanner и Parser. Модуль Scanner содержит все подпрограммы, известные как распознаватели. Некоторые из них, такие как IsAlpha, являются чисто булевыми подпрограммами, которые оперируют только предсказывающим символом. Другие подпрограммы собирают токены, такие как идентификаторы и числовые константы. Модуль Parser будет содержать все подпрограммы, составляющие синтаксический анализатор с рекурсивным спуском. Общим правилом должно быть то, что модуль Parser содержит всю специфическую для языка информацию; другими словами, синтаксис языка должен полностью содержаться в Parser. В идеальном мире это правило должно быть верным в той степени, что мы можем изменять компилятор для компиляции различных языков просто заменяя единственный модуль Parser.
На практике, дела почти никогда не бывают такими чистыми. Все есть небольшая "утечка" синтаксических правил также и в сканер. К примеру, правила составления допустимого идентификатора или константы могут меняться от языка к языку. В некоторых языках правила о комментариях разрешают им быть отфильтрованными в сканере, в то время как другие не разрешают. Так что на практике оба модуля вероятно придут к тому, что будут иметь языко зависимые компоненты, но изменения, необходимые для сканнера, должны быть относительно тривиальными.
Теперь вспомните, что мы использовали две версии подпрограмм лексического анализатора: одна, которая поддерживала только одно-символьные токены, которую мы использовали в ряде наших тестов, и другая, которая предоставляет полную поддержку много символьных токенов. Теперь, когда мы разделяем нашу программу на модули, я не ожидаю многого от использования одно-символьной версии, но не потребуется многого, чтобы предусмотреть их обе. Я создал две версии модуля Scanner. Первая, названная Scanner1, содержит одно-символьную версию подпрограмм распознавания:
Code: Unit Scanner1; Interface. Uses Input, Errors; Function IsAlpha(c: char): boolean; Function IsDigit(c: char): boolean; Function IsAlNum(c: char): boolean; Function IsAddop(c: char): boolean; Function IsMulop(c: char): boolean; Procedure Match(x: char); Function GetName: char; Function GetNumber: char; Implementation. { Recognize an Alpha Character }. Function IsAlpha(c: char): boolean; Begin. IsAlpha := UpCase(c) in ['A'..'Z']; End; { Recognize a Numeric Character }. Function IsDigit(c: char): boolean; Begin. IsDigit := c in ['0'..'9']; End; { Recognize an Alphanumeric Character }. Function IsAlnum(c: char): boolean; Begin. IsAlnum := IsAlpha(c) or IsDigit(c); End; { Recognize an Addition Operator }. Function IsAddop(c: char): boolean; Begin. IsAddop := c in ['+','-']; End; { Recognize a Multiplication Operator }. Function IsMulop(c: char): boolean; Begin. IsMulop := c in ['*','/']; End; { Match One Character }. Procedure Match(x: char); Begin. If Look = x then GetChar. Else Expected('''' + x + ''''); End; { Get an Identifier }. Function GetName: char; Begin. If not IsAlpha(Look) then Expected('Name'); GetName := UpCase(Look); GetChar; End; { Get a Number }. Function GetNumber: char; Begin. If not IsDigit(Look) then Expected('Integer'); GetNumber := Look; GetChar; End; End.
Следующий фрагмент кода основной программы обеспечивает хорошую проверку лексического анализатора. Для краткости я включил здесь только выполнимый код; остальное тоже самое. Не забудьте, тем не менее, добавить имя Scanner1 в раздел "uses":
Write(GetName);
Match('=');
Write(GetNumber);
Match('+');
WriteLn(GetName);
Этот код распознает все предложения вида:
X=0+y.
Где x и y могут быть любыми одно-символьными именами переменных и 0 любой цифрой. Код должен отбросить все другие предложения и выдать осмысленное сообщение об ошибке. Если это произошло, тогда вы в хорошей форме и мы можем продолжать.
МОДУЛЬ SCANNER.
Следующая, и намного более важная, версия лексического анализатора, та которая обрабатывает много символьные токены, которые должны иметь все настоящие языки. Только две функции, GetName и GetNumber отличаются в этих двух модулях, но только чтобы убедиться, что здесь нет никаких ошибок, я воспроизвел здесь весь модуль. Это модуль Scanner:
Code: Unit Scanner; Interface. Uses Input, Errors; Function IsAlpha(c: char): boolean; Function IsDigit(c: char): boolean; Function IsAlNum(c: char): boolean; Function IsAddop(c: char): boolean; Function IsMulop(c: char): boolean; Procedure Match(x: char); Function GetName: string; Function GetNumber: longint; Implementation. { Recognize an Alpha Character }. Function IsAlpha(c: char): boolean; Begin. IsAlpha := UpCase(c) in ['A'..'Z']; End; { Recognize a Numeric Character }. Function IsDigit(c: char): boolean; Begin. IsDigit := c in ['0'..'9']; End; { Recognize an Alphanumeric Character }. Function IsAlnum(c: char): boolean; Begin. IsAlnum := IsAlpha(c) or IsDigit(c); End; { Recognize an Addition Operator }. Function IsAddop(c: char): boolean; Begin. IsAddop := c in ['+','-']; End; { Recognize a Multiplication Operator }. Function IsMulop(c: char): boolean; Begin. IsMulop := c in ['*','/']; End; { Match One Character }. Procedure Match(x: char); Begin. If Look = x then GetChar. Else Expected('''' + x + ''''); End; { Get an Identifier }. Function GetName: string; Var n: string; Begin. N := ''; If not IsAlpha(Look) then Expected('Name'); While IsAlnum(Look) do begin. N := n + Look; GetChar; End; GetName := n; End; { Get a Number }. Function GetNumber: string; Var n: string; Begin. N := ''; If not IsDigit(Look) then Expected('Integer'); While IsDigit(Look) do begin. N := n + Look; GetChar; End; GetNumber := n; End; End.
Та же самая тестовая программа проверит также и этот сканер. Просто измените раздел "uses" для использования Scanner вместо Scanner1. Теперь у вас должна быть возможность набирать много символьные имена и числа.
РЕШЕНИЯ, РЕШЕНИЯ.
Несмотря на относительную простоту обоих сканеров, много идей вошло в них и много решений было сделано. Я хотел бы поделиться этими мыслями с вами сейчас чтобы вы могли принимать свои собственные решения, соответствующие вашему приложению. Сначала заметьте, что обе версии GetName переводят входные символы в верхний регистр. Очевидно, здесь было принято проектное решение, и это один из тех случаев, когда синтаксис языка распределяется по лексическому анализатору. В языке Си регистр символов имеет значение. Для такого языка мы, очевидно, не сможем преобразовывать символы в верхний регистр. Дизайн, который я использую, предполагает язык, подобный Pascal, в котором регистр символов не имеет значения. Для таких языков проще идти вперед и преобразовывать все идентификаторы в верхний регистр в лексическом анализаторе, так что мы не должны волноваться позднее, когда вы сравниваем строки.
Мы могли бы даже пойти дальше и преобразовывать символы в верхний регистр прямо когда они заходят, в GetChar. Этот метод также работает, и я использовал его в прошлом, но он слишком ограничивающий. В частности, он также преобразует символы, которые могут быть частью строк в кавычках, что не является хорошей идеей. Так что если вы вообще собираетесь преобразовывать символы в верхний регистр, GetName подходящее место сделать это.
Обратите внимание, что функция GetNumber в этом сканере возвращает строку, так же как и GetName. Это одна из тех вещей, относительно которых я колебался почти что ежедневно, и последнее колебание было всего десять минут назад. Альтернативный подход и подход, который я использовал много раз в прошлых главах возвращает целочисленный результат.
Оба подхода имеют свои преимущества. Так как мы выбираем число, метод, который немедленно приходит на ум - возвращать его как целое число. Но имейте ввиду, что возможно число будет использоваться в операторе вывода который возвращает его во внешний мир. Кто-то, или мы или код, скрытый внутри оператора вывода, окажется перед необходимостью снова преобразовывать число обратно в строку. Turbo Pascal включает такие подпрограммы преобразования строк, но зачем использовать их если мы не должны? Зачем преобразовывать число из строковой в целочисленную форму только для того, чтобы конвертировать его обратно в генераторе кода, всего несколько операторов спустя?
Кроме того, как вы скоро увидите, нам будет необходимо временное место для хранения токена, который мы извлекли. Если мы обрабатываем числа в их строковой форме, мы можем сохранять значение и переменной и числа в той же самой строке. В противном случае мы должны создать вторую, целочисленную переменную.
С другой стороны, мы обнаружим, что обработка числа как строки фактически уничтожает любую возможность дальнейшей оптимизации. Когда мы доберемся до точки, где мы начнем заниматься генерацией кода, мы столкнемся со случаями, в которых мы выполняем вычисления с константами. Для таких случаев действительно глупо генерировать код, выполняющий арифметику с константами во время выполнения. Гораздо лучше позволить синтаксическому анализатору выполнять арифметику во время компиляции и просто кодировать результат. Чтобы сделать это нам необходимо сохранять константы как целые числа а не строки.
В конце концов обратно к строковому подходу меня склонило энергичное тестирование KISS, плюс напоминание самому себе, что мы тщательно избегаем проблем эффективности кода. Одна из вещей, которые заставляют нашу нехитрую схему синтаксического анализа работать, без сложностей "настоящего" компилятора, это то, что мы прямо сказали что мы не затрагиваем эффективность кода. Это дает нам массу свободы выполнять работу простейшим путем а не эффективнейшим, и эту свободу мы должны стремиться не потерять, не смотря на призывы к эффективности звучащие в наших ушах. В дополнение к тому, что я большой сторонник философии KISS я также защитник "ленивого программирования", что в этом контексте означает не программировать что-либо пока вы не нуждаетесь в этом. Как говорит П. Дж. Плоджер "никогда не откладывайте на завтра то, что вы можете отложить насовсем". Годами писался код, предоставлявший возможности, которые не были никогда использованы. Я научился этому сам на горьком опыте. Так что вывод таков: мы не будем конвертировать в целое число потому, что это нам не нужно.
Для тех из вас, что все еще думает, что нам может быть нужна целочисленная версия (и действительно она может нам понадобиться), вот она:
Code: { Get a Number (integer version) }. Function GetNumber: longint; Var. N: longint; Begin. N := 0; If not IsDigit(Look) then Expected('Integer'); While IsDigit(Look) do begin. N := 10 * n + (Ord(Look) - Ord('0')); GetChar; End; GetNumber := n; End;
Вы могли бы отложить ее, как я предполагаю, на черный день.
СИНТАКСИЧЕСКИЙ АНАЛИЗ.
К этому моменту мы распределили все подпрограммы, составляющие наш Cradle, в модули, которые мы можем вытаскивать когда они необходимы. Очевидно, они будут развиваться дальше когда мы снова продолжим процесс восстановления, но большая часть их содержимого и несомненно архитектура, которую они подразумевают, определена. Остается воплотить синтаксис языка в модуль синтаксического анализа. Мы не будем делать многого из этого в этой главе, но я хочу сделать немного просто чтобы оставить вас с хорошим чувством, что мы все еще знаем что делаем. Так что прежде, чем мы продолжим, давай сгенерируем синтаксический анализатор достаточный только для обработки одиночного показателя в выражении. В процессе мы также обнаружим, что по необходимости создали также модуль генератора кода.
Помните самую первую главу этой серии? Мы считывали целочисленное значение, скажем n, и генерировали код для его загрузки в регистр D0 через move:
MOVE #n,D0.
Немного погодя, мы повторили этот процесс для переменной,
MOVE X(PC),D0.
А затем для показателя, который может быть и константой и переменной. В память о прошлом, давайте повторим этот процесс Определите следующий новый модуль:
Code: Unit Parser; Interface. Uses Input, Scanner, Errors, CodeGen; Procedure Factor; Implementation. { Parse and Translate a Factor }. Procedure Factor; Begin. LoadConstant(GetNumber); End; End.
Как вы можете видеть, этот модуль вызывает процедуру LoadConstant, которая фактически выполняет вывод ассемблерного кода. Модуль также использует новый модуль CodeGen. Этот шаг представляет последнее главное изменение в нашей архитектуре с более ранних глав: перемещение машинно-зависимого кода в отдельный модуль. Если я дойду до конца, вне CodeGen не будет ни одной строчки кода, которая указывала бы на то, что мы нацелены на процессор 68000. И это то место, которое показывает, что моя цель достижима.
Для тех из вас, кто желает, чтобы я использовал архитектуру 80x86 (или любую другую) вместо 68000, вот мой ответ: просто замените CodeGen на подходящий для вашего ЦПУ.
Пока наш генератор кода содержит только одну процедуру. Вот этот модуль:
Code: Unit CodeGen; Interface. Uses Output; Procedure LoadConstant(n: string); Implementation. { Load the Primary Register with a Constant }. Procedure LoadConstant(n: string); Begin. EmitLn('MOVE #' + n + ',D0' ); End; End.
Скопируйте и откомпилируйте этот модуль и выполните следующую основную программу:
Code: Program Main; Uses WinCRT, Input, Output, Errors, Scanner, Parser; Begin. Factor; End.
Вот он, сгенерированный код, такой как мы и надеялись.
Теперь, я надеюсь, вы можете начать видеть преимущества модульной архитектуры нашего нового проекта. Здесь мы имеем основную программу длиной всего пять строк. Это все, что нам нужно видеть, если мы не захотим видеть больше. И пока все эти модули сидят здесь терпеливо ожидая когда смогут послужить нам. Наше преимущество в том, что мы имеем простой и короткий код, но мощных союзников. Что остается сделать, это расширить модули до уровня возможностей более ранних глав. Мы сделаем это в следующей главе, но прежде, чем я закончу, давайте закончим синтаксический анализ показателя только для того, чтобы убедить себя, что мы знаем как. Конечная версия CodeGen включает новую процедуру LoadVariable:
Code: Unit CodeGen; Interface. Uses Output; Procedure LoadConstant(n: string); Procedure LoadVariable(Name: string); Implementation. { Load the Primary Register with a Constant }. Procedure LoadConstant(n: string); Begin. EmitLn('MOVE #' + n + ',D0' ); End; { Load a Variable to the Primary Register }. Procedure LoadVariable(Name: string); Begin. EmitLn('MOVE ' + Name + '(PC),D0'); End; End.
Сам модуль Parser не изменяется, но мы имеем более сложную версию процедуры Factor:
Code: { Parse and Translate a Factor }. Procedure Factor; Begin. If IsDigit(Look) then. LoadConstant(GetNumber). Else if IsAlpha(Look)then. LoadVariable(GetName). Else. Error('Unrecognized character ' + Look); End;
Теперь, без изменений основной программы, вы должны обнаружить, что программа обрабатывает и переменный и постоянный показатель. К этому моменту наша архитектура почти завершена; у нас есть модули, выполняющие всю грязную работу и достаточно кода в синтаксическом анализаторе и генераторе кода, чтобы продемонстрировать что все работает. Остается расширить модули которые мы определили, в особенности синтаксический анализатор и генератор кода, для поддержки более сложных синтаксических элементов, которые составляют настоящий язык. Так как мы делали это много раз прежде в предыдущих главах, не должно занять у нас много времени вернуться назад к тому месту, где мы были до долгого перерыва. Мы продолжим этот процесс в Главе 16, которая скоро появится. Увидимся.
ССЫЛКИ.
1. Crenshaw, J.W., "Object-Oriented Design of Assemblers and Compilers," Proc. Software Development '91 Conference, Miller Freeman, San Francisco, CA, February 1991, pp. 143-155.
2. Crenshaw, J.W., "A Perfect Marriage," Computer Language, Volume 8, #6, June 1991, pp. 44-55.
3. Crenshaw, J.W., "Syntax-Driven Object-Oriented Design," Proc. 1991 Embedded Systems Conference, Miller Freeman, San Francisco, CA, September 1991, pp. 45-60.
| Название месяца --> номер месяца |
| Назначение палитры Bitmap. |
Если вы рисуете на TImage....
Во-первых, вам нужно использовать Image1.Picture.bitmap, а не Image.Canvas. Причина кроется в том, что Image1.Picture.Bitmap имеет палитру, в Timage нет. Затем палитру необходимо назначить. Вот пример:
Code: // Устанавливаем Width и Height перед использованием. // Image1.Picture c Bitmap Canvasvar. Bitmap: TBitmap; Begin. Bitmap:=TBitmap.Create; Bitmap.LoadfromFile({'Whatever.bmp'}); With Image2.Picture.bitmap do. Begin. Width:=Bitmap.Width; Height:=Bitmap.Height; Palette:=Bitmap.Palette; Canvas.draw(0,0,bitmap); Refresh; End; End;
Если вы рисуете на канве формы...
Code: Canvas.Draw(0,0,Bitmap); SelectPalette(Form1.Canvas.handle,Bitmap.Palette,True); RealizePalette(Form1.Canvas.Handle);
Назначение портов.
| Назначение портов |
Protocol / Port - Application protocol - System service name Protocol 47 - GRE - GRE (IP protocol 47) Routing and Remote Access Protocol 50 - ESP - IPsec ESP (IP protocol 50) Routing and Remote Access Protocol 51 - n/a AH IPsec AH (IP protocol 51) Routing and Remote Access TCP Port 7 - Echo Simple TCP/IP Services UDP Port 7 - Echo Simple TCP/IP Services TCP Port 9 - Discard Simple TCP/IP Services UDP Port 9 - Discard Simple TCP/IP Services TCP Port 13 - Daytime Simple TCP/IP Services UDP Port 13 - Daytime Simple TCP/IP Services TCP Port 17 - Quotd Simple TCP/IP Services UDP Port 17 - Quotd Simple TCP/IP Services TCP Port 19 - Chargen Simple TCP/IP Services UDP Port 19 - Chargen Simple TCP/IP Services TCP Port 20 - FTP default data FTP Publishing Service TCP Port 21 - FTP control FTP Publishing Service TCP Port 21 - FTP control Application Layer Gateway Service TCP Port 23 - Telnet Telnet TCP Port 25 - SMTP Simple Mail Transfer Protocol UDP Port 25 - SMTP Simple Mail Transfer Protocol TCP Port 25 - SMTP Exchange Server UDP Port 25 - SMTP Exchange Server TCP Port 42 - WINS Replication Windows Internet Name Service UDP Port 42 - WINS Replication Windows Internet Name Service TCP Port 53 - DNS DNS Server UDP Port 53 - DNS DNS Server TCP Port 53 - DNS Internet Connection Firewall/Internet Connection Sharing UDP Port 53 - DNS Internet Connection Firewall/Internet Connection Sharing UDP Port 67 - DHCP Server DHCP Server UDP Port 67 - DHCP Server Internet Connection Firewall/Internet Connection Sharing UDP Port 69 - TFTP Trivial FTP Daemon Service TCP Port 80 - HTTP Windows Media Services TCP Port 80 - HTTP World Wide Web Publishing Service TCP Port 80 - HTTP SharePoint Portal Server TCP Port 88 - Kerberos Kerberos Key Distribution Center UDP Port 88 - Kerberos Kerberos Key Distribution Center TCP Port 102 - X.400 Microsoft Exchange MTA Stacks TCP Port 110 - POP3 Microsoft POP3 Service TCP Port 110 - POP3 Exchange Server TCP Port 119 - NNTP Network News Transfer Protocol UDP Port 123 - NTP Windows Time UDP Port 123 - SNTP Windows Time TCP Port 135 - RPC Message Queuing TCP Port 135 - RPC Remote Procedure Call TCP Port 135 - RPC Exchange Server TCP Port 135 - RPC Certificate Services TCP Port 135 - RPC Cluster Service TCP Port 135 - RPC Distributed File System TCP Port 135 - RPC Distributed Link Tracking TCP Port 135 - RPC Distributed Transaction Coordinator TCP Port 135 - RPC Event Log TCP Port 135 - RPC Fax Service TCP Port 135 - RPC File Replication TCP Port 135 - RPC Local Security Authority TCP Port 135 - RPC Remote Storage Notification TCP Port 135 - RPC Remote Storage Server TCP Port 135 - RPC Systems Management Server 2.0 TCP Port 135 - RPC Terminal Services Licensing TCP Port 135 - RPC Terminal Services Session Directory UDP Port 137 - NetBIOS Name Resolution Computer Browser UDP Port 137 - NetBIOS Name Resolution Server UDP Port 137 - NetBIOS Name Resolution Windows Internet Name Service UDP Port 137 - NetBIOS Name Resolution Net Logon UDP Port 137 - NetBIOS Name Resolution Systems Management Server 2.0 UDP Port 138 - NetBIOS Datagram Service Computer Browser UDP Port 138 - NetBIOS Datagram Service Messenger UDP Port 138 - NetBIOS Datagram Service Server UDP Port 138 - NetBIOS Datagram Service Net Logon UDP Port 138 - NetBIOS Datagram Service Distributed File System UDP Port 138 - NetBIOS Datagram Service Systems Management Server 2.0 UDP Port 138 - NetBIOS Datagram Service License Logging Service TCP Port 139 - NetBIOS Session Service Computer Browser TCP Port 139 - NetBIOS Session Service Fax Service TCP Port 139 - NetBIOS Session Service Performance Logs and Alerts TCP Port 139 - NetBIOS Session Service Print Spooler TCP Port 139 - NetBIOS Session Service Server TCP Port 139 - NetBIOS Session Service Net Logon TCP Port 139 - NetBIOS Session Service Remote Procedure Call Locator TCP Port 139 - NetBIOS Session Service Distributed File System TCP Port 139 - NetBIOS Session Service Systems Management Server 2.0 TCP Port 139 - NetBIOS Session Service License Logging Service TCP Port 143 - IMAP Exchange Server UDP Port 161 - SNMP SNMP Service UDP Port 162 - SNMP Traps Outbound SNMP Trap Service TCP Port 389 - LDAP Server Local Security Authority UDP Port 389 - LDAP Server Local Security Authority TCP Port 389 - LDAP Server Distributed File System UDP Port 389 - LDAP Server Distributed File System TCP Port 443 - HTTPS HTTP SSL TCP Port 443 - HTTPS World Wide Web Publishing Service TCP Port 443 - HTTPS SharePoint Portal Server TCP Port 443 - RPC over HTTP Exchange Server 2003 TCP Port 445 - SMB Fax Service TCP Port 445 - SMB Print Spooler TCP Port 445 - SMB Server TCP Port 445 - SMB Remote Procedure Call Locator TCP Port 445 - SMB Distributed File System TCP Port 445 - SMB License Logging Service TCP Port 445 - SMB Net Logon TCP Port 464 - Kerberos Password V5 Net Logon UDP Port 500 - IPsec ISAKMP Local Security Authority TCP Port 515 - LPD TCP/IP Print Server TCP Port 548 - File Server for Macintosh File Server for Macintosh TCP Port 554 - RTSP Windows Media Services TCP Port 563 - NNTP over SSL Network News Transfer Protocol TCP Port 593 - RPC over HTTP endpoint mapper Remote Procedure Call TCP Port 593 - RPC over HTTP Exchange Server TCP Port 636 - LDAP SSL Local Security Authority UDP Port 636 - LDAP SSL Local Security Authority TCP Port 993 - IMAP over SSL Exchange Server TCP Port 995 - POP3 over SSL Exchange Server TCP Port 1067 - Installation Bootstrap Service Installation Bootstrap protocol server TCP Port 1068 - Installation Bootstrap Service Installation Bootstrap protocol client TCP Port 1270 - MOM-Encrypted Microsoft Operations Manager 2000 TCP Port 1433 - SQL over TCP Microsoft SQL Server TCP Port 1433 - SQL over TCP MSSQL$UDDI UDP Port 1434 - SQL Probe Microsoft SQL Server UDP Port 1434 - SQL Probe MSSQL$UDDI UDP Port 1645 - Legacy RADIUS Internet Authentication Service UDP Port 1646 - Legacy RADIUS Internet Authentication Service UDP Port 1701 - L2TP Routing and Remote Access TCP Port 1723 - PPTP Routing and Remote Access TCP Port 1755 - MMS Windows Media Services UDP Port 1755 - MMS Windows Media Services TCP Port 1801 - MSMQ Message Queuing UDP Port 1801 - MSMQ Message Queuing UDP Port 1812 - RADIUS Authentication Internet Authentication Service UDP Port 1813 - RADIUS Accounting Internet Authentication Service UDP Port 1900 - SSDP SSDP Discovery Service TCP Port 2101 - MSMQ-DCs Message Queuing TCP Port 2103 - MSMQ-RPC Message Queuing TCP Port 2105 - MSMQ-RPC Message Queuing TCP Port 2107 - MSMQ-Mgmt Message Queuing TCP Port 2393 - OLAP Services 7.0 SQL Server: Downlevel OLAP Client Support TCP Port 2394 - OLAP Services 7.0 SQL Server: Downlevel OLAP Client Support UDP Port 2460 - MS Theater Windows Media Services UDP Port 2535 - MADCAP DHCP Server TCP Port 2701 - SMS Remote Control (control) SMS Remote Control Agent UDP Port 2701 - SMS Remote Control (control) SMS Remote Control Agent TCP Port 2702 - SMS Remote Control (data) SMS Remote Control Agent UDP Port 2702 - SMS Remote Control (data) SMS Remote Control Agent TCP Port 2703 - SMS Remote Chat SMS Remote Control Agent UPD Port 2703 - SMS Remote Chat SMS Remote Control Agent TCP Port 2704 - SMS Remote File Transfer SMS Remote Control Agent UDP Port 2704 - SMS Remote File Transfer SMS Remote Control Agent TCP Port 2725 - SQL Analysis Services SQL Analysis Server TCP Port 2869 - UPNP Universal Plug and Play Device Host TCP Port 2869 - SSDP event notification SSDP Discovery Service TCP Port 3268 - Global Catalog Server Local Security Authority TCP Port 3269 - Global Catalog Server Local Security Authority UDP Port 3343 - Cluster Services Cluster Service TCP Port 3389 - Terminal Services NetMeeting Remote Desktop Sharing TCP Port 3389 - Terminal Services Terminal Services UDP Port 3527 - MSMQ-Ping Message Queuing UDP Port 4011 - BINL Remote Installation UDP Port 4500 - NAT-T Local Security Authority TCP Port 5000 - SSDP legacy event notification SSDP Discovery Service UDP Port 5004 - RTP Windows Media Services UDP Port 5005 - RTCP Windows Media Services TCP Port 6001 - Information Store Exchange Server 2003 TCP Port 6002 - Directory Referral Exchange Server 2003 TCP Port 6004 - DSProxy/NSPI Exchange Server 2003 TCP Port 42424 - ASP.Net Session State ASP.NET State Service TCP Port 51515 - MOM-Clear Microsoft Operations Manager 2000 Взято из http://forum.sources.ru.
Автор: Rouse_
©Drkb::03360.
| Назначение цвета для каждой строки |
Code: Procedure TFormHistory.ListHistoryDrawCell(Sender: TObject; Col, Row: Integer; Rect: TRect; State: TGridDrawState); Var. S: string; DrawRect: TRect; CurrentColor: TColor; Begin. // Определяем цвет строки в зависимости типа Imcoming. If (Sender as TStrinGgrid).Cells[COLUMN_INCOMING , Row ] = '1' then. CurrentColor:=clBlue. Else. CurrentColor:=clMaroon; If (Sender as TStrinGgrid).Row = Row then. CurrentColor := clHighlightText; (Sender as TStrinGgrid).Canvas.font.color := CurrentColor; S:= (Sender as TStrinGgrid).Cells[ Col, Row ]; If (Col = COLUMN_MESSAGE ) and (Row <> ROW_HEADER) then. Begin. If Length(S) > 0 then. Begin. DrawRect:=Rect; DrawText((Sender as TStrinGgrid).Canvas.Handle, Pchar(S), Length(S), DrawRect, dt_calcrect or dt_wordbreak or dt_left ); If (DrawRect.bottom - DrawRect.top) > (Sender as TStrinGgrid).RowHeights[Row] then. (Sender as TStrinGgrid).RowHeights[row] :=(DrawRect.bottom - DrawRect.top). Else. Begin. DrawRect.Right:=Rect.Right; (Sender as TStrinGgrid).Canvas.FillRect( DrawRect ); DrawText((Sender as TStrinGgrid).Canvas.Handle, Pchar(S), Length(S), DrawRect, dt_wordbreak or dt_left); End; End; End. Else. If Row <> ROW_HEADER then. (Sender as TStrinGgrid).Canvas.Textout(rect.left+3, rect.top+3 , S ); End;
Обзор HTTP.
| Обзор HTTP. |
Обзор HTTP.
Hypertext Transfer Protocol (HTTP, протокол пересылки гипертекста) - это язык, которым клиенты и серверы World Wide Web пользуются для общения между собой. Он, по сути дела, является основой в Web.
Хотя HTTP в большей степени относится к сфере программирования серверов и клиентов, знание этого протокола важно и для CGI-программирования. Кроме того, иногда HTTP фильтрует информацию и передает ее обратно пользователям - это происходит, например, когда в окне броузера отображаются коды ошибок сервера.
Принципы работы HTTP.
Все HTTP-транзакции имеют один общий формат. Каждый запрос клиента и ответ сервера состоит из трех частей: строки запроса (ответа), раздела заголовка и тела. Клиент инициирует транзакцию следующим образом:
1. Клиент устанавливает связь с сервером по назначенному номеру порта (по умолчанию - 80). Затем клиент посылает запрос документа, указав HTTP-команду, называемую методом, адрес документа и номер версии HTTP. Например, в запросе
GET /index.html HTTP/1.0.
используется метод GET, которым с помощью версии 1.0 HTTP запрашивается документ index.html. Методы HTTP более подробно рассматриваются ниже.
2. Клиент посылает информацию заголовка (необязательную), чтобы сообщить серверу информацию о своей конфигурации и данные о форматах документов, которые он может принимать. Вся информация заголовка указывается построчно, при этом в каждой строке приводится имя и значение. Например, приведенный ниже заголовок, посланный клиентом, содержит его имя и номер версии, а также информацию о некоторых предпочтительных для клиента типах документов:
User-Agent: Mozilla/4.05 (WinNT; 1).
Accept: image/gif, image/x-xbitmap, image/jpeg, image/pjpeg, */*
Завершается заголовок пустой строкой.
3. Послав запрос и заголовки, клиент может отправить и дополнительные данные. Эти данные используются главным образом теми CGI-программами, которые применяют метод POST. Клиенты (например, Netscape Navigator-Gold), также могут использовать их для помещения отредактированной страницы обратно на Web-сервер.
Сервер отвечает на запрос клиента следующим образом:
1. Первая часть ответа сервера - строка состояния, содержащая три поля: версию HTTP, код состояния и описание. Поле версии содержит номер версии HTTP, которой данный сервер пользуется для передачи ответа.
Код состояния - это трехразрядное число, обозначающее результат обработки сервером запроса клиента. Описание, следующее за кодом состояния, представляет собой просто понятный для человека текст, поясняющий код состояния. Например, строка состояния
НТТР/1.0 200 OK.
говорит о том, что сервер для ответа использует версию HTTP 1.0. Код состояния 200 означает, что запрос клиента был успешным и затребованные данные будут переданы после заголовков.
2. После строки состояния сервер передает клиенту информацию заголовка, содержащую данные о самом сервере и затребованном документе. Ниже приведен пример заголовка:
Date: Fri, 10 Jan 1998 08:17:58 GMT.
Server: Apache/1.2.6.
Last-modified: Mon, 12 Jun 1997 21:53:08 GMT.
Content-type: text/html.
Content-length: 2482.
Завершает заголовок пустая строка.
3. Если запрос клиента успешен, то посылаются затребованные данные. Это может быть копия файла или результат выполнения CGI-программы. Если запрос клиента удовлетворить нельзя, передаются дополнительные данные в виде понятного для пользователя разъяснения причин, по которым сервер не смог выполнить данный запрос.
В HTTP 1.0 за передачей сервером затребованных данных следует разъединение с клиентом, и транзакция считается завершенной, если не передан заголовок Connection: Keep Alive. В HTTP 1.1 сервер по умолчанию не разрывает соединение и клиент может посылать другие запросы. Поскольку во многие документы встроены другие документы - изображения, кадры, апплеты и т.д., это позволяет сэкономить время и затраты клиента, которому в противном случае пришлось бы для получения всего одной страницы многократно соединяться с одним и тем же сервером. Таким образом, в HTTP 1.1 транзакция может циклически повторяться, пока клиент или сервер не закроет соединение явно.
HTTP не сохраняет информацию по транзакциям, поэтому в следующей транзакции приходится начинать все заново. Преимущество состоит в том, что HTTP сервер может обслужить в заданный промежуток времени гораздо больше клиентов, ибо устраняются дополнительные расходы на отслеживание сеансов от одного соединения к другому. Есть и недостаток: для сохранения информации по транзакциям более сложные CGI-программы должны пользоваться скрытыми полями ввода или внешними средствами, например "ключиками" (cookies) Netscape.
Запросы клиента
Запросы клиента разбиваются на три раздела. Первая строка сообщения всегда содержит HTTP-команду, называемую методом, URI, который обозначает запрашиваемый клиентом файл или ресурс, и номер версии HTTP. Следующие строки запроса клиента содержат информацию заголовка. Информация заголовка содержит сведения о клиенте и информационном объекте, который он посылает серверу. Третья часть клиентского запроса представляет собой тело содержимого - собственно данные, посылаемые серверу.
URI (Uniform Resource Identifier, универсальный идентификатор ресурса) - это общий термин для всех допустимых форматов схем адресации, поддерживаемых в World Wide Web. Сейчас общепринятой является схема адресации с использованием универсальных локаторов ресурсов (URL).
Методы
Метод - это HTTP-команда, с которой начинается первая строка запроса клиента. Метод сообщает серверу о цели запроса. Для HTTP определены три основных метода: GET, HEAD и POST. Определены и другие методы, но они не так широко поддерживаются серверами, как три перечисленных (хотя эти другие методы в будущем будут использоваться более часто). При задании имен методов учитывается регистр, поэтому GET и get различаются. Метод GET.
GET - это запрос информации, расположенной на сервере по указанному URL. GET - наиболее распространенный метод поиска с помощью броузеров документов для визуализации. Результат запроса GET может представлять собой, например, файл, доступный для сервера, результат выполнения программы или CGI-сценария, выходную информацию аппаратного устройства и т.д.
Если клиент пользуется в своем запросе методом GET, сервер отвечает строкой состояния, заголовками и затребованными данными. Если сервер не может обработать запрос вследствие ошибки или отсутствия полномочий, он, как правило, посылает в информационном разделе ответа текстовое пояснение.
Тело информационного содержимого запроса GET всегда пустое. GET в переводе на человеческий язык означает примерно следующее: "Дайте мне этот файл". Для идентификации указанных в запросе клиента файла или программы обычно используется полное имя этого объекта на сервере.
Ниже приведен пример успешного запроса GET на получение файла. Клиент посылает запрос:
GET /index.html HTTP/1.О
Connection: Keep-Alive.
User-Agent: Mozilla/4.05 (WinNT; 1).
Host: www.ora.com.
Accept: image/gif, image/x-xbitmap, image/jpeg, image/pjpeg, */*
Сервер отвечает:
HTTP/1.0 200 Document follows.
Date: Fri, 20 Jan 1998 08:17:58 GMT.
Server: Apache/1.2.6.
Last-modified: Mon, 20 Jun 1997 21:53:08 GMT.
Content-type: text/html.
Content-length: 2482.
(далее следует тело документа).
Метод GET используется также для передачи входной информации в CGI-про- граммы посредством тегов форм. Поскольку тело запроса GET пусто, входные данные присоединяются к URL в строке GET запроса. Если в теге <form> задано значение атрибута method="GET", то пары ключ-значение, представляющие собой введенные данные из формы, присоединяются к URL после вопросительного знака. Пары отделяются друг от друга амперсандом (&). Например, по запросу
GET /cgi-bin/birthday.pl?month=august&date=24 HTTP/1.О
сервер передаст в CGI-программу birthday.pl значения month и date, указанные в форме, созданной на клиенте. Входные данные в конце URL кодируются в спецификации CGI. Чтобы специальные символы интерпретировались обычным образом, используются их шестнадцатиричные коды.
Аналогичным образом в методе GET может передаваться информация о дополнительных путях. При этом дополнительный путь указывается после URL, т.е. /cgi-bin/display.pl/cgi/cgi_doc.txt. Сервер определяет, где заканчивается имя программы (display.pl). Все данные, которые следуют за именем программы, интерпретируются как дополнительный путь. Метод HEAD.
Метод HEAD аналогичен методу GET, за исключением того, что сервер ничего не посылает в информационной части ответа. Метод HEAD запрашивает только информацию заголовка о файле или ресурсе. Информация заголовка запроса HEAD должна быть такой же, как в запросе GET.
Этот метод используется, когда клиент хочет найти информацию о документе, не получая его. Для метода HEAD существует множество приложений. Например, клиент может затребовать следующую информацию:
· время изменения документа (эти данные полезны для запросов, связанных с кэш-памятью);
· размер документа (необходим для компоновки страницы, оценки времени передачи, определения необходимости запроса более компактной версии документа);
· тип документа (позволяет клиенту изучать документы только определенного типа);
· тип сервера (позволяет создавать специализированные запросы).
Следует отметить, что большая часть информации заголовка, которую посылает сервер, не является обязательной и может предоставляться не всеми серверами. Рекомендуемый вариант для Web-клиентов - учитывать гибкость ответов сервера и предусматривать определенные меры по умолчанию, если сервер не передал необходимую информацию заголовка.
Ниже приведен пример HTTP-транзакции с использованием запроса HEAD. Клиент посылает запрос:
HEAD /index.html HTTP/1.0.
Connection: Close.
User-Agent: Mozilla/4.05 (WinNT; 1).
Host: www.ora.com.
Accept: image/gif, image/x-xbitmap, image/jpeg, image/pjpeg, */*
Сервер отвечает:
HTTP/1.0 200 Document follows.
Date: Fri, 20 Jan 1998 08:17:58 GMT.
Server: Apache/1.2.6.
Last-modified: Mon, 17 Jun 1996 21:53:08 GMT.
Content-type: text/html.
Content-length: 2482.
(Тело содержимого в ответе на запрос HEAD не передается.).
Метод POST.
Метод POST позволяет посылать на сервер данные в запросе клиента. Эти данные направляются в программу обработки данных, к которой сервер имеет доступ (например, в CGI-сценарий). Метод POST может использоваться во многих приложениях. Например, его можно применять для передачи входных данных для:
· сетевых служб (таких как телеконференции);
· программ с интерфейсом в виде командной строки;
· аннотирования документов на сервере;
· выполнения операций в базах данных.
Данные, посылаемые на сервер, находятся в теле содержимого запроса клиента. По завершении обработки запроса POST и заголовков сервер передает тело содержимого в программу, заданную URL. В качестве схемы кодирования с методом POST используется URL-кодирование, которое позволяет преобразовывать данные форм в список переменных и значений для CGI-обработки.
Ниже приведен небольшой пример запроса клиента с использованием метода POST. Клиент посылает на сервер данные о дне рождения, введенные в форму:
POST /cgi-bin/birthday.pl HTTP/1.0.
User-Agent; Mozilla/4.05 (WinNT; 1).
Accept: image/gif, iinage/x-xbj.tmap, image/jpeg, J.mage/pjpeg, */*
Host: www.ora.com.
Content-type: application/x-www-form-ur.lencoded.
Content-Length: 20.
Nionth=august&date=24.
Другие методы
Приведенные ниже методы также определены, хотя и используются не столь часто:
LINK Связывает информацию заголовка с документом на сервере.
UNLINK Отменяет связь информации заголовка с документом на сервере.
PUT Помещает тело содержимого запроса по указанному URI.
DELETE Удаляет данные, находящиеся на сервере по заданному URI.
OPTIONS Запрашивает информацию о коммуникационных параметрах сервера. Чтобы запросить данные обо всем сервере в целом, вместо URI запроса следует использовать символ *.
TRACE Требует, чтобы тело содержимого запроса было возвращено без изменений. Используется для отладки.
Ответы сервера
Ответ сервера на запрос клиента состоит из трех частей. Первая строка - это строка ответа сервера, которая содержит номер версии HTTP, число, обозначающее состояние запроса, и краткое описание состояния. После строки ответа следует информация заголовка и тело содержимого, если таковое имеется.
Коды ответов HTTP сервера
В первой строке ответа HTTP-сервера содержится информация о том, был запрос клиента успешным или нет, а также данные о причинах успешного либо неуспешного завершения запроса. Эта информация обозначается трехразрядным кодом ответа сервера (иногда его называют кодом состояния) и сопровождается описательным сообщением.
Коды состояний обычно генерируются Web-серверами, но иногда это могут делать и CGI-сценарии, CGI-сценарии генерируют собственные заголовки вместо тех, которые должен выдавать сервер. Коды состояний группируются следующим образом:
Диапазон кодов Значение ответа 100-199. Информационный 200-299. Запрос клиента успешен 300-399. Запрос клиента переадресован, необходимы дальнейшие действия 400-499. Запрос клиента является неполным 500-599. Ошибки сервера
В HTTP в каждом диапазоне определены лишь несколько кодов, хотя для сервера при необходимости могут определяться собственные коды. Клиент при получении кода, который он не может распознать, интерпретирует его в соответствии с диапазоном, к которому этот код принадлежит. Коды в диапазонах 100-199, 200-299 и 300-399 большинство Web-броузеров обрабатывают без извещения пользователя, а некоторые коды ошибок из диапазонов 400-499 и 500-599 отображаются для пользователя (например, 404 Not Found).
Информационные ответы
Ответы в диапазоне 100-199 - информационные; они показывают, что запрос клиента принят и обрабатывается.
100 Continue Начальная часть запроса принята, и клиент может продолжать передачу запроса.
101 Switching Protocols Сервер выполняет требование клиента и переключает протоколы в соответствии с указанием, данным в поле заголовка Upgrade.
Успешные запросы клиента
Ответы в диапазоне 200-299 означают, что запрос клиента обработан успешно.
200 OK Запрос клиента обработан успешно, и ответ сервера содержит затребованные данные.
201 Created Этот код состояния используется в случае создания нового URI. Вместе с этим кодом результата сервер выдает заголовок Location (см. главу 19), который содержит информацию о том, куда были помещены новые данные.
202 Accepted Запрос принят, но обрабатывается не сразу. В теле содержимого ответа сервера может быть дана дополнительная информация о данной транзакции. Гарантии того, что сервер в конечном итоге удовлетворит запрос, нет, даже несмотря на то, что на момент приема запрос выглядел допустимым.
203 Non-Authoritative Information Информация в заголовке содержимого взята из локальной копии или у третьей стороны, а не с исходного сервера.
204 No Content Ответ содержит код состояния и заголовок, но тело содержимого отсутствует. При получении этого ответа броузер не должен обновлять свой документ. Обработчик чувствительных областей изображений может возвращать этот код, когда пользователь щелкает на бесполезных или пустых участках изображения.
205 Reset Content Броузер должен очистить форму, используемую в данной транзакции, для дополнительных входных данных. Полезен для CGI-приложений, требующих ввода данных.
206 Partial Content Сервер возвращает лишь часть данных затребованного объема. Используется в ответе на запрос с указанием заголовка Range. Сервер должен указать диапазон, включенный в ответ, в заголовке Content-Range.
Переадресация
Код ответа в диапазоне 300-399 означает, что запрос не выполнен и клиенту нужно предпринять некоторые действия для удовлетворения запроса.
300 Multiple Choices Затребованный URI обозначает более одного ресурса. Например, URI может обозначать документ, переведенный на несколько языков. В теле содержимого, возвращенном сервером, может находиться перечень более конкретных данных о том, как выбрать ресурс правильно.
301 Moved Permanently Затребованный URI уже не используется сервером, и указанная в запросе операция не выполнена. Новое местонахождение затребованного документа указывается в заголовке Location. Во всех последующих запросах данного документа следует указывать новый URI.
302 Moved Temporarily Затребованный URI перемешен, но лишь временно. Заголовок Location указывает на новое местонахождение. Сразу же после получения этого кода состояния клиент должен разрешить запрос при помощи нового URI, но во всех последующих запросах необходимо пользоваться старым URI.
303 See Other Затребованный URI можно найти по другому URI (указанному в заголовке Location). Его следует выбрать методом GET по данному ресурсу.
304 Not Modified Это код ответа на заголовок lf-Modified-Since, если URI не изменялся с указанной даты. Тело содержимого не посылается, и клиент должен использовать свою локальную копию.
305 Use Proxy Доступ к затребованному URI должен осуществляться через proxy-сервер, указанный в заголовке Location.
Неполные запросы клиента
Коды ответов в диапазоне 400-499 означают, что запрос клиента неполный. Эти коды могут также означать, что от клиента требуется дополнительная информация.
400 Bad Request Означает, что сервер обнаружил в запросе клиента синтаксическую ошибку.
401 Unauthorized Этот код результата, передаваемый с заголовком WWW-Authenticate, показывает, что пославший запрос пользователь не имеет необходимых полномочий и что при повторении запроса с указанием данного URI пользователь должен такие полномочия предоставить.
402 Payment Required Этот код в HTTP еще не реализован.
403 Forbidden Запрос отклонен по той причине, что сервер не хочет (или не имеет возможности) ответить клиенту.
404 Not Found Документ по указанному URI не существует.
405 Method Not Allowed Этот код выдается с заголовком Allow и показывает, что метод, используемый клиентом, для данного URI не поддерживается.
406 Not Acceptable Ресурс, указанный клиентом по данному URI, существует, но не в том формате, который нужен клиенту. Вместе с этим кодом сервер выдает заголовки Content-Language, Content-Encoding и Content-Type.
407 Proxy Authentication Required Proxy-сервер должен санкционировать запрос перед тем, как пересылать его. Используется с заголовком Proxy-Authenticate.
408 Request Time-out Этот код ответа означает, что клиент не передал полный запрос в течение некоторого установленного промежутка времени (который обычно задается в конфигурации сервера) и сервер разрывает сетевое соединение.
409 Conflict Данный запрос конфликтует с другим запросом или с конфигурацией сервера. Информацию о конфликте следует возвратить в информационной части ответа.
410 Gone Данный код показывает, что затребованный URI больше не существует и навсегда удален с сервера.
411 Length Required Сервер не примет запрос без указанного в нем заголовка Content-Length.
412 Precondition Failed Результат вычисления условия, заданного в запросе одним или несколькими заголовками if. . ., представляет собой "ложь".
413 Request Entity Too Large Сервер не будет обрабатывать запрос, потому что его тело слишком велико.
414 Request-URI Too Long Сервер не будет обрабатывать запрос, потому что его URI слишком длинный.
415 Unsupported Media Type Сервер не будет обрабатывать запрос, потому что его тело имеет неподдерживаемый формат.
Ошибки сервера
Коды ответов в диапазоне 500-599 показывают, что сервер столкнулся с ошибкой и, вероятно, не сможет выполнить запрос клиента.
500 Internal Server Error При обработке запроса на сервере один из его компонентов (например, CGI-программа) выдал аварийный отказ или столкнулся с ошибкой конфигурации.
501 Not Implemented Клиент запросил выполнение действия, которое сервер выполнить не может.
502 Bad Gateway Сервер (или proxy-сервер) получил недопустимые ответы другого сервера (или proxy-сервера).
503 Service Unavailable Данный код означает, что данная служба временно недоступна, но в будущем доступ к ней будет восстановлен. Если сервер знает, когда это произойдет, может быть также выдан заголовок Retry-After.
504 Gateway Time-out Этот ответ похож на 408 (Request Time-out) , за исключением того, что шлюз или уполномоченный сервер превысил лимит времени.
505 HTTP Version not supported Сервер не поддерживает версию протокола HTTP, использованную в запросе. Этот текст был взят из книги Stephen Spainhour и Valerie Quercia "Webmaster in a nutshell". Перевод c английского С.М.Тимачева, под редакцией К.Ю.Королькова.
©Drkb::03372.
Обзор средств проектирования информационных систем.
| Обзор средств проектирования информационных систем |
Обзор средств проектирования информационных систем
А.М.Вендров, Центральный банк РФ
Цель данного доклада - попытаться описать и обосновать один из возможных подходов к анализу и выбору средств проектирования информационных систем достаточно крупного масштаба (здесь намеренно не используется термин "CASE-средство", поскольку большинство известных CASE-средств в лучшем случае позволяют описать будущие приложения лишь в самом общем виде). Конечный результат выбора ни в коем случае не следует рассматривать как нечто абсолютное, он отражает лишь мнение конкретного коллектива разработчиков, утвердившееся на заданном временном интервале. Под средствами проектирования информационных систем (СП ИС) будем понимать комплекс инструментальных средств, обеспечивающих в рамках выбранной методологии проектирования поддержку полного жизненного цикла (ЖЦ) ИС, который включает в себя, как правило, стратегическое планирование, анализ, проектирование, реализацию, внедрение и эксплуатацию. Каждый этап характеризуется определенными задачами и методами их решения, исходными данными, полученными на предыдущем этапе, и результатами. При анализе СП их следует рассматривать не локально, а в комплексе, что позволяет реально охарактеризовать их достоинства, недостатки и место в общем технологическом цикле создания ИС. В общем случае стратегия выбора СП для конкретного применения зависит от следующих факторов:
· характеристик моделируемой предметной области;
· целей, потребностей и ограничений будущего проекта ИС, включая квалификацию участвующих в процессе проектирования специалистов;
· используемой методологии проектирования.
Тенденции развития современных информационных технологий приводят к постоянному возрастанию сложности ИС, создаваемых в различных областях экономики. Современные сложные ИС и проекты, обеспечивающие их создание, характеризуются, как правило, следующими особенностями:
· сложность предметной области (достаточно большое количество функций, объектов, атрибутов и сложные взаимосвязи между ними), требующая тщательного моделирования и анализа данных и процессов;
· наличие совокупности тесно взаимодействующих компонентов - подсистем, имеющих свои локальные задачи и цели функционирования;
· иерархическую структуру взаимосвязей компонентов, обеспечивающую устойчивость функционирования системы;
· иерархическую совокупность критериев качества функционирования компонентов и ИС в целом, обеспечивающих достижение главной цели - создания и последующего применения системы;
· отсутствие прямых аналогов, ограничивающее возможность использования каких-либо типовых проектных решений и прикладных систем;
· необходимость достаточно длительного сосуществования старых приложений и вновь разрабатываемых БД и приложений;
· наличие потребности как в традиционных приложениях, связанных с обработкой транзакций и решением регламентных задач, так и в приложениях аналитической обработки (поддержки принятия решений), использующих нерегламентированные запросы к данным большого объема;
· поддержка одновременной работы достаточно большого количества локальных сетей, связываемых в глобальную сеть масштаба предприятия, и территориально удаленных пользователей;
· функционирование в неоднородной операционной среде на нескольких вычислительных платформах;
· разобщенность и разнородность отдельных микроколлективов разработчиков по уровню квалификации и сложившимся традициям использования тех или иных инструментальных средств;
· существенная временная протяженность проекта, обусловленная, с одной стороны, ограниченными возможностями коллектива разработчиков, и, с другой стороны, масштабами организации-заказчика и различной степенью готовности отдельных ее подразделений к внедрению ИС.
Методология проектирования определяется как совокупность трех составляющих:
· пошаговой процедуры, определяющей последовательность технологических операций проектирования;
· критериев и правил, используемых для оценки результатов выполнения технологических операций;
· нотаций (графических и текстовых средств), используемых для описания проектируемой системы.
На выбор СП могут существенно повлиять следующие особенности методологии проектирования:
· ориентация на создание уникального или типового проекта;
· итерационный характер процесса проектирования;
· возможность декомпозиции проекта на составные части, разрабатываемые группами исполнителей ограниченной численности с последующей интеграцией составных частей;
· жесткая дисциплина проектирования и разработки при их коллективном характере;
· необходимость отчуждения проекта от разработчиков и его последующего централизованного сопровождения.
Критерии выбора
Традиционно при обсуждении проблемы выбора СП (в особенности CASE-средств) большое внимание уделялось особенностям реализации той или иной методологии анализа предметной области (E-R, IDEF0, IDEF1Х, Gane/Sarson, Yordon, Barker и др.). Безусловно, богатство изобразительных и описательных средств дает возможность на этапах стратегического планирования и анализа построить наиболее полную и адекватную модель предметной области. С другой стороны, если говорить о конечных результатах - базах данных и приложениях, то обнаруживается, что часть описаний в них практически не отражается, оставаясь чисто декларативной (на выходе мы в любом случае получим описание БД в табличном представлении с минимальным набором ограничений целостности и исполнимый код приложений, большую часть которых составляют экранные формы, не выводимые непосредственно из моделей предметной области). Опытные аналитики и проектировщики всегда с большими или меньшими трудозатратами придут к нужному конечному результату независимо от того, какая конкретно методология или ее разновидность реализована в данном инструменте. Это, конечно, не означает, что методология не важна, напротив, отсутствие или неполнота описательных средств могут с самого начала значительно затруднить работу над проектом. Однако, зачастую на первом плане оказываются другие критерии, невыполнение которых может породить гораздо большие трудности. Может создаться впечатление, что если можно сформировать необходимую аппаратную платформу из компонентов различных фирм-производителей, то так же просто можно выбрать и скомплексировать разные инструментальные средства, каждое из которых является одним из мировых лидеров в своем классе. Однако в случае инструментальных средств в настоящее время, в отличие от оборудования, отсутствуют международные стандарты на основные свойства конечных продуктов (программ, баз данных и их сопряжение). Однако, поскольку составные части проекта должны быть интегрированы в единый продукт, следовательно, имеет смысл рассматривать не любые, а только сопряженные инструментальные средства, которые в принципе могут быть ориентированы - даже внутри одного класса - на разные методологии; при этом необходимо отбирать в состав комплекса СП средства, поддерживающие по крайней мере близкие методологии, если не одну и ту же. Исходя из перечисленных выше соображений, примем в качестве основных критериев выбора СП следующие критерии:
Поддержка полного жизненного цикла ИС с обеспечением эволюционности ее развития. Полный жизненный цикл ИС должен поддерживаться "сквозной" технологической цепочкой средств разработчика, обеспечивающей решение следующих задач:
· обследование и получения формализованных знаний о предметной области (последовательный и логически связный переход от формализованного описания предметной области к ее моделям);
· декомпозиция проекта на составные части и интеграция составных частей;
· проектирование моделей приложений (логики приложений и пользовательских интерфейсов);
· прототипирование приложений;
· проектирование баз данных;
· коллективная, территориально распределенная разработка приложений с использованием различных инструментальных средств (включая их интеграцию, тестирование и отладку);
· разработка распределенных баз данных (с выбором оптимальных вариантов распределения);
· разработка проектной документации с учетом требований проектных стандартов;
· адаптация к различным системно-техническим платформам и СУБД;
· тестирование и испытания;
· сопровождение, внесение изменений и управление версиями и конфигурацией ИС;
· интеграция с существующими разработками (включая реинжиниринг приложений, конвертирование БД);
· администрирование ИС (оптимизация эксплуатационных характеристик);
· управление разработкой и сопровождением ИС (планирование, координация и контроль за ресурсами и ходом выполнения работ);
· прогнозирование и оценка трудоемкости, сроков и стоимости разработки.
Для существующих ИС должен обеспечиваться плавный переход из старой среды эксплуатации в новую с минимальными переделками и поддержкой эксплуатируемых баз данных и приложений, внедренных до начала работ по созданию новой системы.
Обеспечение целостности проекта и контроля за его состоянием. Данное требование означает наличие единой технологической среды создания, сопровождения и развития ИС, а также целостность базы проектных данных (репозитория). Единая технологическая среда должна обеспечиваться за счет использования единственной CASE-системы для поддержки моделей ИС, а также за счет наличия программно-технологических интерфейсов между отдельными инструментальными средствами, сертифицированных и поддерживаемых фирмами- разработчиками соответствующих средств. В частности, интерфейс между CASE-системой и средствами разработки приложений должен выполнять две основные функции: а) непосредственный переход в рамках единой среды от описания логики приложения, реализованного CASE-системой, к разработке пользовательского интерфейса (экранных форм); б) перенос описания БД из репозитория CASE-системы в репозиторий средства разработки приложений и обратно. Вся информация о проекте должна автоматически помещаться в базу проектных данных, при этом должны поддерживаться согласованность, непротиворечивость, полнота и минимальная избыточность проекта, а также корректность операций его редактирования. Это может быть достигнуто при условии исключения или существенного ограничения возможности актуализации репозитория различными средствами. Должны также обеспечиваться возможности для централизованного сбора, хранения и распределения информации между различными этапами проекта, группами разработчиков и выполняемыми операциями. Поддержка базы проектных данных может быть реализована собственными средствами СП или средствами целевой СУБД (второй вариант предпочтительнее, поскольку упрощается технология ведения репозитория). Невыполнение требования целостности в условиях разобщенности разработчиков и временной протяженности крупного проекта может означать утрату контроля за его состоянием.
Независимость от программно-аппаратной платформы и СУБД. Требование определяется неоднородностью среды функционирования ИС. Такая независимость может иметь две составляющих: независимость среды разработки и независимость среды эксплуатации приложений. Она обеспечивается за счет наличия совместимых версий СП для различных платформ и драйверов соответствующих сетевых протоколов, менеджеров транзакций и СУБД. Один из дополнительных факторов, который при этом следует учитывать - это способ взаимодействия с СУБД (прямой или через ODBC), поскольку использование ODBC может заметно ухудшить производительность и надежность интерфейса.
Поддержка одновременной работы групп разработчиков. Развитые СП должны обладать возможностями разделения полномочий персонала разработчиков и объединения отдельных работ в общий проект. Должна обеспечиваться одновременная работа проектировщиков БД и разработчиков приложений (разработчики приложений в такой ситуации могут начинать работу с базой данных, не дожидаясь полного завершения ее проектирования CASE-средствами). При этом все группы специалистов должны быть обеспечены адекватным инструментарием, а внесение изменений в проект различными разработчиками должно быть согласованным и корректным. Каждый разработчик должен иметь возможность работы со своим личным репозиторием, являющимся фрагментом или копией общего репозитория. Должны обеспечиваться содержательная интеграция всех изменений, вносимых разработчиками, в общем репозитории, одновременная доступность для разработчика общего и личного репозиториев и простота переноса объектов между ними. Помимо перечисленных основных критериев, предварительный анализ при выборе СП должен учитывать следующие аспекты:
Возможность разработки приложений "клиент-сервер" требуемой конфигурации. Подразумевается сочетание наличия развитой графической среды разработки приложений (многооконность, разнообразие стандартных графических объектов, разнообразие используемых шрифтов и т.д.) с возможностью декомпозиции (partitioning) приложения на "клиентскую" часть, реализующую пользовательский экранный интерфейс и "серверную" часть. При этом должна обеспечиваться возможность перемещения отдельных компонентов приложения между "клиентом" и "сервером" на наиболее подходящую платформу, обеспечивающую максимальную эффективность функционирования приложения в целом, а также возможность использования сервера приложений (менеджера транзакций).
Открытая архитектура и возможности экспорта/импорта. Открытая и общедоступная информация об используемых форматах данных и прикладных программных интерфейсах должна позволять интегрировать инструментальные средства третьих фирм и относительно безболезненно переходить от одной системы к другой. Возможности экспорта/импорта означают, что спецификации, полученные на этапах анализа, проектирования и реализации для одной ИС, могут быть использованы для проектирования другой ИС. Повторное проектирование и реализация могут быть обеспечены при помощи средств экспорта/импорта спецификаций в различные СП.
Качество технической поддержки в России, стоимость приобретения и поддержки, опыт успешного использования. Имеется в виду наличие квалифицированных дистрибьюторов и консультантов, быстрота обслуживания пользователей, высокое качество технической поддержки и обучения продукту и методологии его применения для больших коллективов разработчиков (наличие сведений о практике использования системы, качество документации, укомплектованность примерами и обучающими курсами, наличие прототипных проектов). Затраты на обучение новым технологиям значительны, однако потери от использования современных сложных технологий необученными специалистами могут оказаться значительно выше. Кроме того, фирмы-поставщики инструментальных средств должны быть устойчивыми, так как технология выбирается не на один год, а также должны обеспечивать хорошую поддержку на территории России (горячая линия, консультации, обучение, консалтинг), возможно, через дистрибьюторов. Что касается стоимости, следует учитывать возможность получения бесплатной пробной лицензии (trial license), стоимость лицензии на одно рабочее место СП, скидки, предоставляемые фирмой в случае приобретения большого количества лицензий, необходимость приобретения run-time версий для эксплуатации приложений и т.д. В то же время стоимость продукта должна рассматриваться не сама по себе, а с учетом ее соответствия возможностям продукта.
Простота использования. Учитываются следующие характеристики:
· доступность пользовательского интерфейса;
· время, необходимое для обучения;
· простота инсталляции;
· качество документации.
Обеспечение качества проектной документации. Это требование относится к возможностям СП анализировать и проверять описания и документацию на полноту и непротиворечивость, а также на соответствие принятым в данной методологии стандартам и правилам (включая ГОСТ, ЕСПД). В результате анализа должна формироваться информация, указывающая на имеющиеся противоречия или неполноту в проектной документации. Должна быть также обеспечена возможность создавать новые формы документов, определяемые пользователями.
Использование общепринятых, стандартных нотаций и соглашений. Для того, чтобы проект мог выполняться разными коллективами разработчиков, необходимо использование стандартных методов моделирования и стандартных нотаций, которые должны быть оформлены в виде нормативов до начала процесса проектирования. Несоблюдение данного требования ставит разработчиков в зависимость от фирмы-производителя данного средства, делает затруднительным формальный контроль корректности используемых нотаций и снижает возможности привлечения дополнительных коллективов разработчиков, поскольку число специалистов, знакомых с данным методом (нотацией) может быть ограниченным. В идеальном случае (что, конечно же, далеко не всегда возможно) окончательный выбор может быть произведен по результатам тестирования в соответствии с заданным планом, которое должно включать имитацию проектирования реальной БД и разработки приложений и состоять из следующих шагов:
· установка и конфигурирование (ясность и точность инструкций по установке, наличие подсказок в процессе установки, возможность установки по выбору и задания многопользовательской конфигурации);
· разработка концептуальной схемы БД (понятность и простота построения, модификации и документирования различных элементов диаграмм "сущность-связь", отображение ограничений ссылочной целостности и бизнес- правил, управление режимом отображения);
· формирование отчета о концептуальной схеме (список сущностей с определениями и атрибутами, включая указание ключей, список атрибутов, сгруппированных по сущностям, список связей между сущностями, возможность форматирования отчета, составления отчета по выделенной части схемы, передачи отчета, например, в другие приложения (текстовые процессоры));
· разработка графической схемы БД для конкретной СУБД с учетом специфичных для нее структур данных и ограничений (выбор целевой СУБД и реализация элементов схемы - ввод и модификация имен таблиц и столбцов, определение типов данных, доменов, индексов, значений по умолчанию и неопределенных значений, порядка индексирования, а также задание ограничений ссылочной целостности и дополнительных бизнес-правил, характеризующих предметную область, управление триггерами и хранимыми процедурами);
· формирование отчета о схеме БД (печать диаграммы схемы, списка таблиц с соответствующими столбцами, первичными ключами, индексами и т.д., возможность форматирования отчета, составления отчета по выделенной части схемы, передачи отчета в другие приложения);
· генерация схемы БД (трансформация схемы БД в файл DDL в текстовом формате или непосредственный интерфейс с целевой СУБД);
· разработка простейшего приложения (описание экранных форм, программирование или описание логики приложения и интерфейса с БД, загрузка БД тестовыми данными и тестирование приложения);
· сопровождение схем БД (внесение изменений - создание новых сущностей и атрибутов, изменение схемы БД, повторная генерация схемы, управление версиями, обеспечение сохранности данных, синхронизация концептуальной схемы и самой БД);
· обратное проектирование - реинжиниринг (полное и точное восстановление исходной концептуальной схемы по файлам DDL или непосредственно из словаря целевой СУБД).
В результате выполненного анализа может оказаться, что ни одно доступное средство не удовлетворяет в нужной мере всем основным критериям и не покрывает все потребности проекта. В этом случае может применяться набор средств, позволяющий построить на их базе единую технологическую среду.
Анализ средств проектирования информационных систем
Современные СП могут быть разделены на две большие категории. Первую составляют CASE- системы (как независимые (upper CASE), так и интегрированные с СУБД), обеспечивающие проектирование БД и приложений в комплексе с интегрированными средствами разработки приложений "клиент-сервер" (например, Westmount I-CASE+Uniface, Designer/2000+Developer/2000). Их основное достоинство заключается в том, что они позволяют разрабатывать всю ИС целиком (функциональные спецификации, логику процессов, интерфейс с пользователем и базу данных), оставаясь в одной технологической среде. Инструменты этой категории, как правило, обладают существенной сложностью, широкой сферой применения и высокой гибкостью. Вторую категорию составляют собственно средства проектирования БД, реализующие ту или иную методологию, как правило, "сущность-связь" ("entity-relationship") и рассматриваемые в комплексе со средствами разработки приложений. К средствам этой категории можно отнести такие, как SILVERRUN+JAM, ERwin/ERX+PowerBuilder и др. Помимо указанных категорий, СП можно классифицировать по следующим признакам:
· степени интегрированности: (отдельные локальные средства, набор частично интегрированных средств, охватывающих большинство этапов жизненного цикла ИС и полностью интегрированные средства, связанные общей базой проектных данных - репозиторием);
· применяемым методологиям и моделям систем и БД;
· степени интегрированности с СУБД;
· степени открытости;
· доступным платформам.
В разряд СП попадают как относительно дешевые системы для персональных компьютеров (ПК) с весьма ограниченными возможностями, так и дорогостоящие системы для неоднородных вычислительных платформ и операционных сред. Так, современный рынок программных средств насчитывает около 300 различных CASE-систем, наиболее мощные из которых так или иначе используются практически всеми ведущими западными фирмами. Применение СП требует от потенциальных пользователей специальной подготовки и обучения. Опыт показывает, что внедрение СП осуществляется медленно, однако по мере приобретения практических навыков и общей культуры проектирования эффективность применения этих средств резко возрастает, причем наибольшая потребность в использовании СП испытывается на начальных этапах разработки, а именно на этапах анализа и спецификации требований. Это объясняется тем, что цена ошибок, допущенных на начальных этапах, на несколько порядков превышает цену ошибок, выявленных на более поздних этапах разработки. На сегодняшний день Российский рынок программного обеспечения располагает следующими наиболее развитыми СП:
· Westmount I-CASE;
· Uniface;
· Designer/2000+Developer/2000 (ORACLE);
· SILVERRUN+JAM;
· ERwin/ERX+PowerBuilder.
Приведенный список не претендует на полноту. Кроме того, на рынке постоянно появляются как новые (для отечественных пользователей) системы, так и новые версии и модификации перечисленных систем (например, CASE/4/0, System Architect и т.д.). Некоторое представление о возможностях наиболее развитых СП может дать краткая характеристика следующих программных продуктов:
Westmount I-CASE 3.2 (CADRE Technologies Inc.).
Westmount I-CASE представляет собой интегрированный программный продукт, обеспечивающий выполнение следующих функций:
· графическое проектирование архитектуры системы (проектирование состава и связи вычислительных средств, распределения задач системы между вычислительными средствами, моделирование отношений типа "клиент- сервер", анализ использования мониторов транзакций и особенностей функционирования систем в реальном времени);
· проектирование диаграмм потоков данных, "сущность-связь", структур данных, структурных схем программ и последовательностей экранных форм;
· генерация кода программ на 4GL целевой СУБД с полным обеспечением программной среды и генерация SQL-кода для создания таблиц БД, индексов, ограничений целостности и хранимых процедур;
· программирование на языке C со встроенным SQL;
· управление версиями и конфигурацией проекта;
· генерация проектной документации по стандартным и индивидуальным шаблонам;
· экспорт и импорт данных проекта в формате CDIF.
Westmount I-CASE можно использовать в конфигурации "клиент-сервер", при этом база проектных данных может располагаться на сервере, а рабочие места разработчиков могут быть клиентами. Westmount I-CASE функционирует на всех основных UNIX-платформах и VMS. В качестве целевой СУБД могут использоваться ORACLE, Informix, Sybase и Ingres. В качестве отдельного продукта поставляется интерфейс Westmount-Uniface Bridge, обеспечивающий совместное использование двух систем в рамках единой технологической среды проектирования (при этом схемы БД, структурные схемы программ и последовательности экранных форм непосредственно в режиме on-line, без создания каких-либо файлов экспорта- импорта, переносятся в репозиторий Uniface, и, наоборот, прикладные модели, сформированные средствами Uniface, могут быть перенесены в репозиторий Westmount I-CASE. Возможные рассогласования между репозиториями двух систем устраняются с помощью специальной утилиты). В рамках версии Westmount I-CASE 4.0 предполагается обеспечить возможность функционирования клиентской части в среде Windows 95, а серверной - в среде Windows NT.
Uniface (Compuware).
Uniface 6.1 представляет собой среду разработки крупномасштабных приложений "клиент-сервер" и имеет следующую компонентную архитектуру:
· Application Objects Repository (репозиторий объектов приложений) содержит метаданные, автоматически используемые всеми остальными компонентами на протяжении жизненного цикла ИС.
· Application Model Manager поддерживает прикладные модели, каждая из которых представляет собой подмножество общей схемы БД с точки зрения данного приложения.
· Rapid Application Builder - средство быстрого создания экранных форм и отчетов на базе объектов прикладной модели. Оно включает графический редактор форм, средства прототипирования, отладки, тестирования и документирования. Реализован интерфейс с разнообразными типами оконных элементов управления (Open Widget Interface) для существующих графических систем - MS Windows (включая VBX), Motif, OS/2.
· Developer Services (службы разработчика) - используются для поддержки крупных проектов и реализуют контроль версий, права доступа, глобальные модификации и т.д. Это обеспечивает разработчиков средствами параллельного проекти-рования, входного и выходного контроля, поиска, просмотра, поддержки и выдачи отчетов по данным системы контроля версий.
· Deployment Manager (управление распространением приложений) - средства, позволяющие подготовить созданное приложение для распространения, установить и сопровождать его (при этом платформа пользователя может отличаться от платформы разработчика). В их состав входят сетевые драйверы и драйверы СУБД, сервер приложений (полисервер), средства распространения приложений и управления базами данных. Uniface поддерживает интерфейс практически со всеми известными программно- аппаратными платформами, СУБД, CASE-средствами, сетевыми протоколами и менеджерами транзакций.
· Personal Series (персональные средства) - используются для создания сложных запросов и отчетов в графической форме, а также для переноса данных в такие системы, как WinWord и Excel.
В качестве примера можно привести результаты предварительного анализа перечисленных выше СП, которые сведены в краткую таблицу характеристик, приведенную ниже. Таблица характеристик СП
СП West-mount I-CASE + Uniface. Designer/2000+Developer/2000. SILVER-RUN + JAM. ERwin/ERX + PowerBuilder. Поддержка полного жизненного цикла ИС + + + + Обеспечение целостности проекта + + - - Независимость от платформы + (ORACLE, Informix, Sybase, Ingres и др., dbf-файлы). - (целевая СУБД - только ORACLE). + (ORACLE, Informix, Sybase, Ingres и др.). + (ORACLE, Informix, Sybase, поддержка ODBC). Одновременная групповая разработка БД и приложений + - *) - *) - *)
*) разработчики приложений могут начинать работу с базой данных только после завершения ее проектирования. Анализ данных, приведенных в таблице, показывает, что из перечисленных СП только комплекс Westmount I-CASE+Uniface наиболее полно удовлетворяет всем критериям, принятым в качестве основных. Так, например, в комплексе Westmount I-CASE+Uniface целостность базы проектных данных и единая технология сквозного проектирования ИС обеспечивается за счет использования интерфейса Westmount-Uniface Bridge. Следует отметить, что каждый из двух продуктов сам по себе является одним из наиболее мощных в своем классе. Таким образом, наиболее развитыми средствами разработки крупномасштабных ИС на сегодняшний день является, по мнению автора, комплекс Westmount I-CASE+Uniface. С другой стороны, его применение не исключает использования в том же самом проекте таких средств, как PowerBuilder, для разработки сравнительно небольших прикладных систем в среде MS Windows.
©Drkb::02456.
| Обзор сети (типа Network Neighborhood). |
Обзор сети (типа Network Neighborhood).
Пример может служить отправной точкой для создания рабочего варианта.
Code: Unit netres_main_unit; Interface. Uses. Windows, messages, sysutils, classes, graphics, controls, forms, Dialogs, comctrls, stdctrls, buttons, menus, extctrls; Type. Tfrmmain = class(tform). Tvresources: ttreeview; Btnok: tbitbtn; Btnclose: tbitbtn; Label1: tlabel; Barbottom: tstatusbar; Popresources: tpopupmenu; Mniexpandall: tmenuitem; Mnicollapseall: tmenuitem; Mnisavetofile: tmenuitem; Mniloadfromfile: tmenuitem; Grplisttype: tradiogroup; Grpresourcetype: tradiogroup; Dlgopen: topendialog; Dlgsave: tsavedialog; Procedure formcreate(sender: tobject); Procedure btncloseclick(sender: tobject); Procedure formshow(sender: tobject); Procedure mniexpandallclick(sender: tobject); Procedure mnicollapseallclick(sender: tobject); Procedure mnisavetofileclick(sender: tobject); Procedure mniloadfromfileclick(sender: tobject); Procedure btnokclick(sender: tobject); Private. Listtype, resourcetype: dword; Procedure showhint(sender: tobject); Procedure doenumeration; Procedure doenumerationcontainer(netrescontainer: tnetresource); Procedure addcontainer(netres: tnetresource); Procedure addshare(topcontainerindex: integer; netres: tnetresource); Procedure addsharestring(topcontainerindex: integer; itemname: string); Procedure addconnection(netres: tnetresource); End; Var. Frmmain: tfrmmain; Implementation. {$r *.dfm}. Procedure tfrmmain.showhint(sender: tobject); Begin. Barbottom.panels.items[0].text := application.hint; End; Procedure tfrmmain.formcreate(sender: tobject); Begin. Application.onhint := showhint; Barbottom.panels.items[0].text := ''; End; Procedure tfrmmain.btncloseclick(sender: tobject); Begin. Close; End; { Перечисляем все сетевые ресурсы }. Procedure tfrmmain.doenumeration; Var. Netres: array[0..2] of tnetresource; Loop: integer; R, henum, entrycount, netreslen: dword; Begin. Case grplisttype.itemindex of. { Подключенные ресурсы: }. 1: listtype := resource_connected; { Возобновляемые ресурсы: }. 2: listtype := resource_remembered; { Глобальные: }. Else listtype := resource_globalnet; End; Case grpresourcetype.itemindex of. { Дисковые ресурсы: }. 1: resourcetype := resourcetype_disk; { Принтерные ресурсы: }. 2: resourcetype := resourcetype_print; { Все: }. Else resourcetype := resourcetype_any; End; Screen.cursor := crhourglass; Try. { Удаляем любые старые элементы из дерева }. For loop := tvresources.items.count - 1 downto 0 do. Tvresources.items[loop].delete; Except. End; { Начинаем перечисление: }. R := wnetopenenum(listtype, resourcetype, 0, nil, henum); If r <> no_error then begin. If r = error_extended_error then. Messagedlg('Невозможно сделать обзор сети.' + #13. + 'Произошла сетевая ошибка.', mterror, [mbok], 0). Else. Messagedlg('Невозможно сделать обзор сети.', mterror, [mbok], 0); Exit; End; Try. { Мы получили правильный дескриптор перечисления; опрашиваем ресурсы }. While (1 = 1) do begin. Entrycount := 1; Netreslen := sizeof(netres); R := wnetenumresource(henum, entrycount, @netres, netreslen); Case r of. 0: begin { Это контейнер, организуем итерацию: }. If netres[0].dwusage = resourceusage_container then. Doenumerationcontainer(netres[0]). Else { Здесь получаем подключенные и возобновляемые ресурсы }. If listtype in [resource_remembered, resource_connected] then. Addconnection(netres[0]); End; Error_no_more_items: { Получены все ресурсы: }. Break; Else begin { Другие ошибки: }. Messagedlg('Ошибка опроса ресурсов.', mterror, [mbok], 0); Break; End; End; End; Finally. Screen.cursor := crdefault; { Закрываем дескриптор перечисления: }. Wnetcloseenum(henum); End; End; { Перечисление заданного контейнера. Эта функция обычно вызывается рекурсивно }. Procedure tfrmmain.doenumerationcontainer(netrescontainer: tnetresource); Var. Netres: array[0..10] of tnetresource; Topcontainerindex: integer; R, henum, entrycount, netreslen: dword; Begin. { Добавляем имя контейнера к найденным сетевым ресурсам }. Addcontainer(netrescontainer); { Делаем этот элемент текущим корневым уровнем }. Topcontainerindex := tvresources.items.count-1; { Начинаем перечисление: }. If listtype = resource_globalnet then. { Перечисляем глобальные объекты сети: }. R := wnetopenenum(listtype, resourcetype, resourceusage_container, @netrescontainer, henum). Else. { Перечисляем подключаемые и возобновляемые ресурсы. (другие получить здесь невозможно) }. R := wnetopenenum(listtype, resourcetype, resourceusage_container, nil, henum); { Невозможно перечислить ресурсы данного контейнера, выводим соответствующее. Предупреждение и едем дальше }. If r <> no_error then begin. Addsharestring(topcontainerindex, '<Не могу опросить ресурсы (Ошибка #' + inttostr(r) + '>'); Wnetcloseenum(henum); Exit; End; { Мы получили правильный дескриптор перечисления; опрашиваем ресурсы }. While (1 = 1) do begin. Entrycount := 1; Netreslen := sizeof(netres); R := wnetenumresource(henum, entrycount, @netres, netreslen); Case r of. 0: begin { Другой контейнер для перечисления, Необходим рекурсивный вызов }. If (netres[0].dwusage = resourceusage_container). Or (netres[0].dwusage=10) then. Doenumerationcontainer(netres[0]). Else. Case netres[0].dwdisplaytype of. { Верхний уровень }. Resourcedisplaytype_generic, Resourcedisplaytype_domain, Resourcedisplaytype_server: addcontainer(netres[0]); { Ресурсы общего доступа: }. Resourcedisplaytype_share: Addshare(topcontainerindex, netres[0]); End; End; Error_no_more_items: break; Else begin. Messagedlg('Ошибка #' + inttostr(r) + ' при перечислении ресурсов.', Mterror, [mbok], 0); Break; End; End; End; { Закрываем дескриптор перечисления }. Wnetcloseenum(henum); End; Procedure tfrmmain.formshow(sender: tobject); Begin. Doenumeration; End; { Добавляем элементы дерева; помечаем, что это контейнер }. Procedure tfrmmain.addcontainer(netres: tnetresource); Var. Itemname: string; Begin. Itemname := trim(string(netres.lpremotename)); If trim(string(netres.lpcomment))<>'' then begin. If itemname <> '' then itemname := itemname + ' '; Itemname := itemname + '(' + string(netres.lpcomment) + ')'; End; Tvresources.items.add(tvresources.selected,itemname); End; { Добавляем дочерние элементы к контейнеру, обозначенному как текущий. Верхний уровень }. Procedure tfrmmain.addshare(topcontainerindex: integer; netres: tnetresource); Var. Itemname: string; Begin. Itemname := trim(string(netres.lpremotename)); If trim(string(netres.lpcomment)) <> '' then begin. If itemname <> '' then itemname := itemname + ' '; Itemname := itemname + '(' + string(netres.lpcomment) + ')'; End; Tvresources.items.addchild(tvresources.items[topcontainerindex], itemname); End; { Добавляем дочерние элементы к контейнеру, обозначенному как текущий верхний. Уровень; это просто добавляет строку для таких задач, как, например, перечисление. Контейнера. То есть некоторые контейнерные ресурсы общего доступа нам не. Доступны. }. Procedure tfrmmain.addsharestring(topcontainerindex: integer; itemname: string); Begin. Tvresources.items.addchild(tvresources.items[topcontainerindex], itemname); End; { Добавляем соединения к дереву. По большому счету, к этому моменту все сетевые. Ресурсы типа возобновляемых и текущих соединений уже отображены. }. Procedure tfrmmain.addconnection(netres: tnetresource); Var. Itemname: string; Begin. Itemname := trim(string(netres.lplocalname)); If trim(string(netres.lpremotename)) <> '' then begin. If itemname <> '' then itemname := itemname + ' '; Itemname := itemname + '-> ' + trim(string(netres.lpremotename)); End; Tvresources.items.add(tvresources.selected, itemname); End; { Раскрываем все контейнеры дерева }. Procedure tfrmmain.mniexpandallclick(sender: tobject); Begin. Tvresources.fullexpand; End; { Схлопываем все контейнеры дерева }. Procedure tfrmmain.mnicollapseallclick(sender: tobject); Begin. Tvresources.fullcollapse; End; { Записываем дерево в выбранный файл }. Procedure tfrmmain.mnisavetofileclick(sender: tobject); Begin. If dlgsave.execute then tvresources.savetofile(dlgsave.filename); End; { Загружаем дерево из выбранного файла }. Procedure tfrmmain.mniloadfromfileclick(sender: tobject); Begin. If dlgopen.execute then tvresources.loadfromfile(dlgopen.filename); End; { Обновляем }. Procedure tfrmmain.btnokclick(sender: tobject); Begin. Doenumeration; End; End.
| Область данных диаграммы |
Область данных диаграммы
Данные для построения диаграммы должны быть расположены на любом листе рабочей книги и представлять собой прямоугольную область. Для определения рабочей области данных используется метод SetSourceData, первый аргумент которого - ссылка на лист и область ячеек, второй - определяет способ использования данных (по строкам/столбцам).
Code: Function SetSourceData(Name,Sheet:variant; Range:string;XlRowCol:integer):boolean; Begin. SetSourceData:=true; Try. E.ActiveWorkbook.Charts.Item[name].SetSourceData. (Source:=E.ActiveWorkbook.Sheets.Item [Sheet].Range[Range],PlotBy:=XlRowCol); Except. SetSourceData:=false; End; End;
| Область диаграммы |
Область диаграммы
Если диаграмма расположена на одном листе с данными, то можно изменять координаты и размеры области диаграммы. Диаграмма может быть размещена также на отдельном листе, тогда ее размеры совпадают с размером листа. Для доступа к координатам и размерам этой области используем объект ChartArea (область диаграммы). Функция PositionChart изменяет ее координаты и размеры. Аналогично мы можем получить координаты и размеры диаграммы. Для этого достаточно считать значения Left, Top, Width и Height объекта ChartArea.
Code: Function PositionChart(Name:variant; Left,Top,Width,Height:real):boolean; Begin. PositionChart:=true; Try. E.Charts.Item[name].ChartArea.Left:=Left; E.Charts.Item[name].ChartArea.Top:=Top; E.Charts.Item[name].ChartArea.Width:=Width; E.Charts.Item[name].ChartArea.Height:=Height; Except. PositionChart:=false; End; End;
| Область построения диаграммы |
Область построения диаграммы
Область построения диаграммы служит для размещения графического изображения. Она имеет координаты относительно области диаграммы и другие свойства, присущие области: цвет и стиль рамки, цвет заливки и фоновый рисунок. Для доступа к ее координатам и размерам используем объект PlotArea (область построения диаграммы), который содержит все свойства области. Функция PositionPlotArea изменяет ее координаты и размеры.
Code: Function PositionPlotArea(Name:variant; Left,Top,Width,Height:real):boolean; Begin. PositionPlotArea:=true; Try. E.Charts.Item[name].PlotArea.Left:=Left; E.Charts.Item[name].PlotArea.Top:=Top; E.Charts.Item[name].PlotArea.Width:=Width; E.Charts.Item[name].PlotArea.Height:=Height; Except. PositionPlotArea:=false; End; End;
Пакеты и язык управления заданиями.
| Пакеты и язык управления заданиями |
Язык Transact-SQL позволяет сгруппировать последовательность операторов в один пакет, который может выполняться либо интерактивно, либо как файл операционной системы. Пользователь может также использовать конструкции языка управления заданиями, имеющиеся в Transact-SQL, для построения программ из отдельных операторов.
В этой главе рассматриваются следующие темы:
· дается общий обзор пакетов и языка управления заданиями;
· приводятся правила для построения пакетов;
· показывается, как использовать язык управления заданиями.
Что такое пакеты и язык управления заданиями ?
До сих пор в данном руководстве рассматривались примеры, в которых выполнялся лишь один оператор. Пользователь задавал отдельные операторы, которые непосредственно выполнялись SQL Сервером с последующей выдачей результатов (интерактивный режим). Но SQL Сервер может выполнить по очереди сразу несколько операторов, объединенных в пакет (программу), как в интерактивном режиме, так и в пакетном режиме, когда задание хранится в виде файла.
Пакет (набор) SQL операторов заканчивается специальной командой, которая сообщает SQL Серверу о необходимости выполнения всех операторов в пакете. Такой командой в специальной утилите SQL Сервера isql является команда “go” (выполнить), которая указывается в отдельной строке. Более детально утилиты рассматриваются в справочном руководстве по утилитам SQL Сервера.
Вообще говоря, пакет может состоять из одного оператора, но обычно в пакет объединяются несколько операторов. Очень часто пакет хранится как файл операционной системы и затем вызывается на исполнение утилитой isql.
В языке Transact-SQL предусмотрены специальные ключевые слова, которые собственно и образуют язык управления заданиями и которые позволяют пользователю влиять на последовательность выполнения операторов. Команды языка управления можно использовать как в отдельных операторах, так и в пакетах, а также в сохраненных процедурах и триггерах.
Без команд управления отдельные SQL операторы выполняется последовательно в порядке их поступления. Исключение здесь составляют коррелированные запросы, которые обсуждались в главе 5 “Подзапросы: использование запросов внутри других запросов”. Команды управления позволяют изменять последовательность выполнения операторов в зависимости от получаемых результатов с помощью конструкций, используемых в языках программирования.
Такие конструкции, как if…else, предназначенная для ветвления по условию, и while, предназначенная для циклического выполнения, позволяют управлять последовательностью выполнения SQL операторов. Язык управления заданиями, включенный в Transact-SQL, по существу, превращает стандартный SQL в язык программирования очень высокого уровня.
Правила составления пакетов
В пакет можно включать только определенные SQL операторы. При составлении пакетов следует придерживаться следующих правил:
· Следующие команды нельзя включать в пакет вместе с другими операторами: creat procedure (создать процедуру), creat rule (создать правило), creat default (создать значение по умолчанию), creat trigger (создать триггер), creat view (создать вьювер);
· Следующие команды можно включать в пакет: creat database (можно создать базу данных, но из того же пакета нельзя обращаться к ее объектам), creat table (создать таблицу), creat index (создать индекс);
· Правила и умолчания можно связывать со столбцами, но нельзя сразу использовать в одном и том же пакете. Например, вызов процедур sp_bindrule (присоединить правило) и sp_bindefault (присоединить значение по умолчанию) нельзя располагать в одном пакете с оператором insert, который использует эти правила и умолчания;
· Команда use (использовать базу данных) должна содержаться в пакете, который выполняется перед пакетом, в котором располагаются операторы, обращающиеся к объектам этой базы;
· Нельзя выполнить команду drop (удалить), а затем вновь создать тот же объект в этом же пакете;
· Все опции, установленные в пакете с помощью команды set (установить), начинают действовать только после окончания выполнения этого пакета. Можно включить команду set и запросы к таблицам в один пакет, но опции, установленные этой командой, не будут действовать во время выполнения этих запросов.
Примеры использования пакетов
В этом разделе приводятся примеры, иллюстрирующие использование пакетов с утилитой isql, которая имеет специальную команду “go” для запуска пакета на исполнение. В следующий пакет включены два оператора выбора:
Select count(*) from titles.
Select count(*) from authors.
Go.
---------------------
18.
----------------------
23.
(Выбрана 1 строка).
Можно в одном пакете создать таблицу и сразу обратиться к ней. В следующем примере пакета создается таблица, затем в нее вставляется строка, после чего эта строка выбирается из таблицы:
Create table test.
(column1 char(10), column2 int).
Insert test.
Values ("hello", 598).
Select * from test.
Go.
(Выбрана 1 строка).
Column1 column2.
-------- ---------
Hello 598.
(Выбрана 1 строка).
Команда creat view (создать вьювер) должна быть единственной командой в пакете. В следующем пакете, состоящем из одного оператора, создается вьювер:
Creat view testview as.
Select column1 from test.
Go.
Команду use можно включать в пакет вместе с другими операторами, если эти операторы обращаются к базе данных, которая была текущей перед вызовом пакета. В следующем примере происходит выборка из таблицы базы данных master, а затем открывается база данных pubs2. Здесь предполагается, что база данных master была текущей перед вызовом пакета. После выполнения этого пакета текущей становится база данных pubs2.
Select count(*) from sysdatabase.
Use pubs2.
Go.
------------------
9.
(Выбрана 1 строка).
Команду drop (удалить объект) можно включать в пакет вместе с другими операторами, если в том же пакете уже не нужно будет обращаться к удаляемому объекту или вновь создавать его. В следующем примере показан пакет, состоящий из оператора drop и оператора select:
Drop table test.
Select count(*) from titles.
Go.
----------------------
18.
(Выбрана 1 строка).
Если в пакете где-нибудь имеется синтаксическая ошибка, то в нем не будет выполнен ни один оператор. Например, в следующем пакете имеется опечатка в последнем операторе, поэтому в результате появляется сообщение об ошибке:
Select count(*) from titles.
Select count(*) from authors.
Slect count(*) from publishers.
Go.
Msg 156, Level 15, State 1:
SQL Server 'MAGOO', LIne 3:
Incorrect syntax near the keyword 'count'. (Неправильная команда около слова ‘count’).
Пакеты, в которых нарушены правила их составления, также вызывают сообщение об ошибке. Далее приводятся примеры неправильных пакетов:
Create table test.
(column1 char(10), column2 int).
Insert test.
Values ("hello", 598).
Select * from test.
Create view testview as select column1 from test.
Go.
Msg 111, Level 15, State 3:
Server 'hq', Line 6:
CREATE VIEW must be the first command in a query batch. (Команда создания вьювера должна быть первой в пакете.).
Create view testview as select column1 from test.
Insert testview values ("goodbye").
Go.
Msg 127, Level 15, State 1:
Server 'hq', Procedure 'testview', Line 3:
This CREATE may only contain 1 statement. (Команда создания вьювера должна быть единственной в пакете.).
Следующий пакет будет работать только в том случае, если текущей базой данных будет база данных, указанная в операторе use. Если же он будет запущен из другой базы данных, например master, то будет выдано сообщение об ошибке.
Use pubs2.
Select * from titles.
Go.
Msg 208, Level 16, State 1:
Server 'hq', Line 2:
Invalid object name 'titles'. (Неправильный объект 'titles'.).
Drop table test.
Create table test.
(column1 char(10), column2 int).
Go.
Msg 2714, Level 16, State 1:
Server 'hq', Line 2:
There is already an object named 'test' in the database.
(В базе данных уже имеется объект с названием 'test'.).
Пакетные файлы
Пакет можно сохранить в виде файла операционной системы, а затем вызвать его на исполнение утилитой isql. Файл может содержать несколько пакетов, каждый из которых заканчивается ключевым словом “go”.
Например, следующий файл содержит три пакета:
Use pubs2.
Go.
Select count(*) from titles.
Select count(*) from authors.
Go.
Create table test.
(column1 char(10), column2 int).
Insert test.
Values ("hello", 598).
Select * from test.
Go.
При выполнении этого файла утилитой isql получаются следующие результаты:
-------------
18.
(Выбрана 1 строка).
-------------
23.
(Выбрана 1 строка).
(Выбрана 1 строка).
Column1 column2.
--------- ---------
Hello 598.
(выбрана 1 строка).
В справочном руководстве по утилитам SQL Сервера в разделе об утилите isql приводится информация о зависимости выполнения пакетных файлов от операционного окружения (среды).
Язык управления заданиями
Команды языка управления заданиями можно использовать как в интерактивном режиме, так и в пакетном, а также в сохраненных процедурах. Ключевые слова языка управления заданиями и их значение приведены в следующей таблице:
Таблица 13-1: Ключевые слова языка управления заданиями.
Ключевое слово. Функциональное назначение. If. Определяет условное выполнение. …else. Определяет альтернативную ветвь выполнения, если условие, указанное в if ложно. Begin. Начало блока операторов. …end. Конец блока операторов. While. Циклическое выполнение операторов, пока условие, указанное в while истинно. Break. Принудительный выход из цикла. …continue. Повторить выполнение цикла while. Declare. Объявление локальной переменной. Goto label. Переход на метку (label), которая расположена в блоке операторов. Return. Безусловный выход. Waitfor. Установить задержку на выполнение команды. Print. Вывести на экран сообщение, которое указано пользователем или хранится в локальной переменной. Raiserror. Вывести на экран сообщение об ошибке, указанное пользователем или хранящееся в локальной переменной, и установить глобальную переменную @@error (ошибка). /* comment */ Внести комментарий (комментарий можно указать в любом месте SQL оператора).
Условный оператор if…else
Ключевое слово if (если), независимо от своего дополнения else (иначе), служит для указания условия, которое определяет нужно ли выполнять следующий оператор. Следующий оператор выполняется, если это условие истинно, т.е. если его значение равно TRUE (истина).
Ключевое слово else служит для указания альтернативного SQL оператора, который выполняется, если условие, указанное в конструкции if оказалось ложным (FALSE).
Условный оператор имеет следующий синтаксис:
If булевское_выражение.
Оператор.
[else [if булевское_выражение].
Оператор ].
Булевское выражение это выражение, значением которого является истина (TRUE) или ложь (FALSE). Оно может состоять из названий табличных столбцов и констант, соединенных арифметическими или булевскими операциями, или подзапросов, если эти подзапросы возвращают одно (скалярное) значение. Если булевское выражение содержит оператор выбора select, то этот оператор должен быть заключен в скобки и должен возвращать скалярное (невекторное) значение.
Далее приводится пример условного оператора, который содержит только условие if и одну команду:
If exists (select postalcode from authors.
Where postalcode = '94705').
Print "Berkeley author".
В этом примере будет выводиться сообщение “Berkeley author”, если почтовые индексы некоторых авторов из таблицы authors равны “94705”. Оператор выбора в этом примере возвращает скалярное значение, которое равно либо TRUE либо FALSE, поскольку перед ним указано ключевое слово exists (существует). Ключевое слово exists действует здесь точно также, как и в подзапросах (см. главу 5 “Подзапросы: использование запросов внутри других запросов”).
В следующем примере используются оба ключевых слова if и else. Здесь проверяется наличие объектов, созданных пользователями, которым присваиваются идентификационные номера, большие 50. Если такие объекты существует, то они выбираются из таблицы в конструкции else и для каждого из них указывается название, тип и номер.
If (select max(id) from sysobjects) < 50.
Print "There are no user-created objects in this database.".
Else.
Select name, type, id from sysobjects.
Where id > 50 and type = "U".
(Выбрана 1 строка).
Name type id.
------------ --------------
Authors U 1088006907.
Publishers U 1120007021.
Roysched U 1152007135.
Sales U 1184007249.
Titleauthor U 1216007363.
Titles U 1248007477.
Stores U 1280007591.
Discounts U 1312007705.
Test U 1648008902.
(Выбрано 9 строк).
Условный оператор часто используется в сохраненных процедурах для проверки наличия некоторого параметра.
Условие проверки может указываться внутри другого условия либо в части if либо в части else. Условие проверки должно иметь скалярное значение. В каждой части условного оператора может быть только по одному SQL оператору. Чтобы указать несколько SQL операторов, необходимо использовать операторные скобки begin…end. Максимальное число вложенных друг в друга условий проверки if зависит от сложности операторов выбора (или других языковых конструкций), которые используются в условном операторе.
Операторные скобки begin…end
Ключевые слова begin и end используются как операторные скобки для выделения единого блока операторов, который может использоваться, например, в условном операторе. Последовательность операторов, заключенная в скобки begin и end, называется операторным блоком.
Конструкция begin…end имеет следующий вид:
Begin.
Блок операторов.
End.
Рассмотрим следующий пример:
If (select avg(price) from titles) < $15.
Begin.
Update titles.
Set price = price * 2.
Select title, price.
From titles.
Where price > $28.
End.
В этом примере без ключевых слов begin и end условие if относилось бы только к первому SQL оператору этого блока. Второй и последующие операторы выполнялись бы независимо от выполнения этого условия.
Операторный блок begin…end можно включать внутрь другого операторного блока begin…end.
Циклический оператор while и команды break…continue
Команда while (до тех пор, пока) используется для циклического (повторного) выполнения оператора или блока операторов. Операторы выполнятся до тех пор, пока истинно указанное условие.
Эта команда имеет следующий вид:
While булевское_выражение.
Оператор.
В следующем примере операторы select и update будут выполняться в цикле, пока средняя цена книги будет меньше $30:
While (select avg(price) from titles) < $30.
Begin.
Select title_id, price.
From titles.
Where price > $20.
Update titles.
Set price = price * 2.
End.
(Выбрано 0 строк).
Title_id price.
------ -------
PC1035 22.95.
PS1372 21.59.
TC3218 20.95.
(Выбрано 3 строки).
(Выбрано 10 строк).
(Выбрано 0 строк).
Title_id price.
------ -------
BU1032 39.98.
BU1111 23.90.
BU7832 39.98.
MC2222 39.98.
PC1035 45.90.
PC8888 40.00.
PS1372 43.18.
PS2091 21.90.
PS3333 39.98.
TC3218 41.90.
TC4203 23.90.
TC7777 29.98.
(Выбрано 12 строк).
(Выбрано 18 строк).
(Выбрано 0 строк).
Команды break (прервать) и continue (продолжить) управляют последовательностью выполнения операторов внутри цикла while. Команда break прекращает выполнение цикла. После этого управление передается оператору, следующему за ключевым словом end, которое указывает на конец цикла. Команда continue передает управление на начало цикла, поэтому все операторы, расположенные внутри цикла и следующие за этой командой, выполняться не будут. Командам break и continue часто предшествует проверка некоторого условия.
Синтаксис команд break и continue имеет следующий вид:
While булевское_выражение.
Begin.
Оператор.
….
[оператор].
Break.
[оператор].
….
Continue.
….
[оператор].
End.
Далее приводится пример использования команд while, break, continue и if, в котором производится действие, обратное инфляционному действию предыдущего примера. До тех пор пока средняя цена книги остается большей $20, все цены уменьшаются наполовину. Затем выбирается максимальная цена. Если она меньше 40 долларов, то происходит выход из цикла, в противном случае цикл выполняется снова. Команда continue не допустит выполнение оператора вывода (печати) print, если средняя цена меньше $20. После окончания цикла while в этом примере выводится список самых дорогих книг и информационное сообщение "Not Too Expensive" (Не очень дорого).
While (select avg(price) from titles) > $20.
Begin.
Update titles.
Set price = price / 2.
If (select max(price) from titles) < $40.
Break.
Else.
If (select avg(price) from titles) < $20.
Continue.
Print "Average price still over $20".
End.
Select title_id, price from titles.
Where price > $20.
Print "Not Too Expensive".
Average price still over $20.
Title_id price.
-------- -------
PC1035 22.95.
PS1372 21.59.
TC3218 20.95.
(Выбрано 3 строки).
Not Too Expensive.
Если циклы while вложены друг в друга, то команда break возвращает управление в наименьший внешний цикл, который содержит данный цикл. После этого возобновляется выполнение этого внешнего цикла с самого начала.
Оператор declare и локальные переменные
Переменная - это объект, которому присваивается некоторое значение. Это значение может изменяться в процессе исполнения пакета или сохраненной процедуры, в которых используется эта переменная. У SQL Сервера имеется два вида переменных: локальные и глобальные. Локальные переменные определяются пользователем, в то время как глобальные переменные являются системными и определяются заранее.
Для задания локальных переменных используется ключевое слово declare (объявить), после которого следует указать название переменной, ее тип. После этого переменной можно присвоить начальное значение с помощью оператора выбора. Локальные переменные можно использовать только в том пакете или процедуре, в которых они объявлены.
Локальные переменные часто используются в пакетах или процедурах как счетчики циклов в операторе while, а также внутри операторного блока if…else. Когда переменные используются в сохраненной процедуре, они должны быть объявлены как автоматические для неинтерактивного использования во время выполнения сохраненной процедуры.
Названия локальных переменных должны начинаться со знака “@” и отвечать правилам, установленным для идентификаторов. Для каждой локальной переменной нужно указать ее тип, который может быть задан пользователем или определяться системой, но не совпадать ни с одним из системных типов text, image, sysname.
Объявление локальных переменных имеет следующий вид:
Declare @название_переменной тип_данных.
[,@название_переменной тип_данных] …
После объявления переменной она имеет значение NULL. Чтобы присвоить ей значение следует использовать оператор выбора. Этот оператор имеет следующий синтаксис:
Select @название_переменной = { выражение | (оператор_выбора) }.
[, @название_переменной = { выражение | (оператор_выбора) } … ].
[from конструкция] [where конструкция] [group by конструкция].
[having конструкция] [order by конструкция] [compute конструкция].
Локальные переменные должны объявляться в том же пакете или процедуре, в которых они используются.
Оператор выбора, с помощью которого переменной присваивается значение обычно возвращает одно значение. Подзапрос, который возвращает значение для локальной переменной должен возвращать только одно значение. Далее приводятся несколько примеров присваивания значений переменным:
Declare @veryhigh money.
Select @veryhigh = max(price).
From titles.
If @veryhigh > $20.
Print "Ouch!".
Declare @one varchar(18), @two varchar(18).
Select @one = "this is one", @two = "this is two".
If @one = "this is one".
Print "you got one".
If @two = "this is two".
Print "you got two".
Else print "nope".
Declare @tcount int, @pcount int.
Select @tcount = (select count(*) from titles),
@pcount = (select count(*) from publishers).
Select @tcount, @pcount.
Если оператор выбора возвращает более одного значения, то переменной присваивается последнее возвращаемое значение.
С точки зрения эффективного использования памяти и времени лучше использовать оператор:
Select @a=1, @b=2, @c=3.
По сравнению с оператором:
Select @a=1.
Select @b=2.
Select @c=3.
То же правило применимо к оператору declare. Гораздо более эффективно выполняется оператор:
Declare @a int, @b char(20), @c float.
По сравнению с последовательностью операторов:
Declare @a int.
Declare @b char(20).
Declare @c float.
Оператор выбора, который присваивает значение локальной переменной, можно использовать только для этой цели. Его нельзя использовать для выборки данных из таблицы пользователя. В следующем примере первый оператор выбора присваивает значение локальноц переменной @veryhigh, но для вывода ее значения необходимо использовать второй оператор выбора:
Declare @veryhigh money.
Select @veryhigh = max(price).
From titles.
Select @veryhigh.
Если оператор выбора, который присваивает значение переменной, возвращает более одного значения, то переменной присваивается последнее возвращаемое значение. В следующем примере переменной присваивается последнее возвращаемое значение аванса из таблицы titles:
Declare @m money.
Select @m = advance from titles.
Select @m.
(Выбрано 18 строк).
------------------------
8,000.00.
(Выбрана 1 строка).
Заметим, что оператор выбора, присваивающий значение переменной, также выводит число строк, которые были при этом выбраны.
Если оператор выбора, присваивающий значение переменной, не возвращает никакого значения, то значение переменной не изменяется.
Локальные переменные могут использоваться как аргументы в командах print и raiserror.
Переменные и неопределенное значение
После объявления локальной переменной ей присваивается неопределенное значение NULL. Кроме того, это значение можно присвоить с помощью оператора выбора. Предусмотрены специальные правила сравнения неопределенных значений переменных с другими значениями.
В следующей таблице приведены результаты сравнения неопределенного значения, находящегося в столбце таблицы, с неопределенным значением выражения при выполнении различных операций сравнения. (Выражение может быть переменной, литералом или комбинацией переменных и литералов, соединенных арифметическими операциями).
Таблица 13-2: Сравнение неопределенных значений.
Операции =, !=, <> Операции <, >, <=, !<, !> Сравнение табличного_значения с табличным_значением. FALSE. FALSE. Сравнение табличного_значения с выражением. TRUE. FALSE. Сравнение выражения с табличным_значением. TRUE. FALSE. Сравнение выражения с выражением. TRUE. FALSE.
Например, в следующем примере только первое сравнение дает положительный результат:
Declare @v int, @i int.
If @v = @i select "null = null, true".
If @v > @i select "null > null, true".
-----------------
Null = null, true.
(Выбрана 1 строка).
В следующем примере из таблицы titles выбираются все строки, в которых значение аванса (advance) является неопределенным:
Declare @m money.
Select title_id, advance.
From titles.
Where advance = @m.
Title_id advance.
-------- ----------------
MC3026 NULL.
PC9999 NULL.
Оператор declare и глобальные переменные
Глобальные переменные являются заранее определенными системными переменными. Названия глобальных переменных отличаются от локальных двумя, расположенными впереди, знаками “@”, например, @@error.
В следующей таблице приводится список глобальных переменных.
Таблица 13-3: Глобальные переменные SQL Сервера.
Переменная. Значение. @@char_convert. Равна 0, если не установлено преобразование алфавитов (множества символов). Равна 1, если такое преобразование установлено. @@client_csname. Содержит название алфавита клиента. Равна NULL, если алфавит клиента никогда не инициализировался, в противном случае содержит название последнего использованного алфавита. @@client_csid. Содержит идентификатор алфавита клиента. Устанавливается в -1, если алфавит клиента никогда не инициализировался, в противном случае содержит идентификатор последнего использованного алфавита из таблицы syscharset. @@connections. Равна числу зарегистрированных входов в систему (logins) или попыток регистраций. @@cpu_busy. Равна времени (в тактах процессора) загрузки процессора задачами SQL Сервера, начиная с последнего старта SQL Сервера. @@error. Равна 0, если последняя транзакция была успешно выполнена. В противном случае, содержит последний номер ошибки, выданный системой. Эта переменная часто используется для проверки ошибок после исполнения последнего оператора. Оператор типа if @@error != 0 return используется для выхода при возникновении ошибки. @@identity. Содержит последний номер, записанный в столбец счетчика оператором insert или select into. Эта переменная изменяется при вставке каждой новой строки. Если оператор вставляет несколько строк, то данной переменной присваивается номер последней строки. Если в изменяемой таблице нет счетчика, то данной переменной присваивается 0. Значение этой переменной не меняется при ошибочном выполнении операторов вставки или при восстановлении транзакции, которая содержит эти операторы. Значение этой переменной не восстанавливается, даже если оператор, увеличивший ее, был ошибочным. @@idle. Равна количеству времени (в тактах процессора), в течении которого у SQL Сервера не было работы. @@io_busy. Равна количеству времени (в тактах процессора), в течении которого SQL Сервер выполнял операции ввода-вывода. @@isolation. Указывает на уровень изоляции Transact-SQL программы. Этот уровень может изменяться от 1 до 3. @@langid. Указывает на идентификатор текущего языка, который берется из таблицы идентификаторов syslanguges.langid. @@language. Указывает на название текущего языка, который берется из таблицы syslanguges.name. @@maxcharlen. Указывает на максимальную длину (в байтах) символа из мультибайтового алфавита. @@max_connections. Указывает на максимальное число соединений, которые могут быть установлены с SQL Сервером в данной вычислительной среде. Пользователь может установить любое число соединений, не превосходящее значения этой переменной, с помощью процедуры sp_configure ‘number of user connections’. @@ncharsize. Равно средней длине (в байтах) символа национального алфавита. @@nestlevel. Указывает на текущей уровень вложенности исполнения, который сначала равен нулю. При каждом вызове сохраненной процедуры или триггера из другой процедуры или триггера, уровень вложенности увеличивается на единицу. Если будет превзойден порог, равный 16, транзакция прерывается. @@pack_received. Указывает на число входных пакетов (packet), прочитанных SQL Сервером. @@pack_sent. Указывает на число выходных пакетов (packet), записанных SQL Сервером. @@pack_errors. Указывает на число ошибок, которые возникли во время получения или пересылки пакетов. @@procid. Содержит идентификатор выполняемой в данный момент сохраненной процедуры. @@rowcount. Указывает на число строк, которые обрабатывались в последнем запросе. Эта переменная устанавливается в ноль любой командой, которая не работает со строками, как например, оператор if. @@servername. Содержит название данного SQL Сервера. @@spid. Указывает серверный идентификатор текущего процесса. @@sqlstatus. Содержит информацию о состоянии, выданную последним оператором fetch (вызвать). @@textcolid. Содержит идентификатор столбца, на который ссылается текстовый указатель, хранящийся в глобальной переменной @@textptr. Эта переменная имеет тип tinyint. @@textdbid. Указывает идентификатор базы данных, которая содержит столбец, на который ссылается указатель, хранящийся в переменной @@textptr. Эта переменная имеет тип smallint. @@textobjid. Указывает идентификатор объекта, который содержит столбец, на который ссылается текстовый указатель переменной @@textptr. Эта переменная имеет тип int. @@textptr. Содержит текстовый указатель, который использовался при последнем обращении к тестовому или графическому столбцу. Эта переменная имеет тип binary(16). Не следует путать эту переменную с функцией textptr. @@textsize. Указывает на максимальное число байтов, которые можно выбрать из текстового или графического поля оператором select. Для утилиты isql по умолчанию это значение равно 32К, но значение, принимаемое по умолчанию, зависит от программного обеспечения клиента. Значение этой переменной для данной сессии можно установить командой set textsize. @@textts. Указывает на момент последнего обращения к текстовому столбцу, на который указывает переменная @@textptr. Эта переменная имеет тип varbinary(8). @@tresh_hysteresis. Указывает на минимально допустимую величину свободной памяти, после которой необходимо активизировать порог (threshold). Эта величина, известная также как величина гистерезиса (hysteresis), измеряется в страницах размера 2К. Она определяет насколько близко пороги могут быть расположены в сегменте базы данных. @@timeticks. Указывает длительность такта процессора в микросекундах. Эта величина, конечно, является машинно-зависимой. @@totalerrors. Указывает на общее число ошибок, возникших в процессе передачи данных SQL Сервером. @@total_read. Указывает на число чтений с диска, которые SQL Сервер выполнил со времени последнего старта. @@total_write. Указывает на число записей с диска, которые SQL Сервер выполнил со времени последнего старта. @@tranchained. Указывает на текущий режим транзакций Transact-SQL программы. Значение этой переменной равно 0, если установлен несвязный (unchained) режим и 1, если связный. @@trancount. Указывает число активных транзакций текущего пользователя. @@transtate. Указывает текущее состояние транзакции после выполнения оператора. Но в отличии от переменной @@error, эта переменная не очищается после выполнения каждого оператора. @@version. Указывает дату создания текущей версии SQL Сервера.
С помощью системной процедуры sp_monitor (монитор) можно получить информацию о многих из этих глобальных переменных. Полная информация о системных процедурах приводится в Справочном руководстве SQL Сервера.
Если пользователь объявляет локальную переменную, название которой совпадает с глобальной переменной, то эта переменная рассматривается как локальная.
Команда перехода goto
Команда goto (перейти на) вызывает безусловный переход на указанную пользователем метку. Эту команду перехода и метки можно использовать в пакетах и сохраненных процедурах. Название метки должно отвечать правилам, установленным для идентификаторов, и должно заканчиваться двоеточием, когда оно приводится впервые. Но двоеточие не нужно указывать, когда метка используется для ссылки в команде goto.
Эта команда имеет следующий вид:
Метка:
Goto метка.
Далее приводится пример использования меток и команды безусловного перехода, команды цикла while и локальной переменной, которая используется в качестве счетчика:
Declare @count smallint.
Select @count = 1.
Restart:
Print "yes".
Select @count = @count + 1.
While @count <=4.
Goto restart.
Как и в этом примере, команде перехода обычно предшествует проверка некоторого условия с помощью команд while или if, чтобы избежать появления бесконечного цикла между командой goto и меткой.
Команда выхода return
Команда return (возврат) предназначена для безусловного выхода из пакета или процедуры. Она может использоваться в любом месте пакета или процедуры. Когда она используется в сохраненной процедуре, то ее можно дополнить аргументом для возврата состояния вызывающей процедуре. Операторы, расположенные после оператора возврата, не исполняются.
Эта команда имеет следующий простой вид:
Return [int_выражение].
В следующем примере в сохраненной процедуре используется оператор return вместе с условным оператором и операторными скобками begin…end:
Create procedure findrules @nm varchar(30) = null as.
If @nm is null.
Begin.
Print "You must give a user name".
Return.
End.
Else.
Begin.
Select sysobjects.name, sysobjects.id, sysobjects.uid.
From sysobjects, master..syslogins.
Where master..syslogins.name = @nm.
And sysobjects.uid = master..syslogins.suid.
And sysobjects.type = "R".
End.
Если процедуре findrules (найти правила) не задается имя пользователя в качестве параметра, то команда return вызывает выход из процедуры после сообщения, выдаваемого на экран пользователя. Если имя задано, то из соответствующих системных таблиц выбираются все правила, принадлежащие данному пользователю.
По своему действию команда return аналогична команде break, которая используется для выхода из цикла.
Примеры возврата значений с помощью этой команды приводятся в главе 14 “Использование сохраненных процедур”.
Команда вывода print
Команда print (печатать), которая уже использовалась в предыдущих примерах, предназначена для вывода на экран сообщений пользователя или значений локальных переменных. Локальная переменная должна быть объявлена в том же пакете или процедуре, где она используется. Выводимое сообщение должно быть не длиннее 255 байт.
Эта команда имеет следующий вид:
Print {форматированная_строка_вывода | @локальная_переменная |
@@глобальная_переменная} [, список_аргументов].
Приведем пример использования этой команды:
If exists (select postalcode from authors.
Where postalcode = '94705').
Print "Berkeley author".
В следующем примере команда print используется для вывода значения локальной переменной:
Declare @msg char(50).
Select @msg = "What's up doc?".
Print @msg.
В команде print можно использовать форматные символы (placeholders). В выводимой строке можно указать до 20 таких символов, расположенных в любом порядке. Эти символы заменяются форматированными строками, указанными в списке аргументов, следующими за выводимой строкой, когда текст сообщения передается клиенту.
Форматные символы нумеруются, чтобы можно было изменить порядок следования аргументов, когда выводимая строка должна быть переведена на язык с другой грамматической структурой. Форматные символы для аргументов имеют следующий вид: %nn!. Вначале указывается символ процентов, за которым следует целое число от 1 до 20, заканчивающееся восклицательным знаком. Целое число указывает позицию соответствующего аргумента в строке на исходном языке. Например, “%1!” указывает на позицию первого аргумента в строке, “%2!” второго и т.д. Такое указание позиции аргумента позволяет корректно перевести фразу на различные языки, даже в том случае, когда при переводе необходимо изменить порядок слов.
Например, предположим, что выдается следующее сообщение на английском:
%1! is not allowed in %2!. (%1! не допускается в %2!.).
На немецком языке это сообщение будет выглядеть следующим образом:
%1! ist in %2! nicht zи1аssig.
В этом примере %1! во всех языках представляет собой один и тот же первый аргумент, а %2! второй аргумент. В этом примере также можно увидеть изменение расположения аргументов, когда фраза переводится на другой язык. Аргументы нужно нумеровать последовательно, хотя порядок расположения аргументов может и не соответствовать их порядковым номерам. Например, нельзя использовать 1 и 3 аргументы, когда в выводимой строке нет 2 аргумента.
Необязательный список_аргументов может быть последовательностью переменных и констант. Аргумент может иметь любой тип за исключением text (текстовый) и image (графический). Аргумент конвертируется в тип char (символьный) перед тем, как помещается в окончательное сообщение. Если аргументов нет, то исходная строка выводится в том виде, в каком она задана и в этом случае в ней не должны быть никаких форматных символов.
Максимальная длина выводимой строки с уже подставленными аргументами составляет 512 байт.
Команда raiserror
Команда raiserror (возникновение ошибки) выводит на экран пользователя сообщение об ошибке и устанавливает системный флаг, который фиксирует факт возникновения ошибки. Как и в команде print здесь в качестве сообщения может выступать значение локальной переменной, но в этом случае локальная переменная должна быть объявлена в том же пакете или процедуре, где она используется. Сообщение должно быть не длиннее 255 символов.
Команда raiserror имеет следующий вид:
Raiserror номер_ошибки.
[{форматированная_строка_вывода | @локальная_переменная }] [,список_аргументов].
[extended_value = extended_value [{, extended_value = extended_value }...]].
Номер_ошибки запоминается в глобальной переменной @@error, которая содержит последний номер системной или пользовательской ошибки, выданный SQL Сервером. Номера ошибок для сообщений, которые выдаются пользователями, должны быть больше 17000. Если номер_ошибки находится между 17000 и 19999 и выводимая строка отсутствует или пуста (“”), то SQL Сервер выбирает текст сообщения об ошибке из системной таблицы sysmessages базы данных master. Эти сообщения об ошибке используются главным образом системными процедурами.
Длина форматированной_строки_вывода самой по себе не должна превышать 255 байтов. Длина окончательного сообщения вместе с подставленными аргументами составляет 512 байтов. Локальные переменные используемые для вывода сообщения должны иметь тип char или varchar. Можно не указывать выводимую строку или локальную переменную. В этом случае SQL Сервер использует сообщение из таблицы sysusermessages, которое соответствует указанному номеру ошибки. Как и команде print здесь можно подставлять в выводимую строку значения констант или переменных, задав их в качестве аргументов.
В качестве опции можно определить дополнительные значения ошибки для использования в Open Client (открытый клиент) приложении. В этом случае в команду raiserror нужно включить конструкцию extended_value (дополнительное значение). Более детальную информацию о дополнительных значениях ошибки можно посмотреть в документации по Open Client приложениям или в разделе о команде raiserror в Справочном руководстве SQL Сервера.
Команду raiserror следует использовать вместо команды print, когда необходимо запомнить номер ошибки в переменной @@error. Например, в процедуре findrules можно было бы использовать следующее сообщение об ошибке:
Raiserror 99999 "You must give a user name" (Нужно указать имя пользователя).
Уровень строгости (severity) всех сообщений об ошибках, выдаваемых пользователями, равен 16. Этот уровень указывает, что у пользователя возникла нефатальная ошибка.
Сообщения пользователя в командах print и raiserror
Пользователь может выбирать сообщения из таблицы sysusermessages (системные сообщения пользователя) с помощью системной процедуры sp_getmassage (выдать сообщение) для их последующего использования в командах print или raiserror. Для записи сообщений в эту таблицу следует использовать системную процедуру sp_addmassage (добавить сообщение).
В следующем примере демонстрируется использование процедур sp_getmassage, sp_addmassage и команды print для записи сообщений в таблицу sysusermessages как на английском, так на немецком языке, с последующим их использованием в сохраненной процедуре и выводом на экран:
/*
** Install messages.
** First, the English (langid = NULL).
*/
Set language us_english.
Go.
Sp_addmessage 25001,
"There is already a remote user named '%1!' for remote server '%2!'.".
Go.
/* Then German*/
Sp_addmessage 25001,
"Remotebenutzername '%1!' existiert bereits auf dem Remoteserver '%2!'.","german".
Go.
Create procedure test_proc @remotename varchar(30),
@remoteserver varchar(30).
As.
Declare @msg varchar(255).
Declare @arg1 varchar(40).
/*
** check to make sure that there is not.
** a @remotename for the @remoteserver.
*/
If exists (select *
From master.dbo.sysremotelogins l,
Master.dbo.sysservers s.
Where l.remoteserverid = s.srvid.
And s.srvname = @remoteserver.
And l.remoteusername = @remotename).
Begin.
Exec sp_getmessage 25001, @msg output.
Select @arg1=isnull(@remotename,"null").
Print @msg, @arg1, @remoteserver.
Return (1).
End.
Return(0).
Go.
Команда waitfor
Команда waitfor (ожидать до) предназначена задержки исполнения блока операторов, сохраненной процедуры или транзакции до наступления указанного времени, истечения временного интервала или наступления некоторого события.
Эта команда имеет следующий синтаксис:
Waitfor {delay "время" | time "время" | errorexit | processexit | mirrorexit}.
Ключевое слово delay (задержка) сообщает SQL Серверу, что нужно ожидать до истечения указанного временного интервала. Ключевое слово time (время) сообщает SQL Серверу, что нужно ожидать до указанного момента времени, который должен быть задан в одном из форматов типа datetime.
Однако при этом нельзя указывать календарные даты, поскольку календарная часть даты здесь не допускается. Время задержки, которое указывается в операторах waitfor time или waitfor delay, может включать часы, минуты, секунды, и оно не должно быть больше 24 часов. Для указания времени следует использовать формат “чч:мм:сс”. Например, команда waitfor time “16:23” сообщает SQL Серверу, что нужно ожидать до 16 часов 23 минут. Оператор waitfor delay “01:30” задерживает исполнение на один час 30 минут. Форматы указания времени можно также посмотреть в главе 8 “Добавление, изменение и удаление данных”.
Ключевое слово errorexit (выход по ошибке) сообщает SQL Серверу, что нужно ожидать до тех пор, пока процесс завершится ненормально. Ключевое слово processexit (выход по выполнению) сообщает SQL Серверу, что нужно ожидать до тех пор, пока процесс завершится по какой-либо причине. Ключевое слово mirrorexit (выход по зеркалу) сообщает SQL Серверу, что нужно ожидать до тех пор, пока не появится ошибка по чтению или записи на одном из зеркальных (mirror) устройств.
Команда waitfor errorexit обычно используется для удаления процесса, который закончился ошибкой, чтобы освободить системные ресурсы. Чтобы проверить какой процесс оказался ошибочным, следует посмотреть таблицу sysprocesses (системные процессы) с помощью системной процедуры sp_who.
В следующем примере SQL Сервер ожидает наступления 14 часов 20 минут. Затем обновляется таблица chess (шахматы), в которую записывается очередной ход и исполняется сохраненная процедура sendmessage (послать сообщение), которая вставляет это сообщение в одну из таблиц Джуди (Judy), указывая ей тем самым, что сделан очередной ход шахматной партии. Этот пример имеет следующий вид:
Begin.
Waitfor time "14:20".
Insert chess(next_move).
Values('Q-KR5').
Execute sendmessage 'judy'
End.
Чтобы Джуди получила сообщение через 10 секунд, а не 14:20, нужно изменить команду ожидания следующим образом:
Waitfor delay "0:00:10".
После выдачи команды waitfor нельзя использовать связь с SQL Сервером до тех пор, пока истечет указанный промежуток времени или наступит соответствующее событие.
Комментарии
Комментарии обычно вносятся в операторы, пакеты и сохраненные процедуры для лучшего их понимания. Комментарий выглядит следующим образом:
/* Текст комментария */
На длину комментариев не накладывается никаких ограничений и они могут вносится в любое место, либо в виде отдельной строки, либо в конце строки. Допускаются также комментарии, занимающие несколько строк, но при этом каждая строка должна начинаться с наклонной черты (слеша) и звездочки и заканчиваться звездочкой и слешем. Все, что находиться между символами “/*” и “*/”, рассматривается как комментарий. Комментарии могут быть вложенными друг в друга.
Для длинных комментариев, занимающих несколько строк, вводится также следующее стилистическое соглашение. Комментарий должен начинаться символами “/*”, а все последующие строки двумя звездочками “**”. Такой комментарий, как обычно, должен заканчиваться символами “*/”. В следующем примере можно увидеть подобный комментарий:
Select * from titles.
/* A comment here might explain the rules.
** associated with using an asterisk as.
** shorthand in the select list.*/
Where price > $5.
В следующем примере приводится процедура вместе с сопровождающими ее комментариями:
/* this procedure finds rules by user name*/
Create procedure findrules2 @nm varchar(30) = null.
As if @nm is null /*if no parameter is given*/
Print "You must give a user name".
Else.
Begin.
Select sysobjects.name, sysobjects.id,
Sysobjects.uid.
From sysobjects, master..syslogins.
Where master..syslogins.name = @nm.
And sysobjects.uid = master..syslogins.suid.
And sysobjects.type = "R".
End.
©Drkb::02993.
| Наклон изображения |
Code: { **** UBPFD *********** by delphibase.endimus.com **** >> Наклон изображения по вертикали и горизонтали. Зависимости: Classes, Graphics. Автор: Fenik, chook_nu@uraltc.ru, Новоуральск. Copyright: Автор Федоровских Николай. Дата: 2 июня 2002 г. ***************************************************** } Procedure InclinationBitmap(Bitmap: TBitmap; Hor, Ver: Double; BackColor: TColor); Function Tan(X: Extended): Extended; // Tan := Sin(X) / Cos(X). Asm. FLD X. FPTAN. FSTP ST(0) // FPTAN pushes 1.0 after result. FWAIT. End; Type. TRGB = record. B, G, R: Byte; End; PRGB = ^TRGB; Var. X, y, WW, HH, alpha: Integer; OldPx, NewPx: PRGB; T: Double; Bmp: TBitmap; Begin. Bitmap.PixelFormat := pf24Bit; Bmp := TBitmap.Create; Try. Bmp.Assign(Bitmap); WW := Bitmap.Width; HH := Bitmap.Height; If Hor <> 0.0 then. Begin // По горизонтали. T := Tan(Hor * (Pi / 180)); Inc(WW, Abs(Round(HH * T))); Bitmap.Width := WW; Bitmap.Canvas.Brush.Color := BackColor; Bitmap.Canvas.FillRect(Rect(0, 0, Bitmap.Width, Bitmap.Height)); For y := 0 to HH - 1 do. Begin. If T > 0 then. Alpha := Round((HH - y) * T). Else. Alpha := -Round(y * T); OldPx := Bmp.ScanLine[y]; NewPx := Bitmap.ScanLine[y]; Inc(NewPx, Alpha); For x := 0 to Bmp.Width - 1 do. Begin. NewPx^ := OldPx^; Inc(NewPx); Inc(OldPx); End; End; Bmp.Assign(Bitmap); End; If Ver <> 0.0 then. Begin // По вертикали. T := Tan(Ver * (Pi / 180)); Bitmap.Height := HH + Abs(Round(WW * T)); Bitmap.Canvas.Brush.Color := BackColor; Bitmap.Canvas.FillRect(Rect(0, 0, Bitmap.Width, Bitmap.Height)); For x := 0 to WW - 1 do. Begin. If T > 0 then. Alpha := Round((WW - x) * T). Else. Alpha := -Round(x * T); For y := 0 to Bmp.Height - 1 do. Begin. NewPx := Bitmap.ScanLine[y + alpha]; OldPx := Bmp.ScanLine[y]; Inc(OldPx, x); Inc(NewPx, x); NewPx^ := OldPx^; End; End; End; Finally. Bmp.Free; End; End; Пример использования: InclinationBitmap(FBitmap, 7.151, -5.8, clWhite);
| Наклон и поворот |
Наклон и поворот
Наклон диаграммы можно выполнить на угол от -90° до +90°. Значения, выходящие за эти пределы, вызывают ошибку. Выбор угла поворота осуществляется записью значения угла в свойство Elevation объекта Chart. Поворот диаграммы осуществляется записью в поле Rotation объекта Chart значения угла поворота. Этот угол может иметь значения от 0° до 360°. Для задания углов наклона и поворота в приложениях на Delphi можно использовать функции ElevationChart и RotationChart.
Code: Function ElevationChart (Name:variant;Elevation:real):boolean; Begin. ElevationChart:=true; Try. E.Charts.Item[name].Elevation:=Elevation; Except. ElevationChart:=false; End; End; Function RotationChart(Name:variant;Rotation:real):boolean; Begin. RotationChart:=true; Try. E.Charts.Item[name].Rotation:=Rotation; Except. RotationChart:=false; End; End;
"Некорректные" вещественные значения.
| "Некорректные" вещественные значения |
При использовании функции StrToFloat() для значения 1234.5544 я получаю что-то типа 1234.55440000000003, но ведь это неправильно! Ничего здесь неправильного нет. Это просто погрешность чисел с плавающей точкой. Фактически источником ошибки является ошибка округления. Данная ошибка является следствием дефекта арифметики плавающей точки и того факта, что чаще всего десятичные дроби являются повторяющимися долями в двоичной системе счисления. Такие числа не могут представляться в конечном количестве битов. В связи с этим текстовое округление получается не всегда точным, т.к. большинство компьютеров подбирает последние цифры дробной части, исходя из ближайшего (с наименьшей разницей) эквивалента. Некоторые компьютеры не производят округления, а просто обрезают (выключают) последние биты, получая результирующую ошибку, правильно называемую ошибкой округления (в противоположность ошибке усечения, когда усекается расширение ряда). Для получения дополнительной информации обратитесь к Introduction to Numerical Methods (введение в числовые методы) авторов Peter A. Stark, Macmillian Company, 1970. Из-за наличия ошибки сравнение двух чисел с плавающей точкой сводится к учету абсолютной или относительной погрешности. Для сравнения двух чисел с учетом абсолютной погрешности используйте следующий код:
Code: IF ABS(CalculatedValue - TrueValue) < FuzzValue then ...
, где FuzzValue определяет величину абсолютной погрешности. Для сравнения двух чисел с учетом относительной погрешности используйте следующий код:
Code: IF ABS( (CalculatedValue - TrueValue) / TrueValue ) < AcceptableRelativeError then ...
, где AcceptableRelativeError определяет величину относительной погрешности (ну, и конечно, TrueValue <> 0.0). Математеческий модуль Delphi вычисляет относительную погрешность следующим образом (но оно не вынесено в секцию interface):
Code: FUNCTION RelSmall(X, Y: Extended): Boolean; { Возвращаем Истину, если разница между X и Y незначительна }. CONST. C1: Double = 1E-15; C2: Double = 1E-12; BEGIN. Result := Abs(X) < (C1 + C2 * Abs(Y)). END;
Источник: DelphiWorld.
©Drkb::00223.
Некоторые дополнительные возможности.
| Некоторые дополнительные возможности |
Некоторые дополнительные возможности
Мы рассмотрели основные функции работы с ячейками: запись/чтение и установка формата. К этому можно добавить еще те, которые пригодятся на практике. Если мы работаем с областью, то внутри этой области можно обращаться к ячейкам по номеру колонки и столбца относительно начала этой области. Смотрите пример: E.ActiveWorkbook.Sheets.Item[sheet].Range['A5:B10'].Cells.Item[1,1]:=2343. Значение будет записано в ячейку A5.
Для записи формул можно использовать следующий оператор E.ActiveWorkbook.Sheets.Item[sheet].Range['A1'].Formula: ='=$A$4+$A$10'.
Для выделения области листа, заполненного информацией, используйте оператор E.ActiveWorkbook.Sheets.Item[sheet].UsedRange.Select;
Вычислить количество ячеек, столбцов и строк области листа, заполненного информацией, можно, используя следующие операторы:
E.ActiveWorkbook.Sheets.Item[sheet].UsedRange.Count - количество ячеек.
E.ActiveWorkbook.Sheets.Item[sheet].UsedRange.Columns.Count - количество столбцов.
E.ActiveWorkbook.Sheets.Item[sheet].UsedRange.Rows.Count - количество строк.
Для вычисления адреса заполненной области (левая верхняя ячейка - правая нижняя ячейка) можно использовать оператор E.ActiveWorkbook.Sheets.Item[sheet].UsedRange.Address, который возвращает строку, содержащую область адресов.
| Некоторые общие параметры для листа |
Некоторые общие параметры для листа
Фоновый рисунок листа устанавливается процедурой SetBackgroundPicture, коллекции Sheets или объекта ActiveSheet. Если аргумент FileName этой функции равен пустой строке, то это отменяет установленный ранее фоновый рисунок. Реализация этой возможности на Delphi представлена в виде функции SetBackgroundPicture.
Code: Function SetBackgroundPicture(sheet:variant; File_:string):boolean; Begin. SetBackgroundPicture:=true; Try. E.ActiveWorkbook.Sheets.Item. [sheet].SetBackgroundPicture(FileName:=file_); Except. SetBackgroundPicture:=false; End; End;
| Некоторые функции для работы с MSWord и MSExcel. |
Code: { **** UBPFD *********** by kladovka.net.ru **** >> Некоторые функции для работы с MSWord и MSExcel. Некоторые процедуры для работы с с MSWord и MSExcel, которыми активно пользуюсь сам и предлагаю остальным. Есть как простые функции такие как открытие документа, получение текста документа, управление окнами и т.п. так и более продвинутые: добавление таблицы в MSWord или MSExcel из DBGrid, ListView и т.п. Описывать все не буду, постарался чтобы из названия функций было понятно. Зависимости: Windows, Messages, SysUtils, Classes, Comctrls,Grids, DBGrids, WordConst, ExcelConst. Автор: FalicSoft, falicsoft@narod.ru, Москва. Copyright: FalicSoft Laboratory (C). Дата: 24 октября 2003 г. ********************************************** } Unit ExcelConst; Interface. Const. XlCenter=-4108; XlLeft=-4131; XlRight=-4152; XlDistributed=-4117; XlJustify=-4130; XlNone=-4142; {HorizontalAlignment}. XlHAlignCenter=-4108; XlHAlignDistributed=-4117; XlHAlignJustify=-4130; XlHAlignLeft=-4131; XlHAlignRight=-4152; {In addition, for the Range or Style object}. XlHAlignCenterAcrossSelection=7; XlHAlignFill=5; XlHAlignGeneral=1; {VerticalAlignment}. XlVAlignBottom=-4107; XlVAlignCenter=-4108; XlVAlignDistributed=-4117; XlVAlignJustify=-4130; XlVAlignTop=-4160; {Borders}. XlInsideHorizontal=12; XlInsideVertical=11; XlDiagonalDown=5; XlDiagonalUp=6; XlEdgeBottom=9; XlEdgeLeft=7; XlEdgeRight=10; XlEdgeTop=8; {LineStyle}. XlContinuous=1; XlDash=-4115; XlDashDot=4; XlDashDotDot=5; XlDot=-4118; XlDouble=-4119; XlSlantDashDot=13; XlLineStyleNone=-4142; {Weight}. XlHairline=1; XlThin=2; XlMedium=-4138; XlThick=4; {ColorIndex}. XlColorIndexAutomatic=-4105; XlColorIndexNone=-4142; {Background}. XlBackgroundAutomatic=-4105; XlBackgroundOpaque=3; XlBackgroundTransparent=2; {Underline}. XlUnderlineStyleNone=-4142; XlUnderlineStyleSingle=2; XlUnderlineStyleDouble=-4119; XlUnderlineStyleSingleAccounting=4; XlUnderlineStyleDoubleAccounting=5; Implementation. End. Unit WordConst; Interface. Const. {----MoveRight(Unit, Count, Extend)}. {Unit}. WdCharacter=1; WdWord=2; WdSentence=3; WdCell=12; WdAdjustNone=0; WdOrientPortrait=0; WdOrientLandScape=1; WdAlignParagraphCenter=1; WdAlignParagraphLeft=0; WdAlignParagraphRight=2; {Extend}. WdMove=0; WdExtend=1; WdBorderHorizontal=-6; WdBorderVertical=-5; WdLineStyleNone=0; WdLine=5; Implementation. End. Unit FunctionOLEObject; Interface. Uses. Windows, Messages, SysUtils, Classes, Comctrls,Grids, DBGrids; {---------- WORD ----------}. {--- Documents}. Function WordAddDocument(const vWord: Variant; Const vTemplate: String; Const vNewTemplate: Boolean): Boolean; {---Windows}. Function WordWindowsCount(const vWord: Variant): Integer; {---Window}. Procedure WordWindowActivate(const vWord: Variant; Const IWindow: Integer); Procedure WordNextWindowActivate(const vWord: Variant); Procedure WordPreviousWindowActivate(const vWord: Variant); {---Selection}. Procedure WordPutField(const vWord: Variant; Const Field,Value: String); Procedure WordPutFieldItem(const vWord: Variant; Field:String; Item: Integer; Value: array of String); Procedure WordText(const vWord: Variant; Const Value: String); Procedure WordTypeParagraph(const vWord: Variant); Procedure WordMoveRight(const vWord: Variant; Const vUnit, vCount, vExtend: Integer); Procedure WordMoveDown(const vWord: Variant; Const vUnit, vCount:integer); {---Table}. Procedure WordTablesAdd(const vWord: Variant; Const Rows, Columns: Integer); Procedure WordTablesHeaders(const vWord: Variant; Const vColl,vRow,vCount:integer); Procedure WordTablesCellValue(const vWord: Variant; Const Table, Row, Column: Integer; Const Value: String; Const FontName: String; Const FontBold,FontItalic:boolean; Const FontUnderLine:byte); Procedure WordTablesNextCellValue(const vWord: Variant; Const Value: String); Procedure WordTableAddFromListView(const vWord: Variant; ListView: TListView); Procedure WordTableAddFromGrid(const vWord: Variant; DBGrid: TDBGrid; CollSize:boolean); {---------- Excel ----------}. Procedure ExcelCellsValue(const vExcel: Variant; Const Row, Col: Integer; Const Value: Variant); Procedure ExcelFromListView(const vExcel: Variant; ListView: TListView; Const Row, Col: Integer); Procedure ExcelTableAddFromGrid(const vExcel: Variant; DBGrid: TDBGrid; Const Row, Col: Integer); Procedure ExcelRangeCellsValue(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const Value: Variant; Const HorizontalAlignment, VerticalAlignment: Integer; Const WrapText: Boolean; Const Orientation: Integer; Const ShrinkToFit: Boolean; Const MergeCells: Boolean); Procedure ExcelRangeCellsCopy(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const tlToRow, tlToCol, DrToRow, drToCol: Integer); Procedure ExcelRangeCellsBorders(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const BorderType: Integer; Const LineStyle: Integer); Procedure ExcelBorders(const vExcel: Variant; Const BorderType: Integer; Const LineStyle: Integer); Procedure ExcelRangeCellsSelect(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer); Procedure ExcelFont(const vExcel: Variant; Const Name: String; Const Bold: Boolean; Const Italic: Boolean; Const Size: Integer; Const Strikethrough: Boolean; Const Superscript: Boolean; Const Subscript: Boolean; Const OutlineFont: Boolean; Const Shadow: Boolean; Const Underline: Integer; Const ColorIndex: Integer); Procedure ExcelFontName(const vExcel: Variant; Const Name: String); Procedure ExcelFontSize(const vExcel: Variant; Const Size: Integer); Procedure ExcelFontBold(const vExcel: Variant; Const Bold: Boolean); Procedure ExcelFontItalic(const vExcel: Variant; Const Italic: Boolean); Procedure ExcelRangeCellsFontName(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const Name: String); Procedure ExcelRangeCellsFontSize(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const Size: Integer); Procedure ExcelRangeCellsFontBold(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const Bold: Boolean); Procedure ExcelRangeCellsFontItalic(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const Italic: Boolean); Procedure ExcelRangeCellsFont(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const Name: String; Const Bold: Boolean; Const Italic: Boolean; Const Size: Integer; Const Strikethrough: Boolean; Const Superscript: Boolean; Const Subscript: Boolean; Const OutlineFont: Boolean; Const Shadow: Boolean; Const Underline: Integer; Const ColorIndex: Integer); Implementation. Uses WordConst, ExcelConst; Function WordAddDocument(const vWord: Variant; Const vTemplate: String; Const vNewTemplate: Boolean): Boolean; Begin. Result:=True; Try. VWord.Documents.Add(Template:=vTemplate, NewTemplate:=vNewTemplate); Except. Result:=False; End; End; Procedure WordMoveRight(const vWord: Variant; Const vUnit, vCount, VExtend: Integer); Begin. VWord.Selection.MoveRight(vUnit, vCount, vExtend); End; Procedure WordTablesHeaders(const vWord: Variant; Const vColl,vRow,vCount:integer); Var I,cnt:integer; Begin. VWord.Selection.MoveLeft(Unit:=wdCell, Count:=vColl-1); VWord.Selection.MoveUp(Unit:=wdLine, Count:=vRow); VWord.Selection.SelectRow; VWord.Selection.Rows.HeadingFormat :=-1; { vWord.Selection.MoveUp(Unit:=wdLine, Count:=vRow); VWord.Selection.Tables.Item(1).Select; VWord.Selection.ParagraphFormat.Alignment:= wdAlignParagraphCenter;}. End; Procedure WordMoveDown(const vWord: Variant; Const vUnit, vCount:integer); Begin. VWord.Selection.MoveDown(vUnit,vCount); End; Procedure WordTablesAdd(const vWord: Variant; Const Rows, Columns: Integer); Begin. VWord.ActiveDocument.Tables.Add(Range:=vWord.Selection.Range, NumRows:=Rows, NumColumns:=Columns); End; Procedure WordTablesCellValue(const vWord: Variant; Const Table, Row, Column: Integer; Const Value: String; Const FontName: String; Const FontBold,FontItalic:boolean; Const FontUnderLine:byte); Begin. VWord.ActiveDocument.Tables.Item(Table).Cell(Row,Column). Range.Font.Name:=FontName; VWord.ActiveDocument.Tables.Item(Table).Cell(Row,Column). Range.Font.Bold:=FontBold; VWord.ActiveDocument.Tables.Item(Table).Cell(Row,Column). Range.Font.Italic:=FontItalic; VWord.ActiveDocument.Tables.Item(Table).Cell(Row,Column). Range.Font.UnderLine:=FontUnderLine; VWord.ActiveDocument.Tables.Item(Table).Cell(Row,Column). Range.InsertAfter(Text:=Value); End; Procedure WordTableAddFromListView(const vWord: Variant; ListView: TListView); Var i, j: Integer; Begin. WordTablesAdd(vWord, ListView.Items.Count+1, ListView.Columns.Count); WordText(vWord, ListView.Column[0].Caption); For j:=1 To ListView.Columns.Count-1 Do begin. WordTablesNextCellValue(vWord, ListView.Column[j].Caption); End; For i:=0 To ListView.Items.Count-1 Do begin. WordTablesNextCellValue(vWord, ListView.Items.Item[i].Caption); For j:=0 To ListView.Columns.Count-2 Do. If ListView.Items.Item[i].SubItems.Count>j Then. WordTablesNextCellValue(vWord, ListView.Items.Item[i].SubItems.Strings[j]). Else. WordMoveRight(vWord, wdCell, 1, wdMove); End; End; Procedure WordTableAddFromGrid(const vWord: Variant; DBGrid: TDBGrid; CollSize:boolean); Var i, j,Col,Row,ColWidth: Integer; Begin. Col:=DBGrid.Columns.Count; Row:=DBGrid.DataSource.DataSet.RecordCount+1; WordTablesAdd(vWord, Row,Col); WordText(vWord, DBGrid.Columns.Items[0].Title.Caption); If CollSize then ColWidth:=DBGrid.Columns.Items[0].Width; VWord.Selection.Tables.Item(1).Columns.Item(1). SetWidth(ColumnWidth:=ColWidth,RulerStyle:=wdAdjustNone); For j:=1 To Col-1 Do. Begin. WordTablesNextCellValue(vWord, DBGrid.Columns.Items[j].Title.Caption); If CollSize then ColWidth:=DBGrid.Columns.Items[j].Width; VWord.Selection.Tables.Item(1).Columns.Item(j+1). SetWidth(ColumnWidth:=ColWidth,RulerStyle:=wdAdjustNone); End; DBGrid.DataSource.DataSet.First; For i:=1 To Row-1 Do. Begin. For j:=0 To Col-1 Do. WordTablesNextCellValue(vWord, DBGrid.Columns.Items[j].Field.AsString); DBGrid.DataSource.DataSet.Next; End; DBGrid.DataSource.DataSet.First; End; Procedure WordTablesNextCellValue(const vWord: Variant; Const Value: String); Begin. WordMoveRight(vWord, wdCell, 1, wdMove); VWord.Selection.Font.Bold:= false; WordText(vWord, Value); End; Procedure WordText(const vWord: Variant; Const Value: String); Begin. VWord.Selection.TypeText(Text:=Value); End; Procedure WordTypeParagraph(const vWord: Variant); Begin. VWord.Selection.TypeParagraph; End; Procedure WordPutField(const vWord: Variant; Const Field,Value: String); Begin. VWord.Selection.GoTo(Name:=Field); VWord.Selection.TypeText(Text:=Value); End; Procedure WordPutFieldItem(const vWord: Variant; Field:String; Item: Integer; Value: array of String); Var i: Integer; Begin. Field:=Format('%s%d',[Field,Item]); VWord.Selection.GoTo(Name:=Field); For i:=Low(Value) To High(Value) Do begin. VWord.Selection.TypeText(Text:=Value[i]); VWord.Selection.MoveRight; End; End; Procedure WordWindowActivate(const vWord: Variant; Const IWindow: Integer); Begin. VWord.Windows.Item(IWindow).Activate; End; Procedure WordNextWindowActivate(const vWord: Variant); Begin. VWord.ActiveWindow.Next.Activate; End; Procedure WordPreviousWindowActivate(const vWord: Variant); Begin. VWord.ActiveWindow.Previous.Activate; End; Function WordWindowsCount(const vWord: Variant): Integer; Begin. Result:=vWord.Windows.Count; End; //------- Exel -------------------- Procedure ExcelCellsValue(const vExcel: Variant; Const Row, Col: Integer; Const Value: Variant); Var sV: String; IV: Integer; DV: TDateTime; Begin. Case TVarData(Value).VType of. VarEmpty:; VarNull:; VarSmallint:; VarInteger:begin. IV:=Value; VExcel.Cells[Row,Col].Value:=iV; End; VarSingle:; VarDouble:; VarCurrency:; VarDate: begin. DV:=Value; VExcel.Cells[Row,Col].Value:=dV; End; VarOLEStr:; VarDispatch:; VarError:; VarBoolean:; VarUnknown:; VarByte:; VarString: begin. SV:=Value; VExcel.Cells[Row,Col].Value:=sV; End; VarTypeMask:; VarArray:; VarByRef:; End; End; Procedure ExcelFromListView(const vExcel: Variant; ListView: TListView; Const Row, Col: Integer); Var i, j: Integer; Begin. For j:=0 To ListView.Columns.Count-1 Do begin. VExcel.Cells[Row,Col+j].Value:=ListView. Column[j].Caption; End; For i:=0 To ListView.Items.Count-1 Do begin. VExcel.Cells[Row+1+i,Col].Value:=ListView. Items.Item[i].Caption; For j:=0 To ListView.Items.Item[i].SubItems.Count-1 Do. Try. VExcel.Cells[Row+1+i,Col+1+j].Value:=StrToFloat(ListView. Items.Item[i].SubItems.Strings[j]); Except. VExcel.Cells[Row+1+i,Col+1+j].Value:=ListView. Items.Item[i].SubItems.Strings[j]; End; End; End; Procedure ExcelTableAddFromGrid(const vExcel: Variant; DBGrid: TDBGrid; Const Row, Col: Integer); Var i, j,vCol,vRow,ColWidth: Integer; Begin. VCol:=DBGrid.Columns.Count; VRow:=DBGrid.DataSource.DataSet.RecordCount+1; For j:=0 To vCol-1 Do. VExcel.Cells[Row,Col+j].Value:=DBGrid.Columns.Items[j].Title.Caption; DBGrid.DataSource.DataSet.First; For i:=0 To vRow-2 Do. Begin. For j:=0 To vCol-1 Do. Try. VExcel.Cells[Row+1+i,Col+j].Value:= StrToFloat(DBGrid.Columns.Items[j].Field.AsString); Except. VExcel.Cells[Row+1+i,Col+j].Value:= DBGrid.Columns.Items[j].Field.AsString; End; DBGrid.DataSource.DataSet.Next; End; DBGrid.DataSource.DataSet.First; End; Procedure ExcelRangeCellsValue(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const Value: Variant; Const HorizontalAlignment, VerticalAlignment: Integer; Const WrapText: Boolean; Const Orientation: Integer; Const ShrinkToFit: Boolean; Const MergeCells: Boolean); Begin. ExcelCellsValue(vExcel, tlRow, tlCol, Value); VExcel.Range[vExcel.Cells[tlRow, tlCol], VExcel.Cells[drRow, drCol]].Select; VExcel.Selection.HorizontalAlignment:=HorizontalAlignment; VExcel.Selection.VerticalAlignment:=VerticalAlignment; VExcel.Selection.WrapText:=WrapText; VExcel.Selection.Orientation:=Orientation; VExcel.Selection.ShrinkToFit:=ShrinkToFit; VExcel.Selection.MergeCells:=MergeCells; End; Procedure ExcelRangeCellsCopy(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const tlToRow, tlToCol, DrToRow, drToCol: Integer); Begin. VExcel.Range[vExcel.Cells[tlRow, tlCol], VExcel.Cells[drRow, drCol]].Select; VExcel.Selection.Copy; VExcel.Range[vExcel.Cells[tlToRow, tlToCol], VExcel.Cells[drToRow, drToCol]].Select; VExcel.ActiveSheet.Paste; End; Procedure ExcelBorders(const vExcel: Variant; Const BorderType: Integer; Const LineStyle: Integer); Begin. VExcel.Selection.Borders[BorderType].LineStyle:=LineStyle; End; Procedure ExcelRangeCellsBorders(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const BorderType: Integer; Const LineStyle: Integer); Begin. VExcel.Range[vExcel.Cells[tlRow, tlCol], VExcel.Cells[drRow, drCol]].Select; ExcelBorders(vExcel, BorderType, LineStyle); End; Procedure ExcelRangeCellsSelect(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer); Begin. VExcel.Range[vExcel.Cells[tlRow, tlCol], VExcel.Cells[drRow, drCol]].Select; End; Procedure ExcelFont(const vExcel: Variant; Const Name: String; Const Bold: Boolean; Const Italic: Boolean; Const Size: Integer; Const Strikethrough: Boolean; Const Superscript: Boolean; Const Subscript: Boolean; Const OutlineFont: Boolean; Const Shadow: Boolean; Const Underline: Integer; Const ColorIndex: Integer); Begin. ExcelFontName(vExcel, Name); ExcelFontSize(vExcel, Size); ExcelFontBold(vExcel, Bold); ExcelFontItalic(vExcel, Italic); VExcel.Selection.Font.Strikethrough:=Strikethrough; VExcel.Selection.Font.Superscript:=Superscript; VExcel.Selection.Font.Subscript:=Subscript; VExcel.Selection.Font.OutlineFont:=OutlineFont; VExcel.Selection.Font.Shadow:=Shadow; VExcel.Selection.Font.Underline:=Underline; VExcel.Selection.Font.ColorIndex:=ColorIndex; End; Procedure ExcelRangeCellsFont(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const Name: String; Const Bold: Boolean; Const Italic: Boolean; Const Size: Integer; Const Strikethrough: Boolean; Const Superscript: Boolean; Const Subscript: Boolean; Const OutlineFont: Boolean; Const Shadow: Boolean; Const Underline: Integer; Const ColorIndex: Integer); Begin. ExcelRangeCellsSelect(vExcel, tlRow, tlCol, DrRow, drCol); ExcelFont(vExcel, Name, Bold, Italic, Size, Strikethrough, Superscript, Subscript, OutlineFont, Shadow, Underline, ColorIndex); End; Procedure ExcelFontName(const vExcel: Variant; Const Name: String); Begin. VExcel.Selection.Font.Name:=Name; End; Procedure ExcelRangeCellsFontName(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const Name: String); Begin. ExcelRangeCellsSelect(vExcel, tlRow, tlCol, DrRow, drCol); ExcelFontName(vExcel, Name); End; Procedure ExcelFontSize(const vExcel: Variant; Const Size: Integer); Begin. VExcel.Selection.Font.Size:=Size; End; Procedure ExcelRangeCellsFontSize(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const Size: Integer); Begin. ExcelRangeCellsSelect(vExcel, tlRow, tlCol, DrRow, drCol); ExcelFontSize(vExcel, Size); End; Procedure ExcelFontBold(const vExcel: Variant; Const Bold: Boolean); Begin. VExcel.Selection.Font.Bold:=Bold; End; Procedure ExcelRangeCellsFontBold(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const Bold: Boolean); Begin. ExcelRangeCellsSelect(vExcel, tlRow, tlCol, DrRow, drCol); ExcelFontBold(vExcel, Bold); End; Procedure ExcelFontItalic(const vExcel: Variant; Const Italic: Boolean); Begin. VExcel.Selection.Font.Italic:=Italic; End; Procedure ExcelRangeCellsFontItalic(const vExcel: Variant; Const tlRow, tlCol, DrRow, drCol: Integer; Const Italic: Boolean); Begin. ExcelRangeCellsSelect(vExcel, tlRow, tlCol, DrRow, drCol); ExcelFontItalic(vExcel, Italic); End; End.
| Нарисовать линию, не используя функции LineTo. |
Code: { **** UBPFD *********** by delphibase.endimus.com **** >> Отображение текста с тегами форматирования. Рисует строку текста, содержащую теги форматирования, походие на теги HTML. Поддерживаются следующие теги: <b>..</b> Полужирный. <i>..</i> Наклонный. <u>..</u> Подчёркнутый. <s>..</s> Перечёркнутый. <big[ n]>..</big> Увеличить ращмер шрифта на n единиц (по умолчанию 1). <small[ n]>..</small> Уменьшить шрифт на n единиц (по умолчанию 1). <sub>..</sub> Нижний индекс. <sup>..</sup> Верхний индекс. Для правильного отображения внутри тегов <sub> и <sup> не должно располагаться других тегов. <font name="Имя шрифта" size="Размер" color="Цвет" charset="Кодовая страница">..</font> Установка параметров шрифта. Размер шрифта указывается как для свойства TFont.Size, а не как в HTML. В качестве цвета можно указывать либо константы clXXXX либо числа в формате #RRGGBB, Где RR GG и ВВ соответственно шестнадцатеричные значения 00..FF красной, Зелёной и синей составляющей, HTML цвета не поддерживаются. В параметре charset. Указываются константы XXXX_CHARSET, например RUSSIAN_CHARSET или ANSI_CHARSET. Зависимости: Windows, SysUtils, Classes, Graphics, Dim. Автор: Dimka Maslov, mainbox@endimus.com, ICQ:148442121, Санкт-Петербург. Copyright: Dimka Maslov. Дата: 17 марта 2004 г. ***************************************************** } Unit HtDraw; Interface. Uses Windows, SysUtils, Classes, Graphics, Dim; Type. TTag = class; THtDraw = class(TObject). Private. FTag: TTag; FText: TString; Procedure SetText(Value: TString); Public. Function Draw(Canvas: TCanvas; X, Y: Integer): Integer; // Canvas - устройство для отображения текста. // в свойстве Canvas.Font задаются начальные параметры шрифта. // X, Y - начальные координаты. // Функция возвращает сумму X и ширины выведенного текста. Property Text: TString read FText write SetText; // Задаёт текст для отображения. В отличие от свойств компонентов, // присвоение значения этого свойства не приводит к автоматической. // перерисовке. Необходимо вызывать метод Draw. Constructor Create(const AText: TString); Destructor Destroy; override; End;
| Найти все ссылки в TMemo. |
Code: { For this tip you need Memo1, ListBox1, Label1, Button1. } Procedure TForm1.Button1Click(Sender: TObject); Var. I, p: Integer; S: string; Begin. ListBox1.Clear; For i := 0 to Memo1.Lines.Count - 1 do. Begin. If Pos('http://', Memo1.Lines.Strings[i]) > 0 then. Begin. S := ''; {If the current line contains a "http://", read on until a space is found. Die aktuelle Zeile wird nach der Zeichenfolge "http://" durchsucht. Und bei Erfolg ab der gefundenen Position ausgelesen, bis ein. Leerzeichen auftritt...}. For p := Pos('http://', Memo1.Lines.Strings[i]) to. Length(Memo1.Lines.Strings[i]) do. If Memo1.Lines.Strings[i][p] <> ' ' then. S := s + Memo1.Lines.Strings[i][p]. Else. Break; {Remove some characters if address doesn't end with a space. Falls die gefundene Adresse nicht mit einem Leerzeichen abschlie?t, Werden hier noch anhangende Textzeichen entfernt...}. While Pos(s[Length(s)], '..;!")]}?''>') > 0 do. Delete(s, Length(s), 1); // Add the Address to the list... //Gefundene Adresse in die Liste aufnehmen... ListBox1.Items.Add(s); End; End; // Show the number of Addresses in Label1. // Die Zahl der gefundenen Adressen in Label1 anzeigen... If ListBox1.Items.Count > 0 then. Label1.Caption := IntToStr(ListBox1.Items.Count) + ' Adresse(n) gefunden.' Else. Label1.Caption := 'Keine Adresse gefunden.'; End;
| Найти позицию каретки |
Code: Function GetCaretPosition(var APoint: TPoint): Boolean; Var w: HWND; AID, mID: DWORD; Begin. Result:= False; W:= GetForegroundWindow; If w <> 0 then. Begin. AID:= GetWindowThreadProcessId(w, nil); MID:= GetCurrentThreadid; If aID <> mID then. Begin. If AttachThreadInput(mID, aID, True) then. Begin. W:= GetFocus; If w <> 0 then. Begin. Result:= GetCaretPos(APoint); Windows.ClientToScreen(w, APoint); End; AttachThreadInput(mID, aID, False); End; End; End; End; //Small demo: set cursor to active caret position. Procedure TForm1.Timer1Timer(Sender: TObject); Var. Pt: TPoint; Begin. If GetCaretPosition(Pt) then. Begin. ListBox1.Items.Add(Format('Caret position is %d %d', [Pt.x, Pt.y])); SetCursorPos(Pt.X, Pt.Y); End; End;
| Найти простое число |
Code: Unit simple_; Interface. Uses. Windows, Messages, SysUtils, Classes, Graphics, Controls, Forms, Dialogs, StdCtrls; Type. TForm1 = class(TForm). Button1: TButton; Label1: TLabel; Edit1: TEdit; Label2: TLabel; Procedure Button1Click(Sender: TObject); Private. { Private declarations }. Public. { Public declarations }. End; Var. Form1: TForm1; Implementation. {$R *.DFM}. Procedure TForm1.Button1Click(Sender: TObject); Var. N: integer; // проверяемое число. D: integer; // делитель. R: integer; // остаток от деления n на d. Begin. N := StrToInt(Edit1.text); D := 2; // сначала будем делить на два. Repeat. R := n mod d; If r <> 0 {// n не разделилось нацело на d} then. D := d + 1; Until r = 0; // повторять пока не найдено число на n делится без остатка. Label2.caption := Edit1.text; If d = n then. Label2.caption := label2.caption + ' - простое число.' Else. Label2.caption := label2.caption + ' - обычное число.'; End; End.
©Drkb::04087.
DelphiWorld 6.0.
| Преобразование 3D-координат точки в 2D-координаты в перспективе |
Code: { **** UBPFD *********** by kladovka.net.ru **** >> Преобразование 3D-координат точки в 2D-координаты в перспективе. Процедура преобразует 3D-координаты точки в 2D-координаты на "картинной. Плоскости" в перспективе. В качестве параметров процедура принимает. Координаты точки в пространстве (X - горизонтальная перпендикулярно. Лучу зрения, Y - горизонтальная вдоль луча зрения, Z - вертикальная). Начало координат - точка пересечения луча зрения с картинной плоскостью; Height - высоту наблюдателя; Basis - расстояние от наблюдателя до картинной плоскости; Результаты вычисления записываются в переменные XP и YP - координаты. Точки на картинной плоскости. Зависимости: нет. Автор: Dimka Maslov, mainbox@endimus.ru, ICQ:148442121, Санкт-Петербург. Copyright: Dimka Maslov, 1995. Дата: 29 апреля 2002 г. ********************************************** } Procedure Perspective(const X, Y, Z, Height, Basis: Double; Var XP, YP: Double); Var. Den: Double; Begin. Den:=Y+Basis; If Abs(Den)<1e-100 then Den:=1e-100; XP:=Basis*X/Den; YP:=(Basis*Z+Height*Y)/Den; End;
| Преобразование даты и времени в строковый вид YYYYMMDDHHNNSS и обратно |
| Преобразование даты, месяц прописью |
| Преобразование выражения к Обратной Польской Нотации |
Code: { **** UBPFD *********** by kladovka.net.ru **** >> Преобразование выражения к Обратной Польской Нотации. Для работы функции необходимо определить тип: Type. OperList = array of widestring; Параметром функции служит массив из переменных и операторов. Результат - массив из переменных и операторов. Зависимости: SysUtils. Автор: avr555, avr555@mail.ru, ICQ:15782989. Copyright: Переделано с http://algolist.manual.ru/syntax/revpn.php. Дата: 26 мая 2002 г. ********************************************** } Function ConvertToRPN(AStr:OperList):OperList; Var. I,k:integer; Stack : OperList; //Stack. AResult : OperList; //Tmp for result. Function Prior(AOper:widestring):integer; Begin. {Приоритет операции: NOT - 8. Унарный "-" - 7. "*", "/" - 6. "+", "-" - 5. ">", "<", "=", "<>", ">=", "<=" - 4. "AND" - 3. "OR" - 2. "(", ")" - 1. } AOper := trim(AOper); Result := -1; If AOper = 'NOT' then Result := 8; If (AOper = '*') or (AOper = '/') then Result := 6; If (AOper = '+') or (AOper = '-') then Result := 5; If (AOper = '>') or (AOper = '<') or (AOper = '<>') or (AOper = '>='). Or (AOper = '<=') or (AOper = '=') then Result := 4; If AOper = 'AND' then Result := 3; If AOper = 'OR' then Result := 2; If (AOper = '(') or (AOper = ')') then Result := 1; End; Procedure AddToStack(AOper:widestring); Begin. {Добавление элементы в стек}. SetLength(Stack,High(Stack)+2); Stack[High(Stack)] := AOper; End; Procedure AddToResult(AOper:widestring); Begin. SetLength(AResult,High(AResult)+2); AResult[High(AResult)] := AOper; End; Begin. {Конвертирование строку в Обратную Польскую Нотацию. Возвращает - массив. Алгоритм: А) если стек пуст, то операция из входной строки переписывается в стек; Б) операция выталкивает из стека все операции с большим или равным. Приоритетом в выходную строку; В) если очередной символ из исходной строки есть открывающая скобка, То он проталкивается в стек; Г) закрывающая круглая скобка выталкивает все операции из стека до. Ближайшей открывающей скобки, сами скобки в выходную строку не. Переписываются, а уничтожают друг друга. } Result := nil; AResult := nil; I := 0; While i <= High(AStr) do. Begin. If Prior(AStr[i]) = -1 then //Значит просто переменная. AddToResult(AStr[i]). Else //Операции. Begin. If High(Stack) = -1 then {a}. AddToStack(AStr[i]). Else. Begin. If AStr[i] = '(' then {в}. AddToStack(AStr[i]). Else. Begin. If AStr[i] = ')' then {г}. Begin. K := High(Stack); While (k>=0) and (Stack[k] <> '(') do. Begin. AddToResult(Stack[k]); SetLength(Stack,High(Stack)); //Удаляем элемент из стека. K := k - 1; End; //Удаляем открывающуюся скобку. SetLength(Stack,High(Stack)); //Удаляем элемент из стека. End. Else. Begin. K := High(Stack); While (k>=0) and (Prior(Stack[k]) >= Prior(AStr[i])) do {б}. Begin. AddToResult(Stack[k]); SetLength(Stack,high(Stack)); //Удаляем элемент из стека. K := k - 1; End; AddToStack(AStr[i]); //Если не скобка просто добавляем в стек. End; End; End; End; I := i + 1; End; //while. //Сбрасываем все оставшееся из стека. For i := high(Stack) downto 0 do. Begin. AddToResult(Stack[i]); End; Result := AResult; End;
| Преобразование Delphi приложений в Delphi .Net. |
20.1. Преобразование Delphi приложений в Delphi .Net.
Данная глава вводит в особенности переноса существующего кода в DCCIL / Delphi. Net. Она также показывает элементы, которые больше не применимы и как их обойти, чтобы они могли правильно работать в .Net framework.
Данная статья так также дает руководство по оценке преобразования существующего приложения для работы в .Net framework с помощью DCCIL / Delphi.NET.
20.1.1. Термины.
Данная статья сфокусирована на преобразовании и его последствиях для вашего Delphi кода. Поэтому, данная статья не является введением в .Net саму по себе, а только дает определение основных базовых терминов, относящихся к .NET.
20.1.1.1. CIL.
Common Intermediate Language или просто Intermediate Language (промежуточный язык). Это язык компилятора, который преобразовывает исходный код, пригодный для использования в рантайм.
IL выполняет роль, подобную P-коду или интерпретируемому языку Java. Но также он отличается от них и реализован совсем иначе.
20.1.1.2. CLR.
CLR – это сокращение от Common Language Runtime. CLR – это основа NET framework и среда исполнения приложений, которые компилируются в IL. Вначале вам может показаться, что CLR очень похожа на интерпретатор P-кода, поскольку выполняет аналогичную роль, но это не интерпретатор простого P-кода, а много больше.
20.1.1.3. CTS.
CTS CLR – это сокращение от Common Type System. CTS включает предопределенные, базовые .NET типы, которые доступны в любом .NET языке. Это означает, что integer больше не определяется каждым компилятором, а встроен в CTS и поэтому integer полностью одинаков во всех .NET языках.
CTS не ограничен только integer, а включает много других типов. CTS разделяет типы на две базовые категории: значения и ссылочные типы.
Типы значений - это типы, которые записываются в стеке. Вы должны быть знакомы с термином – простой или порядковый типы. Типы значений включают integers, bytes и другие примитивы, структуры и перечисления.
Ссылочные типы – это типы, значения которых сохраняются в куче, и ссылки используются для доступа к ним. Ссылочные типы включают objects, interfaces и pointers.
20.1.1.4. CLS.
CLS – это сокращение от Common Language Specification. CLS это просто спецификация, которая определяет, какие свойства языка могут и должны быть поддержаны для работы в .NET.
20.1.1.5. Управляемый код (Managed Code).
Управляемый код – это код который компилируется в IL и исполняется с помощью CLR. Основная цель любого .NET приложения – это быть 100% обслуживаемым кодом. (От корректора: Ну, блин сказал... J).
20.1.1.6. Неуправляемый код (Unmanaged Code).
Неуправляемый код – это откомпилированный в машинные инструкции, который получен с помощью Delphi for Windows. Неуправляемый код также включает код DLL, COM серверов и даже Win32 API. Основная цель любого .NET приложения – это не имееть такого кода.
20.1.1.7. Сборка (Assembly).
Сборка это коллекция .NET IL модулей. Это очень похоже на пакеты в Delphi и Delphi .NET трактует .NET сборки аналогично пакетам Delphi.
20.1.2. Компиляторы и среды (IDE).
Имеется несколько компиляторов и сред относящихся к Delphi и к .NET.
20.1.2.1. Компилятор DCCIL (Diesel).
DCCIL – это компилятор командной строки, который производит .NET вывод. DCCIL – это то, что было названо как "Delphi .NET preview compiler" и было включено в Delphi 7.
DCC – это имя стандартного компилятора командной строки в Delphi и это сокращение от Delphi Command line Compiler.
IL это ссылка на .NET Intermediate Language.
Отсюда DCC + IL = DCCIL. Произносить каждый раз D-C-C-I-L слишком громоздко и поэтому было применено имя "Diesel".
DCCIL имеет подобные DCC параметры и некоторые специфические для .NET расширения .
20.1.2.1.1 Beta.
DCCIL в данный момент находится в состоянии беты и не рекомендуется для производства коммерческого кода. Поскольку в нем есть ошибки и даже незаконченные части. Но нельзя считать его бесполезным и Борланд постоянно выпускает новые версии.
Поскольку это бета, то она накладывает ограничения на распространение программ, написанных с помощью DCCIL. Любой код, который создан с помощью DCCIL, также должен распространяться как бета.
20.1.2.2. Версия Delphi 8.
Borland довольно молчалив по поводу Delphi 8. Тем не менее, опираясь на публичные высказывания мы может сделать кое какие вывод насчет Delphi 8. Видно, это будет не Delphi .NET, а расширение для платформы Windows. (От переводчика: это не подтвердилось.).
20.1.2.3. Проект SideWinder.
Так же есть новости о проекте SideWinder от Борланд. Конечно это не конечное имя, а кодовое имя, которое Борланд назначил для разработки.
SideWinder так же не Delphi .NET. SideWinder – это среда разработки C# для .NET, которая, будет конкурировать с Microsoft Visual Studio .NET.
20.1.2.4. Проект Galileo.
Galileo – это кодовое имя Борланд для повторно используемой среды. Это первый продукт, который использует SideWinder и Galileo предназначен как базис для построения среды Delphi .NET, когда она будет выпущена.
20.1.3. Разные среды (Frameworks).
20.1.3.1. Среда .Net Framework.
Среда .NET framework – это библиотека классов, которая является ядром .NET. Данная библиотека классов включает классы для ввода/вывода, хранения данных, простые типы, комплексные типы, доступ к базам, пользовательский интерфейс и многое другое. То чем VCL является для Delphi программистов, тем же является для .NET программистов.
АПИ Win32 ушло и было заменено классами в среде .NET, которое предоставляет лучшую и более абстрактную платформу с независимым интерфейсом. Так же предоставлен и прямой доступ до Win32 API, и до DLL. Тем не мене использования подобного доступа делает ваш код не обслуживаемым и нежелательным в .NET приложениях.
20.1.3.2. Среда WinForms.
Среда WinForms – это сборка в .NET framework, которая включает классы для форм, кнопки, органы редактирования и другие элементы GUI для построения GUI приложений. Среда WinForms – это .Net управляемы интерфейс к Win32 API и – это то, что Visual Studio .NET использует для построения GUI приложений.
20.1.3.3. Библиотека времени исполнения RTL.
Библиотека времени исполнения RTL содержит не визуальные низкий уровень классов в Delphi, такие как TList, TStrings и другие.
Библиотека времени исполнения RTL – также доступна и в Delphi .NET. Многое из того, что есть в RTL имеет своих двойников в .NET framework, но предоставив RTL Borland сделал более простым перенос существующего кода, без необходимости переписывать большие куски кода и позволяет создавать кросс платформенный код.
20.1.3.4. Библиотека CLX.
Данная часть, вносит некоторый конфуз. До Delphi 7 было следующее разделение:
· VCL - Visual Component Library. VCL - библиотека визуальных компонент, что относилось к визуальным компонентам, к не визуальным компонентам и к RTL.
· CLX (Pronounced "Clicks") - Component Library for Cross Platform - CLX относилось к новой версии кросс платформенной части VCL, которая базировалась на QT и могла работать как в Linux, так и в Windows.
Теперь же, после выхода Delphi 7, Borland реорганизовал и переопределил значение данного акронима. Это может привести в большое замешательство, по этому примите во внимание. Начиная с Delphi 7 новое назначение следующее:
· CLX - CLX относится ко всем компонентам включенным в Delphi, C++ Builder и в Kylix.
· VCL - VCL относится к визуальным компонентам, которые работают напрямую с Win32 API.
· Visual CLX - Visual CLX относится к кросс платформенным визуальным компонентам, которые базируются на QT, доступны и в Delphi и в Kylix.
· VCL for .NET - VCL for .NET относится к новой VCL, которая запускается под .NET и предоставляет слой совместимости для старых приложений и плюс дополнительную функциональность.
Если вы посмотрите на новые определения, я не уверен, что они согласованы. Я думаю в будущем они приведут к будущим недоразумениям. Я думаю NLX (Nelix?), или NCL (Nickel?), или что ни будь еще более more совместимое будет лучшим выбором для VCL .Net. Как видим, Visual CLX – это подмножество от CLX, не VCL for .NET – это родной брат VCL, как и Visual CLX.
Это должно выглядеть так:
· VCL --> CLX
· CLX --> Visual CLX
· Visual Parts of VCL --> VCL
Хорошо, пусть это все будут мечты.
20.1.3.5. Среда VCL for .Net.
Среда VCL for .NET относится к новому VCL, который работает под .NET и предоставляет уровень совместимости для старых приложений и добавляет дополнительную функциональность.
Среда VCL for .NET позволяет сделать более быстрый перенос существующих приложений, аналогично Win32 VCL и CLX. Это позволяет продолжать разработку кросс платформенных приложений. Это важное свойство, которое позволяет продолжать поддержку Windows приложений без .NET framework и также Linux.
20.1.3.6. Что выбрать WinForms или VCL for .Net?
Это область для сомнений у пользователей – должен я использовать WinForms или VCL for .NET для разработки GUI?
Следующая таблица сравнений позволит вам сделать правильный выбор. Должны быть установлены жесткие правила, но каждое приложение должно обслуживаться независимо.
VCL for .Net. WinForms. Большой размер дистрибутива, поскольку должен включать дополнительные сборки. Малый размер дистрибутива, поскольку все сборки входят в состав .NET framework. Только для платформы Win32. Возможны подмножества для compact .NET framework for pocket PC's. можно переносить на другие реализации .NET. Высокая степень совместимости со старым кодом. Требуются значительные изменения в существующем коде. Кросс платформенность с VCL for Win32 и с Visual. Только для .Net framework.
CLX for Linux (и Windows). Более эффективно в некоторых областях. Не поддерживает всю оптимизацию, которая есть в VCL. Дополнительные свойства и классы. Это включает дополнительные визуальные органы, но теряются такие вещи как списки действий (action lists), базы данных и многое другое. Не доступен полный исходный код. Не доступен исходный код.
Другая возможность – вы можете смешивать код. VCL for .NET и WinForms не исключают друг друга и могут сосуществовать в одном приложении.
20.1.4. Дополнения по переносу.
Некоторые из дополнений в Delphi .NET очень важны для переноса приложений, а некоторые нет. Данные вещи не являются жизненно важными и поэтому будут рассмотрены очень кратко.
20.1.4.1. Маппирование типов в CTS.
Что бы работать с .NET классами все языки должны использовать CTS (Common Type System). Delphi .NET может делать это просто, в дополнение к типам Delphi. Это может иметь место в ситуации, когда обычный Delphi код использует один набор типов, а интерфейсы к .NET использует другой набор. В результате потребуется постоянное копирование данных туда и обратно, поэтому это не очень хорошая идея с .NET. Подобная ситуация аналогична ситуацией с COM.
Ел избежание подобной проблемы, родные типы в Delphi .NET имеют их маппированые типы в CTS. Так что при объявлении Integer, это в реальности .NET Integer из CTS. Данная связь не ограничена только простыми типами, но также расширена и на объекты.
Здесь приведен список некоторых подстановок:
Delphi .Net. Common Type System. String. System.String. Variant. System.ValueType. Records. System.ValueType. Exception. System.Exception. TObject. System.Object. TComponent. System.ComponentModel.Component.
20.1.4.2. Пространство имен (Namespaces).
Во избежание конфликтов и также как часть CLS (Common Language Specification), Delphi теперь поддерживает пространство имен. Каждый модуль теперь существует внутри пространства имен.
Когда вы видите объявление подобное следующему:
Code: Uses. Borland.Delphi.SysUtils; Var. GStatus: System.Label;
| Преобразование иконок в Gliph-ы |
Вот небольшой пример того, как можно загрузить иконку, содержащуюся в файле EXE, в Glyph у SpeedButton, и как очистить этот самый Glyph.
| Преобразование количества секунд в формат TTIME. |
| Преобразование координат в параметрах событий OnDragOver и OnDragDrop, в координаты формы. |
Автор: Neil.
| Преобразование числа в двоичную запись |
Для преобразования числа в двоичную запись удобно использовать функции shl и and. Эта функция преобразует число в строку из единиц и нулей. Количество цифр определяется параметром Digits.
| Преобразование сроки в число |
| String --> Ascii. |
| Преобразование Unicode строк в DFM файлах Delphi 6 в Ansi строки |
| Преобразовать первую букву каждого слова к верхнему регистру в TEdit. |
Code: Procedure TForm1.Edit1Change(Sender: TObject); Var. OldChange: TNotifyEvent; OldStart: Integer; Begin. With (Sender as TEdit) do. Begin. OldChange := OnChange; OnChange := nil; OldStart := SelStart; If ((SelStart > 0) and (Text[SelStart - 1] = ' ')) or (SelStart = 1) then. Begin. SelStart := SelStart - 1; SelLength := 1; SelText := AnsiUpperCase(SelText); End; OnChange := OldChange; SelStart := OldStart; End; End;
| Преобразовать Персидскую дату в дату по Грегорианскому календарю |
| Напечатать миллиметровку |
Code: Program PrnGrid; Uses. Dialogs, Printers, Windows, Types; {$R *.res}. Function GetPenWidth(I: Integer): Integer; Begin. If I mod 100 = 0 then. Result := 45. Else if I mod 50 = 0 then. Result := 30. Else if I mod 10 = 0 then. Result := 20. Else if I mod 5 = 0 then. Result := 15. Else. Result := 10; End; Var. PageRect: TRect; I, J: Integer; Begin. With TPrintDialog.Create(nil) do. Try. If not Execute then. Exit; Finally. Free; End; PageRect := Rect(0, 0, Printer.PageWidth, Printer.PageHeight); Printer.Title := 'Милиметровка'; Printer.BeginDoc; Try. Try. With Printer.Canvas do. Begin. SetMapMode(Handle, MM_HIMETRIC); DPtoLP(Handle, PageRect, 2); With PageRect do. Begin. Inc(Left, 1000); Dec(Top, 1000); Dec(Right, 1000); Inc(Bottom, 1000); End; J := 0; I := PageRect.Left; While I < PageRect.Right do. Begin. Pen.Width := GetPenWidth(J); MoveTo(I, PageRect.Top); LineTo(I, PageRect.Bottom); Inc(I, 100); Inc(J); End; J := 0; I := PageRect.Top; While I > PageRect.Bottom do. Begin. Pen.Width := GetPenWidth(J); MoveTo(PageRect.Left, I); LineTo(PageRect.Right, I); Dec(I, 100); Inc(J); End; End; Except. Printer.Abort; Raise; End; Finally. Printer.EndDoc; End; End.
| Преодоление барьера в 8000 символов в динамическом SQL. |
Code: --©Drkb v.3(2007): www.drkb.ru. Declare @sql1 varchar(8000), @sql2 varchar(8000). Set @sql1='Select * From MyTable' Set @sql2='Where MyField=''Something''' Exec (@sql1+@sql2).
©Drkb::02812.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
| Панель с двумя полосами слева, которые можно двигать |

Для создания панелей в двумя полосами слева, которые можно двигать друг относительно друга, используют компонент ControlBar (вкладка Additional), на котором обычно размещают один или несколько ToolBar (вкладка Win32). Чтобы сделать возможным "вытаскивание" панели из ControlBar нужно написать следующий код:
Code: Procedure TForm1.FormCreate(Sender: TObject); Begin. ToolBar1.DockSite := true; ToolBar1.DragKind := dkDock; ToolBar1.DragMode := dmAutomatic; End; Procedure TForm1.ControlBar1DockOver(Sender: TObject; Source: TDragDockObject; X, Y: Integer; State: TDragState; Var Accept: Boolean); Begin. Accept := (Source.Control is TToolBar); If Accept then. With Source.DockRect do. Begin. TopLeft := ControlBar1.ClientToScreen(ControlBar1.ClientRect.TopLeft); Right := Left + Source.Control.Width; Bottom := Top + Source.Control.Height; End; End;
| Панель с изменяющимися размерами |
Привожу исходный код для создания панелей с изменяющимися размерами. Воровняйте панель по области клиента свойством alClient, расположите на ней несколько элементов управления и посмотрите как меняются размеры во время изменения размера формы при выполнении программы. Можно расширить код и запретить изменения размеров во время проектирования, но это я оставляю для вас. Данная технология может и не идеальна, поскольку я накропал код за считанные минуты, но для выполнения моих задач этого достаточно.
| Обмен значениями элементов TListView. |
Today I want to describe how you may exchange some items in standard TListView.
For example, you have 5 items and want to swap.
Positions for first and third items.
Обмен информацией между Вашими программами в сети по почтовым каналам.
| Обмен информацией между Вашими программами в сети по почтовым каналам |
Обмен информацией между Вашими программами в сети по почтовым каналам.
Как реализовать обмен информацией между Вашими приложениями в сети? ОС Windows предлагает несколько технологий. Эта статья опишет один очень простой и надежный способ для Win9x/NT - MailSlots. The CreateMailslot function creates a mailslot with the specified name and returns a handle that a mailslot server can use to perform operations on the mailslot. The mailslot is local to the computer that creates it. An error occurs if a mailslot with the specified name already exists. Обмен текстовыми данными в локальной сети очень прост. Для этого необходимы три функции:
· CreateMailslot - создание почтового канала;
· GetMailslotInfo - определение наличия сообщения в канале;
· ReadFile - чтение сообщения из канала, как из файла;
· WriteFile - запись сообщения в канал, как в файл;
Функции работы с почтовыми каналами присутствуют как в Windows 9x, так и в Windows NT. Рассмотрим создание почтового канала (сервер).
Code: //... создание канала с именем MailSlotName - по этому имени к нему. // будут обращаться клиенты. H := CreateMailSlot(PChar('\\.\mailslot\' + MailSlotName), 0, MAILSLOT_WAIT_FOREVER,nil); If h = INVALID_HANDLE_VALUE then begin. Raise Exception.Create('MailSlotServer: Ошибка создания канала !');
Отправка сообщений по почтовомуо каналу (клиенты).
Code: If not GetMailSlotInfo(h,nil,DWORD(MsgNext),@MsgNumber,nil) then. Begin. Raise Exception.Create('TglMailSlotServer: Ошибка сбора информации!'); End; If MsgNext <> MAILSLOT_NO_MESSAGE then begin. Beep; // чтение сообщения из канала и добавление в текст протокола. If ReadFile(h,str,200,DWORD(Read),nil) then. MessageText := str. Else. Raise Exception.Create('TglMailSlotServer: Ошибка чтения сообщения !'); End;
Все очень просто. Теперь для удобства использования создадим два компонента - клиент и сервер
Code: { Globus Delphi VCL Extensions Library. ' GLOBUS LIB ' Freeware. Copyright (c) 2000 Chudin A.V, FidoNet: 1246.1. =================================================================== Gl3DCol Unit 05.2000 components TglMailSlotServer, TglMailSlotClient. =================================================================== } Unit glMSlots; Interface. Uses. Windows, Messages, SysUtils, Classes, Graphics, Controls, Forms, Dialogs, extctrls; Type. TOnNewMessage = procedure (Sender: TObject; MessageText: string) of object; TglMailSlotServer = class(TComponent). Private. FMailSlotName, FLastMessage: string; FOnNewMessage: TOnNewMessage; Timer: TTimer; //...таймер для прослушивания канала. H : THandle; Str : string[250]; MsgNumber,MsgNext,Read : DWORD; Public. Constructor Create(AOwner: TComponent); override; Destructor Destroy; override; Procedure Open; //...создание канала. Procedure Close; //...закрытие канала. Protected. Procedure Loaded; override; Procedure OnTimer(Sender: TObject); Published. Property MailSlotName: string read FMailSlotName write FMailSlotName; //...событие получения сообщения. Property OnNewMessage: TOnNewMessage read FOnNewMessage write FOnNewMessage; End; TglMailSlotClient = class(TComponent). Private. FMailSlotName, FServerName, FLastMessage: string; Public. Constructor Create(AOwner: TComponent); override; Destructor Destroy; override; Function Send(str: string):boolean; //...отправка сообщения. Protected. Procedure Loaded; override; Procedure ErrorCatch(Sender : TObject; Exc : Exception); Published. Property ServerName: string read FServerName write FServerName; Property MailSlotName: string read FMailSlotName write FMailSlotName; End; Procedure Register; Implementation. Procedure Register; Begin. RegisterComponents('Gl Components', [TglMailSlotServer, TglMailSlotClient]); End; Constructor TglMailSlotServer.Create(AOwner: TComponent); Begin. Inherited; FEnabled := true; FMailSlotName := 'MailSlot'; Timer := TTimer.Create(nil); Timer.Enabled := false; Timer.OnTimer := OnTimer; End; Destructor TglMailSlotServer.Destroy; Begin. Timer.Free; // закрытие канала. Close; Inherited; End; Procedure TglMailSlotServer.Loaded; Begin. Inherited; Open; End; Procedure TglMailSlotServer.Open; Begin. // создание канала с именем MailSlotName - по этому имени к нему. // будут обращаться клиенты. H := CreateMailSlot(PChar('\\.\mailslot\' + MailSlotName), 0, MAILSLOT_WAIT_FOREVER,nil); //h:=CreateMailSlot('\\.\mailslot\MailSlot',0,MAILSLOT_WAIT_FOREVER,nil); If h = INVALID_HANDLE_VALUE then begin. Raise Exception.Create('TglMailSlotServer: Ошибка создания канала !'); End; Timer.Enabled := true; End; Procedure TglMailSlotServer.Close; Begin. If h <> 0 then CloseHandle(h); H := 0; End; Procedure TglMailSlotServer.OnTimer(Sender: TObject); Var. MessageText: string; Begin. MessageText := ''; // определение наличия сообщения в канале. If not GetMailSlotInfo(h,nil,DWORD(MsgNext),@MsgNumber,nil) then. Begin. Raise Exception.Create('TglMailSlotServer: Ошибка сбора информации!'); End; If MsgNext <> MAILSLOT_NO_MESSAGE then. Begin. Beep; // чтение сообщения из канала и добавление в текст протокола. If ReadFile(h,str,200,DWORD(Read),nil) then. MessageText := str. Else. Raise Exception.Create('TglMailSlotServer: Ошибка чтения сообщения !'); End; If (MessageText<>'')and Assigned(OnNewMessage) then OnNewMessage(self, MessageText); FLastMessage := MessageText; End; //------------------------------------------------------------------------------ Constructor TglMailSlotClient.Create(AOwner: TComponent); Begin. Inherited; FMailSlotName := 'MailSlot'; FServerName := ''; End; Destructor TglMailSlotClient.Destroy; Begin. Inherited; End; Procedure TglMailSlotClient.Loaded; Begin. Inherited; Application.OnException := ErrorCatch; End; Procedure TglMailSlotClient.ErrorCatch(Sender : TObject; Exc : Exception); Var. UserName: array[0..99] of char; I: integer; Begin. // получение имени пользователя. I:=SizeOf(UserName); GetUserName(UserName,DWORD(i)); Send('/'+UserName+'/'+FormatDateTime('hh:mm',Time)+'/'+Exc.Message); // вывод сообщения об ошибке пользователю. Application.ShowException(Exc); End; Function TglMailSlotClient.Send(str: string):boolean; Var. StrMess: string[250]; UserName: array[0..99] of char; H: THandle; I: integer; Begin. // открытие канала : MyServer - имя сервера. // (\\.\\mailslot\xxx - монитор работает на этом же ПК). // xxx - имя канала. If FServerName = '' then FServerName := '.\'; H:=CreateFile( PChar('\\' + FServerName + '\mailslot\' + FMailSlotName), GENERIC_WRITE, FILE_SHARE_READ,nil,OPEN_EXISTING, 0, 0); If h <> INVALID_HANDLE_VALUE then. Begin. StrMess := str; // передача текста ошибки (запись в канал и закрытие канала). WriteFile(h,strMess,Length(strMess)+1,DWORD(i),nil); CloseHandle(h); End; Result := h <> INVALID_HANDLE_VALUE; End; End.
Компонент TglMailSlotServer создает почтовый канал с именем MailSlotName и принимает входящие ссобщения. Компонент TglMailSlotClient отправляет сообщения в канал с именем MailSlotName на машине ServerName. Эти компонеты входят в состав библиотеки GlobusLib, распространяемой с исходными текстами. Вы можете скачать ее на тут.
составление статьи: Андрей Чудин, ЦПР ТД Библио-Глобус.
Взято из http://delphi.chertenok.ru.
©Drkb::02082.
| Обмен информацией по TCP/IP-протоколу |
Обмен информацией по TCP/IP-протоколу
© 2004 Рудюк С.А. rudjuk.kiev.ua.
Часто возникает необходимость обмениваться данными между программами на разных компьютерах. Например, это необходимо в чатах, или в программах, которые должны реагировать одновременно на одно и то же событие.
Обмен информации между компьютерами можно реализовать большим количеством способов. В данной статье я рассмотрю обмен данными по протоколу TCP/IP.
Компоненты для обмена данными по TCP/IP.
Для обмена данными по протоколу TCP/IP будем использовать три Indy-компоненты:
TIdTCPServer.
 TIdTCPClient.
 TIdThreadMgrDefault.
Клиентская компонента предназначена для посылки и приёма сообщений, а серверная компонента - для приёма сообщения и рассылки клиентским компонентам.
<>
Программа состоит из двех частей: серверная, на которой стоит серверная компонента, можно на неё ещё поставить и клиентскую компоненту - для тестирования клиентской части и возможности генерации сообщений с серверной программы. На клиентской части - стоит только клиентская компонента. Эта часть предназначена только для посылки и приёма сообщений.
Серверная часть
Установим на форму в программе серверной части компоненты TIdTCPServer , TIdThreadMgrDefault .
Свяжите свойство ThreadMgr компоненты TIdTCPServer с компонентой TIdThreadMgrDefault.
Для запуска сервера хватит установить свойство компоненты в True:
Code: Server.Active := True; Protocol.Lines.Add('=== Запуск сервера ====');
| Обмен строк TStringGrid. |
Code: { **** UBPFD *********** by delphibase.endimus.com **** >> Обмен строк StringGrid. Обмен содержимого указанных строк StringGrid. Варианты без копирования связанных с ячейками объектов и вместе с ними. Зависимости: Grids. Автор: Борис Новгородов (MBo), mbo@mail.ru, Новосибирск. Copyright: MBo. Дата: 27 апреля 2002 г. ***************************************************** } Procedure SGExchangeRows(SG: TStringGrid; Row1, Row2: Integer); Var. TempString: string; Begin. If (Row1 in [0..SG.RowCount - 1]) and (Row2 in [0..SG.RowCount - 1]) then. Begin. TempString := SG.Rows[Row1].Text; SG.Rows[Row1].Assign(SG.Rows[Row2]); SG.Rows[Row2].Text := TempString; End; End; Procedure SGExchRowsWithObj(SG: TStringGrid; Row1, Row2: Integer); Var. TempList: TStringList; Begin. With SG do. If (Row1 in [0..RowCount - 1]) and (Row2 in [0..RowCount - 1]) then. Begin. TempList := TStringList.Create; TempList.Assign(Rows[Row1]); Rows[Row1].Assign(Rows[Row2]); Rows[Row2].Assign(TempList); TempList.Free; End; End;
©Drkb::01063.
Обнаружение разъединения.
| Обнаружение разъединения |
9. Обнаружение разъединения.
Поскольку Indy блокирующая по природе, и ее события используются только для обработки состояния, поэтому в ней нет событий оповещения о неожиданном разъединении соединения. Если вызов чтения или записи находится в состоянии исполнения и происходит неожиданный разрыв соединения, то вырабатывается исключение. Если же в этот момент нет вызова на чтение/запись, то исключение возникнет при первом вызове.
Имеется событие OnDisconnected, но это не то, о чем вы подумали. Событие OnDisconnected возникает при вызове метода Disconnect. Это событие никак не связано с неожиданным разъединением.
9.1. Скажем прощай.
В TCP протоколах, базирующихся на командах, самый простой путь завершить работу это сказать прощай (good bye). Эта команда распознается, только при наличии действующего соединении, но даже это большое удобство.
Чтобы завершить работу, протоколы используют команду QUIT. Когда клиент готов завершить работу, вместо немедленного разъединения, сначала попробуйте послать команду QUIT на сервер. Затем подождите ответа и только после этого производите отсоединение сокета.
Это хорошие манеры и позволяет обеим сторонам произвести правильное разъединение. Не делайте это как в телефонном разговоре, просто вешая трубку. Вы же не знаете, что произойдет в данном случае.
Разница в том, что сервер может иметь сотни и тысячи клиентских соединений. Если они все отсоединятся без оповещения сервера, то сервер будет продолжать держать кучу мертвых соединений.
9.2. А нужно ли вам реально знать это?
Многие программисты ошибаются, считая, что они должны немедленно узнать, что соединение неожиданно прервалось. Вы наверно слышали следующую сентенцию – «если дерево падает в лесу и никто при этом не присутствует, то кто услышит звук?». Если сокет отсоединяется, и он становится не доступным, то в действительно ли сокет закрывается? В большинстве случаев ответ НЕТ. Если сокет физически отсоединен и недоступен, то исключение не будет возбуждено, до тех пор, пока не будет произведена попытка доступа к сокету.
Это может казаться странным, но это также как при работе с файлами. Представим себе, что вы открыли таблицу Экселя с гибкого диска, и затем вынули диск из дисковода. Вы можете продолжать работать с файлом, потому что он кэширован в памяти и Эксель, в данный момент, не обращается к физическому файлу. Иногда в течение этого времени вы забываете, что вы вынули дискету из дисководу. Позже вы продолжаете работу с вашей таблицей, все прекрасно пока вы не захотите сохранить ваши изменения. Только в этот момент вы получите сообщение об ошибке. Эксель не получает "EAnIdiotRemovedTheFloppyDiskException", когда вы вынули дискету, но он имеет открытый файл на этом диске.
9.3. Я должен знать это немедленно!
Повторим, что исключение не возникает немедленно. Например, если вы вытащите сетевой кабель из платы или коммутатора, то может потребоваться минута или более. TCP/IP был разработан военными Америки, чтобы иметь устойчивый сетевой протокол, способный противостоять ядерным атакам. Поэтому он спроектирован так, что сеть ждет некоторое время ответов с другой стороны соединения и пытается делать повторные запросы. Вы можете детектировать разрыв соединения немедленно, но иным путем, чем это реализовано в TCP/IP. Данное детектирование может быть реализовано, но очень важно понять, почему для этого нет стандартных функций. Это понимание поможет вам понять, как это можно реализовать.
В большинстве случаев, если вы думаете об этом, вы поймете, что данное поведение приемлемое и даже желательное.
Тем не менее, есть ситуации, когда очень важно немедленно знать о потере соединения. Вообразим, что вы реализовали интерфейс между монитором сердечной деятельности и телеметрической системой. В этом случае, вы определенно желаете знать, что соединение потеряно как можно раньше.
Если вы нуждаетесь в немедленном оповещении о разъединении, то вы должны встроить эту возможность в протокол.
9.3.1. Keep Alives.
Keep alive (хранить живым) – это один из методов, детектирования немедленных разъединений. Keep alive реализован так, что одна сторона соединения на основе регулярного интервала посылается сообщение, такое как NOOP (No Operation – нет операции) другой стороне и всегда ожидает ответа. Если ответ не получен в течение указанного времени, то соединение считается проблематичным и уничтожается. Период таймаута достаточно короткий и определятся задачами протокола. Если вы реализуете соединение с сердечным монитором, то вы надеетесь, что указанный таймаут короче, чем таймаут для контроля температуры бочонка с пивом.
Есть и другие преимущества при реализации системы keep alive. Во многих случаях, соединение TCP может оставаться действительным, даже если процесс перестал отвечать и принимать сообщения. В других случаях, процесс может продолжать обслуживать запросы, но скорость может быть очень низкой из-за проблем в сервисе, или из-за уменьшения полосы пропускания сети. Keep alive может определять эти ситуации и отмечать их как непригодные, хотя соединение еще существует.
Keep alive запрос может посылаться на регулярной основе или при необходимости, когда требует определить состояние, в зависимости от требований протокола.
9.3.2. Пинги (Pings).
Пинги – это реализация, подобная keep alive, за исключением, что они не возвращаются в ответе на запрос. Пинги посылаются с одной стороны соединения, на другую на основе регулярного интервала. Одна сторона становится отправителем, а вторая монитором. Если в течение указанного интервала времени на мониторе, ответа не будет, то соединение считается непригодным и уничтожается.
Пинги могут считаться аналогичными биениям сердца. Если они становятся редкими, то это означает проблему.
9.4. Исключение EIdConnClosedGracefully.
Многих Indy пользователей беспокоит исключение EIdConnClosedGracefully, которое часто возбуждается серверами, особенно HTTP и другими серверами. Исключение EIdConnClosedGracefully сигнализирует, что другая сторона умышленно закрыла соединение. Это не тоже самое, как потерянное соединение, которое может появляется в случае ошибки соединения. Если другая сторона закрыла соединение и сокет пытается писать или читать из него, то возбуждается исключениеЕIdСоnnС1оsеdGгасеfи11у. Это подобно попытке чтения или записи в файл, который был закрыт без вашего оповещения.
В некоторых случаях – это подлинное исключение и ваш код должен его обработать. В других случаях (обычно в серверах) это нормальное функционирование протокола и Indy обработает это за вас. Даже если Indy поймала его, когда вы работали в отладчике, то оно возбуждается в нем. Вы просто должны нажать F9 и продолжать и Indy обслужить это исключение, но отладчик постоянно надоедает вам. В том случае когда Indy ловит подобное исключение, ваши пользователи никогда не видят его в ваших программах, если только программа не запущена под отладчиком IDE.
9.4.1. Введение.
9.4.2. Почему случаются исключения на серверах?
Когда клиент подсоединяется к серверу, то имеются два пути к разъединению соединения:
1. Взаимное соглашение – обе стороны согласны взаимно разъединиться, если одна из сторон попросит об этом и обе стороны явно разъединяются.
2. Одностороннее разъединение – разъединение и оповещение другой стороны об этом.
С помощью взаимного соглашения обе стороны знают когда разъединяться и обе явно производят разъединение. Большинство протоколов обмена, такие как Mail, News и другие разъединяются подобным образом.
Когда клиент готов разъединиться, то он посылает команду серверу, оповещая его о своем желании. Сервер отвечает подтверждением и затем обе стороны закрывают соединение. В этих случаях исключение EIdConnClosedGracefully не возникает и если это случается, то это означает ошибку, которая должна быть соответственно обработана.
В некоторых случаях взаимного соглашения не используется команда, но обе стороны знают когда другая может отсоединиться. Часто клиент подсоединяется, посылает одну команду, получает ответ и отсоединяется. Когда не используются явные команды для отсоединения, протокол определяет, что клиент должен отключиться от сервера после посылки команды и получения ответа. Примером этого являются некоторые протоколы времени.
При одностороннем разъединении одна сторона просто отсоединяется. Другая сторона продолжает следить и как только определяет разрыв, то прекращает сессию. В протоколах, которые используют это, вы получите исключение EIdConnClosedGracefully и это нормальное поведение для них. Это исключение, но Indy в курсе и обработает это за вас. Протокол whois пример данного поведения. Клиент подсоединяется к серверу и посылает строку запроса. Сервер затем посылает ответ и отсоединяется. Ни каких других сигналов клиенту не посылается, просто производится разъединение.
Протокол HTTP позволяет оба вида – разъединение по взаимному соглашению и одностороннее разъединение и поэтому понятно, почему вы видите иногда исключение EIdConnClosedGracefully с HTTP серверами. Протокол HTTP 1.0 работает подобно протоколу whois, в том смысле, что сервер не посылает сигнала о разъединении и клиент должен просто разъединиться после получения ответа. Клиент должен использовать новое соединение для каждого запроса.
Протокол HTTP 1.1 позволяет в одном соединение запрашивать несколько документов. Тем не менее нет команды разъединения. В любое время, или клиент, или сервер могут разъединиться после получения ответов. Когда клиент разъединяется, но сервер еще продолжает воспринимать запросы, то возникает исключение EIdConnClosedGracefully. В большинстве случаев в HTTP 1.1, клиент единственный, кто разъединяется. А сервер разъединяется как сделано в части реализации протокола HTTP 1.1, если не используется установка keep alive.
9.4.3. Почему это исключение?
Многие пользователи комментируют, что здесь должен быть сигнал об отсоединении, а не исключение. Но это неверный подход в данном случае.
Исключение EIdConnClosedGracefully возбуждается из ядра, глубоко внутри, в нескольких методах. Исключение EIdConnClosedGracefully в действительности исключение и в большинстве случаев должно быть поймано самым верхним уровнем для обработки. Исключение - это правильный путь для этого.
9.4.4. Это ошибка?
Не все исключения – это ошибки. Многие разработчики считают и уверены, что все исключения это ошибки. Это не так. Именно поэтому они названы исключениями, а не ошибками.
Delphi и C++ Builder используют исключения, для обработки ошибок, элегантным путем. Тем не менее исключения могут использоваться не только в случае ошибок. Примером этого является EAbort. Исключения подобного рода используются для изменения потока исполнения и для связи с более высоким уровнем в программе, где они будут пойманы. Indy использует исключения подобным образом.
9.4.5. А когда это ошибка?
Когда исключение EIdConnClosedGracefully возникает на клиенте, то это является ошибкой и должно быть поймано и обработано.
На сервере это исключение. Тем не менее иногда это ошибка и иногда это исключение. Во многих протоколах данное исключение это часть нормального функционирования протокола. Это общее поведение, и если вы не ловите EIdConnClosedGracefully на вашем сервере, то Indy сделает это. Это пометит соединение как закрытое и остановит рабочий поток, назначенный соединению. Если вы желаете, вы можете сами обработать данное исключение, иначе Indy сделает это за вас.
9.4.6. Простое решение.
Исключение EIdConnClosedGracefully это базовый класс исключения, особенно для некоторых серверов, оно унаследовано от EIdSilentException. На закладке Language Exceptions tab of Debugger Options (Tools Menu) вы может добавить исключение EIdSilentException в список игнорируемых исключении. После этого добавленное исключение, если оно случится в коде будет обработано в программе, но отладчик не будет прерывать программу для обработки в среде.
| Обнаружение прокрутки TMemo. |
Автор: Xavier Pacheco.
| Манипуляция словами в TStringGrid. |
Code: Procedure TForm1.StringGrid1KeyPress(Sender: TObject; var Key: Char); Var. S: string; C: Byte; Begin. With StringGrid1 do. S := Cells[Col, Row]; If Length(s) = 0 then. Begin. If Key in ['a'..'z'] then. Begin. C := Ord(Key) - 32; Key := Chr(c); End; Exit; End; If s[Length(s)] = ' ' then. If Key in ['a'..'z'] then. Begin. C := Ord(Key) - 32; Key := Chr(c); End; End; //В обработчике события onKeyPress сделайте следующее: If length(field.text) = 0 then. Key := upCase (key);
| Написание приложений под .NET Framework 2.0 в Delphi 8 – Delphi 2006. |
Статья детально описывает шаги, которые необходимо выполнить, чтобы написать и скомпилировать полноценное .NET 2.0 приложение в Delphi8, Delphi 2005 или BDS 4 под второй фреймворк (Microsoft .NET 2.0 Framework).
1.0. Введение
Как нам всем известно, Borland на данный момент переживает не самые лучшие времена. Delphi похоже в скором времени сменит своего хозяина, но а тем временем мир не стоит на месте. После выхода BDS 4 (Borland Developer Studio 4, он же Delphi 2006) появился Microsoft .NET Framework 2.0, значительно более улучшенный, нежели его предшественник, и перед программистами, работающими в Delphi, встал закономерный вопрос – «Когда появится следующая BDS, поддерживающая .NET Framework 2.0?». К сожалению, официально ни Delphi 8, ни Delphi 2005, ни BDS 4 не поддерживают фреймворк второй версии, что открывает перед Delphi программистами не совсем радужную перспективу. Ведь они фактически остаются «не у дел».
Но пока новая версия BDS находится в разработке, многие программисты естественно стали искать пути «научить» BDS 4 работе с .NET 2.0. Цель данной статьи заключается в том, чтобы подробно описать те шаги, которые необходимо сделать для успешного создания полноценных .NET 2.0 приложений в текущих версиях Delphi, начиная с восьмой.
NET Framework 2.0 в отличие от своего предшественника предоставляет целый ряд новых элементов управления и множество новых классов, благодаря чему, приложения, написанные под него больше не будут походить на те, что писались во времена первой Delphi с минимальным набором элементов управления и классов. Естественно, Я обращу внимание именно на эти нововведения. Но для начала, Я расскажу о том, в чём секрет создания .NET 2.0 приложений под BDS 4.
Внимание: В этой статье Я буду ориентироваться на BDS 4, так как не имею под рукой компиляторов от восьмёрки и Delphi 2005. Если у Вас Delphi младше 2006, то Я не могу гарантировать работоспособность примеров, описанных в статье. Тем не менее, обе предыдущие версии Delphi имеют .NET компилятор и Я не думаю, что он кардинально отличается от того, что есть в BDS 4.
2.0. Использование .NET компилятора Delphi и работа с его командной строкой.
Есть несколько способов получения скомпилированного приложения. Первый это использование для компиляции самой среды BDS (или сторонней среды, если таковая имеется), а второй это работа с Delphi .NET компилятором напрямую, посредством командной строки. Именно этот второй способ и есть ключ к созданию .NET 2.0 приложений в Delphi.
Дело в том, что .NET компилятор Delphi разрешает указание версии фреймворка, который будет использован для компиляции данного приложения. Поэтому, если на вашей машине установлен второй фреймворк, то мы сможем указать для компиляции именно его. А это значит, что мы автоматически получим возможность использовать и все нововведения второго фреймворка.
Обратная сторона медали заключается в том, что мы не сможем «нормально» писать программу. Например, если Вы пишете WinForms приложение, то, скорее всего, используете дизайнер форм для создания интерфейса приложения. Но так как BDS 4 не поддерживает второго фреймворка, то Вы не сможете располагать на форме его элементы управления. Кроме того, Вы не сможете пользоваться Code Insight возможностями среды. Одним словом, писать полноценные .NET 2.0 приложения возможно. Это трудно и утомительно, долго и изматывающе, из вашей комнаты будет, скорее всего, доноситься трёхэтажный мат, но это возможно.
В следующей главе Я подробно расскажу о параметрах командной строки, которые мы будем использовать, и мы приступим к написанию нашего первого .NET 2.0 приложения в Delphi, если так можно сказать.
2.1. Настройка компилятора с помощью командной строки.
Давайте посмотрим на директивы командной строки, которые предлагает .NET компилятор Delphi. Выберите «Пуск -> Выполнить» и введите cmd. В появившемся окне консоли введите dccil –help.
Перед Вами предстанет листинг всех параметров командной строки, поддерживаемых компилятором:
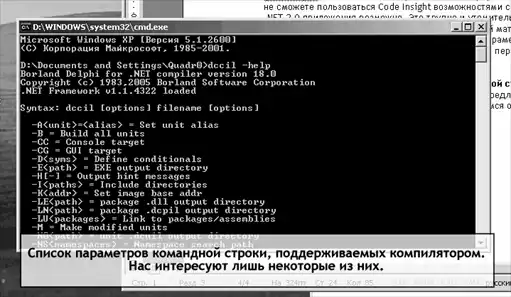
Описание всех этих параметров можно найти в справке Delphi. Нас же больше всего интересует параметр --clrversion, именно он ответственен за выбор версии фреймворка. Кроме того, нам понадобится параметр --no-config, это заставит компилятор не загружать файл конфигурации по умолчанию, который, конечно же, совсем не дружит с .NET Framework 2.0. Кроме этих параметров нам понадобятся ещё несколько, но о них будет сказано по мере написания наших .NET 2.0 программ.
3.0. Написание консольного .NET 2.0 приложения в Delphi.
Вот мы и подошли к самому интересному. Сейчас мы напишем консольное приложение, которое будет использовать новые возможности .NET Framework 2.0. Для наглядного примера Я взял свойства ForegroundColor, BackgroundColor класса Console и класс ConsoleColor, позволяющие изменять внешний вид консоли в приложении. Почему именно они? Да потому что они отсутствуют в .NET 1.1, и потому, если наш эксперимент пройдёт удачно (в чём можно не сомневаться  ), то можно будет смело констатировать факт – полученное приложение есть .NET 2.0 программа.
Итак, запустите BDS 4 for Microsoft .NET и создайте новый консольный проект. Сохраните его, дав название ConsoleApp. Переключайтесь на редактор кода и вводите следующий код:
Program ConsoleApp; {$APPTYPE CONSOLE} begin // В .NET Framework 1.1 отсутствует класс ConsoleColor и свойства // ForegroundColor и BackgroundColor у класса Console. // Поэтому из BDS 4.0, которая обучена работе только с .NET 1.1, // не получится скомпилировать данный проект. // Используйте командную строку, чтобы самостоятельно указать // компилятору нужный framework. Console.ForegroundColor := ConsoleColor.Blue; Console.BackgroundColor := ConsoleColor.Yellow; Console.WriteLine('***************************************'); Console.WriteLine('*** HELLO FROM NET 2.0 Application! ***'); Console.WriteLine('***************************************'); Console.ForegroundColor := ConsoleColor.Green; Console.BackgroundColor := ConsoleColor.Black; Console.WriteLine('Информация о Вашей ОС:'); Console.WriteLine(System.Environment.OSVersion.Version); Console.WriteLine(System.Environment.OSVersion.VersionString); Console.ReadLine; end.
При попытке скомпилировать данное приложение мы естественно получим сообщения об ошибках от компилятора, который безуспешно пытается найти несуществующие в первом фреймворке свойства и классы. Сохраните проект и смело выходите из BDS. Наш следующий шаг – использование .NET компилятора Delphi из командной строки. Создайте make.bat файл в директории с вашим консольным проектом. Мы пропишем синтаксис команды в этом файле, чтобы не указывать полные пути к файлам проекта. Откройте файл для редактирования и введите следующее:
Цитата dccil -CC -NSC:\WINDOWS\Microsoft.NET\Framework\v2.0.50727 --clrversion:v2.0.50727 --no-config ConsoleApp.dpr pause.
Первый параметр (-CC) указывает на то, что мы хотим получить консольное, а не GUI приложение на выходе. Параметр –NS указывает полный путь к библиотекам используемого фреймворка. Параметр –-clrversion заставит компилятор использовать для компиляции проекта второй фреймворк. Далее мы отказываемся от конфига по умолчанию и указываем файл проекта для компиляции. Pause это моя собственная прихоть. Не люблю когда батники автоматически закрываются по завершении задачи . Примечание: Если Windows установлен у Вас не на системном разделе ©, а на другом разделе, то не забудьте изменить путь в параметре –NS на верный. После запуска файла make.bat на исполнение Вы увидите следующее сообщение:

Компилятор сообщит о том, что файл Borland.Delphi.System.dcuil не найден. Это системный файл, в котором содержится описание типов данных и основных классов приложения. Он необходим при компиляции любого .NET приложения. В нашем случае мы должны просто скопировать этот файл в директорию с проектом и перекомпилировать его под второй фреймворк. Делается это следующим образом.
· Скопируйте файл Borland.Delphi.System.pas из директории {$BDS}\ source\dotNet\rtl вашей Delphi в директорию с консольным проектом.
· Создайте файл make_system.bat и пропишите в нём:
Цитата dccil -CC -NSC:\WINDOWS\Microsoft.NET\Framework\v2.0.50727 --clrversion:v2.0.50727 --no-config -Q -M -y -Z -$D- Borland.Delphi.System.pas pause.
· Эта команда приведёт к компиляции Borland.Delphi.System.pas и получению так необходимого нам файла Borland.Delphi.System.dcuil.
Снова запускайте make.bat. В директории проекта появится скомпилированный файл ConsoleApp.exe, а также ещё несколько скомпилированных библиотек второго .NET. Запускайте приложение и вуаля! Мы видим, что приложение прекрасно работает, более того, видно, что текст в консоли имеет разные цвета. Это говорит о том, что классы второго фреймворка дают о себе знать и замечательно работают:
Для ещё большей уверенности можете попробовать запустить это приложение на машине без установленного второго фреймворка.
Как видите, у нас получилось создать полноценное .NET 2.0 приложение. Вы можете пробовать экспериментировать с другими классами и новыми свойствами второго фреймворка и Я Вас уверяю, они будут работать.
Мы написали консольное приложение. Но одной консолью, пусть даже и на втором фреймворке, сыт не будешь. В следующей главе Я расскажу о создании уже WinForms приложения под .NET 2.0.
Примечание: По вполне понятным причинам Я не могу приложить файл Borland.Delphi.System.dcuil к статье, так как он защищён авторскими правами Borland. Не пытайтесь просить меня дать Вам его или выложить где-нибудь. Вы должны самостоятельно получить этот файл, взяв Borland.Delphi.System.pas за основу из вашего собственного дистрибутива BDS.
4.0. Высший пилотаж – пишем полноценное .NET 2.0 WinForms приложение.
Написание WinForms приложения почти ни чем не отличается от написания консольного. Для наглядной демонстрации возможностей .NET 2.0 Я решил привести пример с элементом управления ToolStrip. Этот контролл появился лишь во втором фреймворке и предназначен для создания наборов панелей инструментов в стиле Microsoft Office 2003 или Microsoft Visual Studio 2005. Хотите такие же в своём Delphi .NET приложении? Конечно же, чёрт возьми, хотите . Ну, по крайней мере, сам факт их присутствия в Delphi .NET приложении, написанном в BDS 4 Вас наверное удивит .
Запускайте BDS for Microsoft .NET и создайте новый WinForms проект. Сохраните его под названием WinFormsApp и, оставив форму пустой, закрывайте BDS. Нам она вряд ли ещё понадобится. Далее так же, как и для консольного проекта, создайте файл Borland.Delphi.System.dcuil командой:
Цитата Dccil -CG -NSC:\WINDOWS\Microsoft.NET\Framework\v2.0.50727 --clrversion:v2.0.50727 --no-config -Q -M -y -Z -$D- Borland.Delphi.System.pas pause.
Скопируйте файл make.bat из консольного проекта в текущий и измените его содержание на следующее:
Цитата dccil -CG -NSC:\WINDOWS\Microsoft.NET\Framework\v2.0.50727 --clrversion:v2.0.50727 --no-config WinFormsApp.dpr -luC:\WINDOWS\Microsoft.NET\Framework\v2.0.50727\System.Windows.Forms.dll -luC:\WINDOWS\Microsoft.NET\Framework\v2.0.50727\System.Data.dll -luC:\WINDOWS\Microsoft.NET\Framework\v2.0.50727\System.Drawing.dll -luC:\WINDOWS\Microsoft.NET\Framework\v2.0.50727\System.XML.dll pause.
В этой команде мы заменили параметр CC на CG, так как хотим получить GUI приложение, а не консольное. Кроме того, помимо библиотеки Borland.Delphi.System.dcuil для WinForms приложения нам понадобятся дополнительные библиотеки из самого .NET. Мы указали их с помощью параметра –lu. Искать их и копировать в директорию с программой не надо. Компилятор сам обнаружит их и создаст скомпилированный dcuil из них в директории с программой. Теперь приступим к написанию кода. Так как дизайнер форм мы использовать не можем, то все элементы управления придётся создавать вручную в рантайм. Открывайте pas файл формы в текстовом редакторе и вписывайте в конструктор формы следующий код:
Code: Constructor TWinForm.Create; Var. DockSite: ToolStripContainer; // Область присоединению панелей управления. NewMenuStrip: MenuStrip; // Главное меню. NewToolStrip: ToolStrip; // Панель управления. FileToolStripMenuItem, NewToolStripMenuItem, EditToolStripMenuItem, ViewToolStripMenuItem: ToolStripMenuItem; NewButton: ToolStripButton; Begin. Inherited Create; // // Required for Windows Form Designer support. // InitializeComponent; // // TODO: Add any constructor code after InitializeComponent call. // // DockSite. DockSite := System.Windows.Forms.ToolStripContainer.Create; DockSite.ContentPanel.Size := System.Drawing.Size.Create(292, 224); DockSite.Dock := System.Windows.Forms.DockStyle.Fill; DockSite.Location := System.Drawing.Point.Create(0, 0); DockSite.Name := 'DockSite'; DockSite.Size := System.Drawing.Size.Create(292, 273); DockSite.TabIndex := 0; DockSite.Text := 'DockSite'; DockSite.Parent := Self; DockSite.Visible := True; // NewMenuStrip. NewMenuStrip := System.Windows.Forms.MenuStrip.Create; NewMenuStrip.Name := 'NewMenuStrip'; NewMenuStrip.ClientSize := System.Drawing.Size.Create(292, 24); NewMenuStrip.Location := System.Drawing.Point.Create(0, 0); NewMenuStrip.Text := 'NewMenuStrip'; NewMenuStrip.TabIndex := 0; // NewToolStrip. NewtoolStrip := System.Windows.Forms.ToolStrip.Create; NewToolStrip.Dock := System.Windows.Forms.DockStyle.None; NewtoolStrip.Location := System.Drawing.Point.Create(3, 24); NewtoolStrip.Name := 'NewToolStrip'; NewtoolStrip.Size := System.Drawing.Size.Create(74, 25); NewtoolStrip.TabIndex := 1; // FileToolStripMenuItem. FileToolStripMenuItem := System.Windows.Forms.ToolStripMenuItem.create; FileToolStripMenuItem.Name := 'FileToolStripMenuItem'; FileToolStripMenuItem.Size := System.Drawing.Size.Create(45, 20); FileToolStripMenuItem.Text := '&Файл'; // NewToolStripMenuItem. NewToolStripMenuItem := System.Windows.Forms.ToolStripMenuItem.create; NewToolStripMenuItem.Name := 'NewToolStripMenuItem'; NewToolStripMenuItem.Size := System.Drawing.Size.Create(107, 22); NewToolStripMenuItem.Text := '&Новый'; // Обработчик для команды. Include(NewToolStripMenuItem.Click, NewToolStripMenuItem_Click); // EditToolStripMenuItem. EditToolStripMenuItem := System.Windows.Forms.ToolStripMenuItem.create; EditToolStripMenuItem.Name := 'EditToolStripMenuItem'; EditToolStripMenuItem.Size := System.Drawing.Size.Create(56, 20); EditToolStripMenuItem.Text := '&Правка'; // ViewToolStripMenuItem. ViewToolStripMenuItem := System.Windows.Forms.ToolStripMenuItem.create; ViewToolStripMenuItem.Name := 'ViewToolStripMenuItem'; ViewToolStripMenuItem.Size := System.Drawing.Size.Create(38, 20); ViewToolStripMenuItem.Text := '&Вид'; // NewButton. NewButton := System.Windows.Forms.ToolStripButton.Create; NewButton.Name := 'NewButton'; NewButton.Size := System.Drawing.Size.Create(64, 22); NewButton.Text := 'Кнопа'; NewButton.DisplayStyle := ToolStripItemDisplayStyle.ImageAndText; // Добавление панелей инструментов и элементов меню на область перетаскивания. DockSite.TopToolStripPanel.Controls.Add(NewMenuStrip); DockSite.TopToolStripPanel.Controls.Add(NewToolStrip); NewMenuStrip.Items.Add(FileToolStripMenuItem); NewMenuStrip.Items.Add(EditToolStripMenuItem); NewMenuStrip.Items.Add(ViewToolStripMenuItem); FileToolStripMenuItem.DropDownItems.Add(NewToolStripMenuItem); NewToolStrip.Items.Add(NewButton); // Редактор текста (Editor). Editor := System.Windows.Forms.TextBox.Create; Editor.Name := 'Editor'; Editor.TabIndex := 1; Editor.Location := System.Drawing.Point.Create(0, 0); Editor.Multiline := True; Editor.Dock := System.Windows.Forms.DockStyle.Fill; Editor.Size := System.Drawing.Size.Create(292, 273); Editor.Parent := DockSite.ContentPanel; Editor.Visible := True; // Добавим иконку. NewButton.Image := NewButton.Image.FromFile('new.png'); End;
| Пример приложений на чистом API. |
Code: Program SmallPrg; Uses. Windows, Messages; Const. WinName = 'MainWClass'; Function MainWndProc(Window: HWnd; AMessage, WParam, LParam: Longint): Longint; stdcall; Begin. //подпрограмма обработки сообщений. Case AMessage of. WM_DESTROY: Begin. PostQuitMessage(0); Result := 0; Exit; End; Else. Result := DefWindowProc(Window, AMessage, WParam, LParam); End; End; Function InitApplication: Boolean; Var. Wcx: TWndClass; Begin. //Заполняем структуру TWndClass. // перерисовываем, если размер изменяется. Wcx.style := CS_HREDRAW or CS_VREDRAW; // адрес оконной процедуры. Wcx.lpfnWndProc := @MainWndProc; Wcx.cbClsExtra := 0; Wcx.cbWndExtra := 0; // handle to instance. Wcx.hInstance := hInstance; // загружаем стандандартную иконку. Wcx.hIcon := LoadIcon(0, IDI_APPLICATION); // загружаем стандартный курсор. Wcx.hCursor := LoadCursor(0, IDC_ARROW); // делаем светло-серый фон. Wcx.hbrBackground := COLOR_WINDOW; // пока нет главного меню. Wcx.lpszMenuName := nil; // имя класса окна. Wcx.lpszClassName := PChar(WinName); // Регистрируем наш класс окна. Result := RegisterClass(wcx) <> 0; End; Function InitInstance: HWND; Begin. // Создаем главное окно. Result := CreateWindow( // имя класса окна. PChar(WinName), // заголовок. 'Small program', // стандартный стиль окна. WS_OVERLAPPEDWINDOW, // стандартные горизонтальное, вертикальное положение, ширина и высота. Integer(CW_USEDEFAULT), Integer(CW_USEDEFAULT), Integer(CW_USEDEFAULT), Integer(CW_USEDEFAULT), 0,//нет родительского окна. 0,//нет меню. HInstance, // handle to application instance. Nil); // no window-creation data. End; Var. HwndMain: HWND; AMessage: msg; Begin. If (not InitApplication) then. MessageBox(0, 'Ошибка регистрации окна', nil, mb_Ok). Else. Begin. HwndMain := InitInstance; If (hwndMain = 0) then. MessageBox(0, 'Ошибка создания окна', nil, mb_Ok). Else. Begin. // Показываем окно и посылаем сообщение WM_PAINT оконной процедуре. ShowWindow(hwndMain, CmdShow); UpdateWindow(hwndMain); While (GetMessage(AMessage, 0, 0, 0)) do. Begin. TranslateMessage(AMessage); DispatchMessage(AMessage); End; End; End; End.
| Обновление вычисляемых полей |
Обновление вычисляемых полей
Автор: OAmiry (Borland).
Разместите строчку типа нижеприведенной в конце кода обработчика события OnCalcFields:
Code: {предположим, что вы используете DBGrid1}. If DBGrid1.Showing then. DBGrid1.Invalidate ;
| Обновление картинки в ячейке |
Автор: SottNick.
| Обновление файла после перезагрузки системы |
Code: { **** UBPFD *********** by kladovka.net.ru **** >> Обновление файла после перезагрузки системы. Данная процедура настраивает систему для обновления файлов после перезагрузки. TargetFileName - имя файла, содержимое которого при перезагрузке будет. Заменено на содержимое файла, имя которого укзаывается в параметре SourceFileName. Если первый аргумент процедуры представляет собой пустую строку, при. Перезагрузке файл SourceFileName будет удалён. Зависимости: Windows. Автор: Dimka Maslov, mainbox@endimus.ru, ICQ:148442121, Санкт-Петербург. Copyright: Dimka Maslov. Дата: 18 ноября 2002 г. ********************************************** } Procedure BootReplaceFile(TargetFileName, SourceFileName: string). Var. WinInitName: string; P: PChar; Procedure InternalGetShortPathName(var S: string); Begin. UniqueString(S); GetShortPathName(PChar(S), PChar(S), Length(S)); SetLength(S, StrLen(@S[1])); CharToOEM(PChar(S), PChar(S)); End; Begin. If Win32Platform = VER_PLATFORM_WIN32_NT then begin. If TargetFileName <> '' Then P:=PChar(TargetFileName). Else P:=nil; MoveFileEx(PChar(SourceFileName), P, MOVEFILE_DELAY_UNTIL_REBOOT or MOVEFILE_REPLACE_EXISTING); End else begin. SetLength(WinInitName, MAX_PATH); GetWindowsDirectory(@WinInitName[1], MAX_PATH); SetLength(WinInitName, StrLen(@WinInitName[1])); WinInitName:=IncludeTrailingBackslash(WinInitName)+'WININIT.INI'; If TargetFileName = '' Then TargetFileName:='NUL' Else InternalGetShortPathName(TargetFileName); InternalGetShortPathName(SourceFileName); WritePrivateProfileString('Rename', PChar(TargetFileName), PChar(SourceFileName), PChar(WinInit)); End; End;
Немного относительно методов упаковки данных.
| Немного относительно методов упаковки данных |
Running - Это самый простой из методов упаковки информации . Предположите что Вы имеете строку текста, и в конце строки стоит 40 пробелов. Налицо явная избыточность имеющейся информации. Проблема сжатия этой строки решается очень просто - эти 40 пробелов ( 40 байт ) сжимаются в 3 байта с помощью упаковки их по методу повторяющихся символов (running). Первый байт, стоящий вместо 40 пробелов в сжатой строке, фактически будет явлться пробелом ( последовательность была из пробелов ) . Второй байт - специальный байт "флажка" который указывает что мы должны развернуть предыдущий в строке байт в последовательность при восстановлении строки . Третий байт - байт счета ( в нашем случае это будет 40 ). Как Вы сами можете видеть, достаточно чтобы любой раз, когда мы имеем последовательность из более 3-х одинаковых символов, заменять их выше описанной последовательностью , чтобы на выходе получить блок информации меньший по размеру, но допускающий восстановление информации в исходном виде. Оставляя все сказанное выше истинным , добавлю лишь то, что в данном методе основной проблемой является выбор того самого байта "флажка", так как в реальных блоках информации как правило используются все 256 вариантов байта и нет возможности иметь 257 вариант - "флажок". На первый взгляд эта проблема кажется неразрешимой , но к ней есть ключик , который Вы найдете прочитав о кодировании с помощью алгоритма Хаффмана ( Huffman ). LZW - История этого алгоритма начинается с опубликования в мае 1977 г. Дж. Зивом ( J. Ziv ) и А. Лемпелем ( A. Lempel ) статьи в журнале "Информационные теории " под названием " IEEE Trans ". В последствии этот алгоритм был доработан Терри А. Велчем ( Terry A. Welch ) и в окончательном варианте отражен в статье " IEEE Compute " в июне 1984 . В этой статье описывались подробности алгоритма и некоторые общие проблемы с которыми можно столкнуться при его реализации. Позже этот алгоритм получил название - LZW (Lempel - Ziv - Welch) . Алгоритм LZW представляет собой алгоритм кодирования последовательностей неодинаковых символов. Возьмем для примера строку " Объект TSortedCollection порожден от TCollection.". Анализируя эту строку мы можем видеть, что слово "Collection" повторяется дважды. В этом слове 10 символов - 80 бит. И если мы сможем заменить это слово в выходном файле, во втором его включении, на ссылку на первое включение, то получим сжатие информации. Если рассматривать входной блок информации размером не более 64К и ограничится длинной кодируемой строки в 256 символов, то учитывая байт "флаг" получим, что строка из 80 бит заменяется 8+16+8 = 32 бита. Алгоритм LZW как-бы "обучается" в процессе сжатия файла. Если существуют повторяющиеся строки в файле , то они будут закодированны в таблицу. Очевидным преимуществом алгоритма является то, что нет необходимости включать таблицу кодировки в сжатый файл. Другой важной особенностью является то, что сжатие по алгоритму LZW является однопроходной операцией в противоположность алгоритму Хаффмана ( Huffman ) , которому требуется два прохода. Huffman - Сначала кажется что создание файла меньших размеров из исходного без кодировки последовательностей или исключения повтора байтов будет невозможной задачей. Но давайте мы заставим себя сделать несколько умственных усилий и понять алгоритм Хаффмана ( Huffman ). Потеряв не так много времени мы приобретем знания и дополнительное место на дисках. Сжимая файл по алгоритму Хаффмана первое что мы должны сделать - это необходимо прочитать файл полностью и подсчитать сколько раз встречается каждый символ из расширенного набора ASCII. Если мы будем учитывать все 256 символов, то для нас не будет разницы в сжатии текстового и EXE файла. После подсчета частоты вхождения каждого символа, необходимо просмотреть таблицу кодов ASCII и сформировать мнимую компоновку между кодами по убыванию. То есть не меняя местонахождение каждого символа из таблицы в памяти отсортировать таблицу ссылок на них по убыванию. Каждую ссылку из последней таблицы назовем "узлом". В дальнейшем ( в дереве ) мы будем позже размещать указатели которые будут указывает на этот "узел". Для ясности давайте рассмотрим пример: Мы имеем файл длинной в 100 байт и имеющий 6 различных символов в себе . Мы подсчитали вхождение каждого из символов в файл и получили следующее : +-----------------+-----+-----+-----+-----+-----+-----+ | cимвол | A | B | C | D | E | F | +-----------------+-----+-----+-----+-----+-----+-----| | число вхождений | 10 | 20 | 30 | 5 | 25 | 10 | +-----------------+-----+-----+-----+-----+-----+-----+ Теперь мы берем эти числа и будем называть их частотой вхождения для каждого символа. Разместим таблицу как ниже. +-----------------+-----+-----+-----+-----+-----+-----+ | cимвол | C | E | B | F | A | D | +-----------------+-----+-----+-----+-----+-----+-----| | число вхождений | 30 | 25 | 20 | 10 | 10 | 5 | +-----------------+-----+-----+-----+-----+-----+-----+ Мы возьмем из последней таблицы символы с наименьшей частотой. В нашем случае это D (5) и какой либо символ из F или A (10), можно взять любой из них например A. Сформируем из "узлов" D и A новый "узел", частота вхождения для которого будет равна сумме частот D и A : Частота 30 10 5 10 20 25 Символа C A D F B E | | +--+--+ ++-+ |15| = 5 + 10 +--+ Номер в рамке - сумма частот символов D и A. Теперь мы снова ищем два символа с самыми низкими частотами вхождения. Исключая из просмотра D и A и рассматривая вместо них новый "узел" с суммарной частотой вхождения. Самая низкая частота теперь у F и нового "узла". Снова сделаем операцию слияния узлов : Частота 30 10 5 10 20 25 Символа C A D F B E | | | | | | | +--+| | +-|15++ | ++-+ | | | | +--+ | +----|25+-+ = 10 + 15 +--+ Рассматриваем таблицу снова для следующих двух символов ( B и E ). Мы продолжаем в этот режим пока все "дерево" не сформировано, т.е. пока все не сведется к одному узлу. Частота 30 10 5 10 20 25 Символа C A D F B E | | | | | | | | | | | | | | +--+| | | | | +-|15++ | | | | ++-+ | | | | | | | | | | +--+ | | +--+ | | +----|25+-+ +-|45+-+ | ++-+ ++-+ | +--+ | | +----|55+------+ | +-++ | | +------------+ | +---| Root (100) +----+ +------------+ Теперь когда наше дерево создано, мы можем кодировать файл . Мы должны всегда начинать из корня ( Root ) . Кодируя первый символ (лист дерева С) Мы прослеживаем вверх по дереву все повороты ветвей и если мы делаем левый поворот, то запоминаем 0-й бит, и аналогично 1-й бит для правого поворота. Так для C, мы будем идти влево к 55 ( и запомним 0 ), затем снова влево (0) к самому символу . Код Хаффмана для нашего символа C - 00. Для следующего символа ( А ) у нас получается - лево,право,лево,лево , что выливается в последовательность 0100. Выполнив выше сказанное для всех символов получим C = 00 ( 2 бита ) A = 0100 ( 4 бита ) D = 0101 ( 4 бита ) F = 011 ( 3 бита ) B = 10 ( 2 бита ) E = 11 ( 2 бита ) Каждый символ изначально представлялся 8-ю битами ( один байт ), и так как мы уменьшили число битов необходимых для представления каждого символа, мы следовательно уменьшили размер выходного файла . Сжатие складывется следующим образом : +----------+----------------+-------------------+--------------+ | Частота | первоначально | уплотненные биты | уменьшено на | +----------+----------------+-------------------+--------------| | C 30 | 30 x 8 = 240 | 30 x 2 = 60 | 180 | | A 10 | 10 x 8 = 80 | 10 x 3 = 30 | 50 | | D 5 | 5 x 8 = 40 | 5 x 4 = 20 | 20 | | F 10 | 10 x 8 = 80 | 10 x 4 = 40 | 40 | | B 20 | 20 x 8 = 160 | 20 x 2 = 40 | 120 | | E 25 | 25 x 8 = 200 | 25 x 2 = 50 | 150 | +----------+----------------+-------------------+--------------+ Первоначальный размер файла : 100 байт - 800 бит; Размер сжатого файла : 30 байт - 240 бит; 240 - 30% из 800 , так что мы сжали этот файл на 70%. Все это довольно хорошо, но неприятность находится в том факте, что для восстановления первоначального файла, мы должны иметь декодирующее дерево, так как деревья будут различны для разных файлов . Следовательно мы должны сохранять дерево вместе с файлом . Это превращается в итоге в увеличение размеров выходного файла . В нашей методике сжатия и каждом узле находятся 4 байта указателя, по этому, полная таблица для 256 байт будет приблизительно 1 Кбайт длинной. Таблица в нашем примере имеет 5 узлов плюс 6 вершин ( где и находятся наши символы ) , всего 11 . 4 байта 11 раз - 44 . Если мы добавим после небольшое количество байтов для сохранения места узла и некоторую другую статистику - наша таблица будет приблизительно 50 байтов длинны. Добавив к 30 байтам сжатой информации, 50 байтов таблицы получаем, что общая длинна архивного файла вырастет до 80 байт . Учитывая , что первоначальная длинна файла в рассматриваемом примере была 100 байт - мы получили 20% сжатие информации. Не плохо . То что мы действительно выполнили - трансляция символьного ASCII набора в наш новый набор требующий меньшее количество знаков по сравнению с стандартным. Что мы можем получить на этом пути ? Рассмотрим максимум которй мы можем получить для различных разрядных комбинацй в оптимальном дереве, которое является несимметричным. Мы получим что можно иметь только : 4 - 2 разрядных кода; 8 - 3 разрядных кодов; 16 - 4 разрядных кодов; 32 - 5 разрядных кодов; 64 - 6 разрядных кодов; 128 - 7 разрядных кодов; Необходимо еще два 8 разрядных кода. 4 - 2 разрядных кода; 8 - 3 разрядных кодов; 16 - 4 разрядных кодов; 32 - 5 разрядных кодов; 64 - 6 разрядных кодов; 128 - 7 разрядных кодов; -------- 254 Итак мы имеем итог из 256 различных комбинаций которыми можно кодировать байт. Из этих комбинаций лишь 2 по длинне равны 8 битам. Если мы сложим число битов которые это представляет, то в итоге получим 1554 бит или 195 байтов. Так в максимуме , мы сжали 256 байт к 195 или 33%, таким образом максимально идеализированный Huffman может достигать сжатия в 33% когда используется на уровне байта Все эти подсчеты производились для не префиксных кодов Хаффмана т.е. кодов, которые нельзя идентифицировать однозначно. Например код A - 01011 и код B - 0101 . Если мы будем получать эти коды побитно, то получив биты 0101 мы не сможем сказать какой код мы получили A или B , так как следующий бит может быть как началом следующего кода, так и продолжением предыдущего. Необходимо добавить, что ключем к построению префиксных кодов служит обычное бинарное дерево и если внимательно рассмотреть предыдущий пример с построением дерева , можно убедится , что все получаемые коды там префиксные. Одно последнее примечание - алгоритм Хаффмана требует читать входной файл дважды, один раз считая частоты вхождения символов , другой разпроизводя непосредственно кодирование. P.S. О "ключике" дающем дорогу алгоритму Running. ---- Прочитав обзорную информацию о Huffman кодировании подумайтенад тем, что на нашем бинарном дереве может быть и 257 листиков. Литература : ------------ 1) Описание архиватора Narc фирмы Infinity Design Concepts, Inc.; 2) Чарльз Сейтер, 'Сжатие данных', "Мир ПК", N2 1991;
Code: {$A+,B-,D+,E+,F-,G-,I-,L+,N-,O-,R+,S+,V+,X-}. {$M 16384,0,655360}. {******************************************************} {* Алгоритм уплотнения данных по методу *}. {* Хафмана. *}. {******************************************************} Program Hafman; Uses Crt,Dos,Printer; Type PCodElement = ^CodElement; CodElement = record. NewLeft,NewRight, P0, P1 : PCodElement; {элемент входящий одновременно}. LengthBiteChain : byte; { в массив , очередь и дерево }. BiteChain : word; CounterEnter : word; Key : boolean; Index : byte; End; TCodeTable = array [0..255] of PCodElement; Var CurPoint,HelpPoint, LeftRange,RightRange : PCodElement; CodeTable : TCodeTable; Root : PCodElement; InputF, OutputF, InterF : file; TimeUnPakFile : longint; AttrUnPakFile : word; NumRead, NumWritten: Word; InBuf : array[0..10239] of byte; OutBuf : array[0..10239] of byte; BiteChain : word; CRC, CounterBite : byte; OutCounter : word; InCounter : word; OutWord : word; St : string; LengthOutFile, LengthArcFile : longint; Create : boolean; NormalWork : boolean; ErrorByte : byte; DeleteFile : boolean; {-------------------------------------------------} Procedure ErrorMessage; { --- вывод сообщения об ошибке --- }. Begin. If ErrorByte <> 0 then. Begin. Case ErrorByte of. 2 : Writeln('File not found ...'); 3 : Writeln('Path not found ...'); 5 : Writeln('Access denied ...'); 6 : Writeln('Invalid handle ...'); 8 : Writeln('Not enough memory ...'); 10 : Writeln('Invalid environment ...'); 11 : Writeln('Invalid format ...'); 18 : Writeln('No more files ...'); Else Writeln('Error #',ErrorByte,' ...'); End; NormalWork:=False; ErrorByte:=0; End; End; Procedure ResetFile; { --- открытие файла для архивации --- }. Var St : string; Begin. Assign(InputF, ParamStr(3)); Reset(InputF, 1); ErrorByte:=IOResult; ErrorMessage; If NormalWork then Writeln('Pak file : ',ParamStr(3),'...'); End; Procedure ResetArchiv; { --- открытие файла архива, или его создание --- }. Begin. St:=ParamStr(2); If Pos('.',St)<>0 then Delete(St,Pos('.',St),4); St:=St+'.vsg'; Assign(OutputF, St); Reset(OutPutF,1); Create:=False; If IOResult=2 then. Begin. Rewrite(OutputF, 1); Create:=True; End; If NormalWork then. If Create then Writeln('Create archiv : ',St,'...'). Else Writeln('Open archiv : ',St,'...'). End; Procedure SearchNameInArchiv; { --- в дальнейшем - поиск имени файла в архиве --- }. Begin. Seek(OutputF,FileSize(OutputF)); ErrorByte:=IOResult; ErrorMessage; End; Procedure DisposeCodeTable; { --- уничтожение кодовой таблицы и очереди --- }. Var I : byte; Begin. For I:=0 to 255 do Dispose(CodeTable[I]); End; Procedure ClosePakFile; { --- закрытие архивируемого файла --- }. Var I : byte; Begin. If DeleteFile then Erase(InputF); Close(InputF); End; Procedure CloseArchiv; { --- закрытие архивного файла --- }. Begin. If FileSize(OutputF)=0 then Erase(OutputF); Close(OutputF); End; Procedure InitCodeTable; { --- инициализация таблицы кодировки --- }. Var I : byte; Begin. For I:=0 to 255 do. Begin. New(CurPoint); CodeTable[I]:=CurPoint; With CodeTable[I]^ do. Begin. P0:=Nil; P1:=Nil; LengthBiteChain:=0; BiteChain:=0; CounterEnter:=1; Key:=True; Index:=I; End; End; For I:=0 to 255 do. Begin. If I>0 then CodeTable[I-1]^.NewRight:=CodeTable[I]; If I<255 then CodeTable[I+1]^.NewLeft:=CodeTable[I]; End; LeftRange:=CodeTable[0]; RightRange:=CodeTable[255]; CodeTable[0]^.NewLeft:=Nil; CodeTable[255]^.NewRight:=Nil; End; Procedure SortQueueByte; { --- пузырьковая сортировка по возрастанию --- }. Var Pr1,Pr2 : PCodElement; Begin. CurPoint:=LeftRange; While CurPoint <> RightRange do. Begin. If CurPoint^.CounterEnter > CurPoint^.NewRight^.CounterEnter then. Begin. HelpPoint:=CurPoint^.NewRight; HelpPoint^.NewLeft:=CurPoint^.NewLeft; CurPoint^.NewLeft:=HelpPoint; If HelpPoint^.NewRight<>Nil then HelpPoint^.NewRight^.NewLeft:=CurPoint; CurPoint^.NewRight:=HelpPoint^.NewRight; HelpPoint^.NewRight:=CurPoint; If HelpPoint^.NewLeft<>Nil then HelpPoint^.NewLeft^.NewRight:=HelpPoint; If CurPoint=LeftRange then LeftRange:=HelpPoint; If HelpPoint=RightRange then RightRange:=CurPoint; CurPoint:=CurPoint^.NewLeft; If CurPoint = LeftRange then CurPoint:=CurPoint^.NewRight. Else CurPoint:=CurPoint^.NewLeft; End. Else CurPoint:=CurPoint^.NewRight; End; End; Procedure CounterNumberEnter; { --- подсчет частот вхождений байтов в блоке --- }. Var C : word; Begin. For C:=0 to NumRead-1 do. Inc(CodeTable[(InBuf[C])]^.CounterEnter); End; Function SearchOpenCode : boolean; { --- поиск в очереди пары открытых по Key минимальных значений --- }. Begin. CurPoint:=LeftRange; HelpPoint:=LeftRange; HelpPoint:=HelpPoint^.NewRight; While not CurPoint^.Key do. CurPoint:=CurPoint^.NewRight; While (not (HelpPoint=RightRange)) and (not HelpPoint^.Key) do. Begin. HelpPoint:=HelpPoint^.NewRight; If (HelpPoint=CurPoint) and (HelpPoint<>RightRange) then. HelpPoint:=HelpPoint^.NewRight; End; If HelpPoint=CurPoint then SearchOpenCode:=False else SearchOpenCode:=True; End; Procedure CreateTree; { --- создание дерева частот вхождения --- }. Begin. While SearchOpenCode do. Begin. New(Root); With Root^ do. Begin. P0:=CurPoint; P1:=HelpPoint; LengthBiteChain:=0; BiteChain:=0; CounterEnter:=P0^.CounterEnter + P1^.CounterEnter; Key:=True; P0^.Key:=False; P1^.Key:=False; End; HelpPoint:=LeftRange; While (HelpPoint^.CounterEnter < Root^.CounterEnter) and. (HelpPoint<>Nil) do HelpPoint:=HelpPoint^.NewRight; If HelpPoint=Nil then { добавление в конец }. Begin. Root^.NewLeft:=RightRange; RightRange^.NewRight:=Root; Root^.NewRight:=Nil; RightRange:=Root; End. Else. Begin { вставка перед HelpPoint }. Root^.NewLeft:=HelpPoint^.NewLeft; HelpPoint^.NewLeft:=Root; Root^.NewRight:=HelpPoint; If Root^.NewLeft<>Nil then Root^.NewLeft^.NewRight:=Root; End; End; End; Procedure ViewTree( P : PCodElement ); { --- просмотр дерева частот и присваивание кодировочных цепей листьям --- }. Var Mask,I : word; Begin. Inc(CounterBite); If P^.P0<>Nil then ViewTree( P^.P0 ); If P^.P1<>Nil then. Begin. Mask:=(1 SHL (16-CounterBite)); BiteChain:=BiteChain OR Mask; ViewTree( P^.P1 ); Mask:=(1 SHL (16-CounterBite)); BiteChain:=BiteChain XOR Mask; End; If (P^.P0=Nil) and (P^.P1=Nil) then. Begin. P^.BiteChain:=BiteChain; P^.LengthBiteChain:=CounterBite-1; End; Dec(CounterBite); End; Procedure CreateCompressCode; { --- обнуление переменных и запуск просмотра дерева с вершины --- }. Begin. BiteChain:=0; CounterBite:=0; Root^.Key:=False; ViewTree(Root); End; Procedure DeleteTree; { --- удаление дерева --- }. Var P : PCodElement; Begin. CurPoint:=LeftRange; While CurPoint<>Nil do. Begin. If (CurPoint^.P0<>Nil) and (CurPoint^.P1<>Nil) then. Begin. If CurPoint^.NewLeft <> Nil then. CurPoint^.NewLeft^.NewRight:=CurPoint^.NewRight; If CurPoint^.NewRight <> Nil then. CurPoint^.NewRight^.NewLeft:=CurPoint^.NewLeft; If CurPoint=LeftRange then LeftRange:=CurPoint^.NewRight; If CurPoint=RightRange then RightRange:=CurPoint^.NewLeft; P:=CurPoint; CurPoint:=P^.NewRight; Dispose(P); End. Else CurPoint:=CurPoint^.NewRight; End; End; Procedure SaveBufHeader; { --- запись в буфер заголовка архива --- }. Type. ByteField = array[0..6] of byte; Const. Header : ByteField = ( $56, $53, $31, $00, $00, $00, $00 ); Begin. If Create then. Begin. Move(Header,OutBuf[0],7); OutCounter:=7; End. Else. Begin. Move(Header[3],OutBuf[0],4); OutCounter:=4; End; End; Procedure SaveBufFATInfo; { --- запись в буфер всей информации по файлу --- }. Var I : byte; St : PathStr; R : SearchRec; Begin. St:=ParamStr(3); For I:=0 to Length(St)+1 do. Begin. OutBuf[OutCounter]:=byte(Ord(St[I])); Inc(OutCounter); End; FindFirst(St,$00,R); Dec(OutCounter); Move(R.Time,OutBuf[OutCounter],4); OutCounter:=OutCounter+4; OutBuf[OutCounter]:=R.Attr; Move(R.Size,OutBuf[OutCounter+1],4); OutCounter:=OutCounter+5; End; Procedure SaveBufCodeArray; { --- сохранить массив частот вхождений в архивном файле --- }. Var I : byte; Begin. For I:=0 to 255 do. Begin. OutBuf[OutCounter]:=Hi(CodeTable[I]^.CounterEnter); Inc(OutCounter); OutBuf[OutCounter]:=Lo(CodeTable[I]^.CounterEnter); Inc(OutCounter); End; End; Procedure CreateCodeArchiv; { --- создание кода сжатия --- }. Begin. InitCodeTable; { инициализация кодовой таблицы }. CounterNumberEnter; { подсчет числа вхождений байт в блок }. SortQueueByte; { сортировка по возрастанию числа вхождений }. SaveBufHeader; { сохранить заголовок архива в буфере }. SaveBufFATInfo; { сохраняется FAT информация по файлу }. SaveBufCodeArray; { сохранить массив частот вхождений в архивном файле }. CreateTree; { создание дерева частот }. CreateCompressCode; { создание кода сжатия }. DeleteTree; { удаление дерева частот }. End; Procedure PakOneByte; { --- сжатие и пересылка в выходной буфер одного байта --- }. Var Mask : word; Tail : boolean; Begin. CRC:=CRC XOR InBuf[InCounter]; Mask:=CodeTable[InBuf[InCounter]]^.BiteChain SHR CounterBite; OutWord:=OutWord OR Mask; CounterBite:=CounterBite+CodeTable[InBuf[InCounter]]^.LengthBiteChain; If CounterBite>15 then Tail:=True else Tail:=False; While CounterBite>7 do. Begin. OutBuf[OutCounter]:=Hi(OutWord); Inc(OutCounter); If OutCounter=(SizeOf(OutBuf)-4) then. Begin. BlockWrite(OutputF,OutBuf,OutCounter,NumWritten); OutCounter:=0; End; CounterBite:=CounterBite-8; If CounterBite<>0 then OutWord:=OutWord SHL 8 else OutWord:=0; End; If Tail then. Begin. Mask:=CodeTable[InBuf[InCounter]]^.BiteChain SHL. (CodeTable[InBuf[InCounter]]^.LengthBiteChain-CounterBite); OutWord:=OutWord OR Mask; End; Inc(InCounter); If (InCounter=(SizeOf(InBuf))) or (InCounter=NumRead) then. Begin. InCounter:=0; BlockRead(InputF,InBuf,SizeOf(InBuf),NumRead); End; End; Procedure PakFile; { --- процедура непосредственного сжатия файла --- }. Begin. ResetFile; SearchNameInArchiv; If NormalWork then. Begin. BlockRead(InputF,InBuf,SizeOf(InBuf),NumRead); OutWord:=0; CounterBite:=0; OutCounter:=0; InCounter:=0; CRC:=0; CreateCodeArchiv; While (NumRead<>0) do PakOneByte; OutBuf[OutCounter]:=Hi(OutWord); Inc(OutCounter); OutBuf[OutCounter]:=CRC; Inc(OutCounter); BlockWrite(OutputF,OutBuf,OutCounter,NumWritten); DisposeCodeTable; ClosePakFile; End; End; Procedure ResetUnPakFiles; { --- открытие файла для распаковки --- }. Begin. InCounter:=7; St:=''; Repeat. St[InCounter-7]:=Chr(InBuf[InCounter]); Inc(InCounter); Until InCounter=InBuf[7]+8; Assign(InterF,St); Rewrite(InterF,1); ErrorByte:=IOResult; ErrorMessage; If NormalWork then. Begin. WriteLn('UnPak file : ',St,'...'); Move(InBuf[InCounter],TimeUnPakFile,4); InCounter:=InCounter+4; AttrUnPakFile:=InBuf[InCounter]; Inc(InCounter); Move(InBuf[InCounter],LengthArcFile,4); InCounter:=InCounter+4; End; End; Procedure CloseUnPakFile; { --- закрытие файла для распаковки --- }. Begin. If not NormalWork then Erase(InterF). Else. Begin. SetFAttr(InterF,AttrUnPakFile); SetFTime(InterF,TimeUnPakFile); End; Close(InterF); End; Procedure RestoryCodeTable; { --- воссоздание кодовой таблицы по архивному файлу --- }. Var I : byte; Begin. InitCodeTable; For I:=0 to 255 do. Begin. CodeTable[I]^.CounterEnter:=InBuf[InCounter]; CodeTable[I]^.CounterEnter:=CodeTable[I]^.CounterEnter SHL 8; Inc(InCounter); CodeTable[I]^.CounterEnter:=CodeTable[I]^.CounterEnter+InBuf[InCounter]; Inc(InCounter); End; End; Procedure UnPakByte( P : PCodElement ); { --- распаковка одного байта --- }. Var Mask : word; Begin. If (P^.P0=Nil) and (P^.P1=Nil) then. Begin. OutBuf[OutCounter]:=P^.Index; Inc(OutCounter); Inc(LengthOutFile); If OutCounter = (SizeOf(OutBuf)-1) then. Begin. BlockWrite(InterF,OutBuf,OutCounter,NumWritten); OutCounter:=0; End; End. Else. Begin. Inc(CounterBite); If CounterBite=9 then. Begin. Inc(InCounter); If InCounter = (SizeOf(InBuf)) then. Begin. InCounter:=0; BlockRead(OutputF,InBuf,SizeOf(InBuf),NumRead); End; CounterBite:=1; End; Mask:=InBuf[InCounter]; Mask:=Mask SHL (CounterBite-1); Mask:=Mask OR $FF7F; { установка всех битов кроме старшего }. If Mask=$FFFF then UnPakByte(P^.P1). Else UnPakByte(P^.P0); End; End; Procedure UnPakFile; { --- распаковка одного файла --- }. Begin. BlockRead(OutputF,InBuf,SizeOf(InBuf),NumRead); ErrorByte:=IOResult; ErrorMessage; If NormalWork then ResetUnPakFiles; If NormalWork then. Begin. RestoryCodeTable; SortQueueByte; CreateTree; { создание дерева частот }. CreateCompressCode; CounterBite:=0; OutCounter:=0; LengthOutFile:=0; While LengthOutFile LengthArcFile do. UnPakByte(Root); BlockWrite(InterF,OutBuf,OutCounter,NumWritten); DeleteTree; DisposeCodeTable; End; CloseUnPakFile; End; { ------------------------- main text ------------------------- }. Begin. DeleteFile:=False; NormalWork:=True; ErrorByte:=0; WriteLn; WriteLn('ArcHaf version 1.0 (c) Copyright VVS Soft Group, 1992.'); ResetArchiv; If NormalWork then. Begin. St:=ParamStr(1); Case St[1] of. 'a','A' : PakFile; 'm','M' : begin. DeleteFile:=True; PakFile; End; 'e','E' : UnPakFile; Else ; End; End; CloseArchiv; End.
Источник: http://delphiclub.ru.
©Drkb::04178.
Немного о джойстиках.
| Немного о джойстиках |
Немного о джойстиках
Наталия Елманова Компьютер Пресс - CD, 1999, N 7 © Copyright N.Elmanova & ComputerPress Magazine.
Посвящается всем любителям компьютерных игр…
В предыдущей статье данного цикла ("Компьютер Пресс", 1999, N 3) были рассмотрены некоторые из вопросов, связанных с использованием внешних устройств. Данная статья продолжает начатую тему. Так как данный номер посвящен приложениям multimedia, а примеры использования компонента TMediaPlayer и создания проигрывателя звуковых компакт-дисков доступны российским читателям в нескольких различных модификациях (см., например, недавно вышедшую книгу С.Тейксейра и К.Пачеко "Borland Delphi 4: руководство разработчика"; подобные примеры есть и в других источниках), данная статья посвящена теме довольно экзотической - использованию джойстика. Некоторые (но далеко не все) идеи, послужившие основой для рассмотренного ниже примера, заимствованы из малодоступного российскому читателю источника "C++Builder - how-to" (J.Miano, T.Cabanski, H.Howe. - Waite Group Press, 1997).
Использование джойстика базируется на использовании нескольких функций Windows API и структур Windows, описанных в файле mmsystem.h.
Сервисы, обслуживающие джойстики, загружаются при загрузке операционной системы. В 32-разрядных версиях Windows джойстиков может быть два, и каждый может иметь от одной до четырех кнопок. Каков именно ваш джойстик и каковы характеристики его драйвера, можно определить с помощью соответствующих функций Windows API. Помимо этого, с помощью других функций можно определить, какие из кнопок нажаты в данный момент, и каковы текущие координаты, связанные с наклоном его ручки (joystick's positional information). Это можно сделать, либо опрашивая джойстик периодически, либо обрабатывая полученные от него события.
Создадим простейшее приложение для тестирования джойстика. С этой целью создадим форму, на которую поместим компонент TImage с изображением джойстика, и четыре компонента TShape (в данном случае это красные эллипсы) для изображения нажатых кнопок. Сделаем компоненты TShape невидимыми. Кроме того, поместим на форму компоненты TMemo и TPaintBox. И, наконец, поместим на форму компонент TImageList, в который поместим одно-единственное изображение, более или менее похожее на прицел джойстика (рис.1):
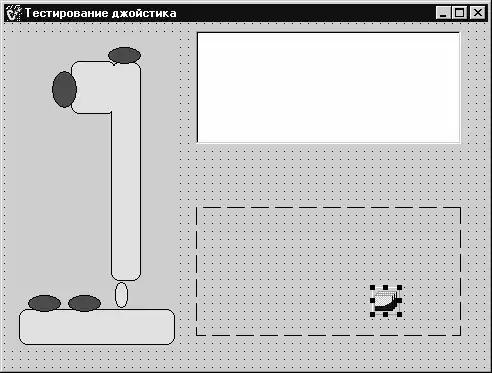
Рис.1. Главная форма приложения для тестирования джойстика
Интерфейс приложения готов. Теперь можно приступить к созданию кода.
Для начала следует не забыть сослаться в приложении сослаться на файл mmsystem.h (в нем описаны необходимые структуры и функции для управления джойстиком и получения информации от него).
Первое, что нужно сделать - это узнать, установлен ли вообще драйвер джойстика, и если да, подключен ли джойстик. Для этой цели используется функция joyGetNumDevs(). Если она возвращает значение, отличное от нуля, это означает, что драйвер джойстика установлен. Однако это еще не означает, что сам джойстик подключен:
Code: Int joycount=joyGetNumDevs(); If (joycount=0) Memo1->Lines->Add("Драйверы джойстика не установлены");
Чтобы узнать, подключен ли джойстик, следует обратиться к функции joyGetPosEx и убедиться, что она не возвращает кода ошибки.
Code: Jr=joyGetPosEx(JOYSTICKID1,&JoyInfo); If (jr ==JOYERR_NOERROR). { Connect=true; Jnum= JOYSTICKID1; } Else if (jr == MMSYSERR_INVALPARAM). ShowMessage("Ошибка определения наличия джойстика"); Else if((jr=joyGetPosEx(JOYSTICKID2,&JoyInfo)) == JOYERR_NOERROR). { Connect = true; Jnum= JOYSTICKID2; }
Если джойстик подключен, можно узнать о его характеристиках с помощью структуры JOYCAPS. Список доступных характеристик весьма обширен, и мы выведем в компонент TMemo информацию о некоторые из них. Сведения об остальных можно получить аналогичным способом.
Code: Memo1->Lines->Add("Номер устройства - "+ IntToStr(jnum)); Memo1->Lines->Add("Наименование - " + AnsiString(JoyCaps.szPname)); Memo1->Lines->Add("Число кнопок - " + IntToStr(JoyCaps.wNumButtons));
Если джойстик подключен, можно обрабатывать его события. Функция joySetCapture предназначена для перенаправления сообщений джойстика данному окну (в нашем случае - главному окну нашего приложения). Параметры этой функции содержат дескриптор окна, указатель на то, первый или второй джойстик должен посылать сообщения, частоту отправки этих сообщений (в данном случае используется минимально возможный период, определяемый с помощью все той же структуры JOYCAPS), а также параметр, указывающий на то, нужно ли посылать сообщения, если в состоянии джойстика ничего не изменилось.
If (connect) joySetCapture(Handle,jnum,2*JoyCaps.wPeriodMin,FALSE);
Соответственно для того, чтобы остановить поток этих сообщений, перед закрытием формы следует вызвать функцию joyReleaseCapture.
Code: If (connect) joyReleaseCapture(jnum);
Теперь можно создать функции, реагирующие на события джойстика. Одна из них должна делать видимыми те из объектов TShape, которые соответствуют нажатым кнопкам. Вторая должна отображать "прицел", перемещая его внутри компонента TPaintBox. Помимо этого, следует сослаться на эти функции в h-файле, указав, что они являются реакцией на соответствующие сообщения Windows. Текст h-файла, таким образом, имеет вид:
Code: #ifndef joy1H. #define joy1H. //--------------------------------------------------------------------------- #include <Classes.hpp> #include <Controls.hpp> #include <StdCtrls.hpp> #include <Forms.hpp> #include <ExtCtrls.hpp> #include <Graphics.hpp> #include <ImgList.hpp> #include <Buttons.hpp> //--------------------------------------------------------------------------- Class TForm1 : public TForm. { __published: // IDE-managed Components. TImage *Image1; TShape *Shape2; TShape *Shape1; TShape *Shape3; TShape *Shape4; TMemo *Memo1; TImageList *ImageList1; TPaintBox *PaintBox1; Void __fastcall FormCreate(TObject *Sender); Void __fastcall UpdButton(TMessage &msg); Void __fastcall UpdCoord(TMessage &msg); Void __fastcall FormDestroy(TObject *Sender); Private: Int jnum; JOYCAPS JoyCaps; Bool connect; Int stepX,stepY; TPoint Pos; // User declarations. Public: // User declarations. __fastcall TForm1(TComponent* Owner); BEGIN_MESSAGE_MAP. MESSAGE_HANDLER(MM_JOY1BUTTONDOWN,TMessage,UpdButton). MESSAGE_HANDLER(MM_JOY1BUTTONUP,TMessage,UpdButton). MESSAGE_HANDLER(MM_JOY1MOVE,TMessage,UpdCoord). MESSAGE_HANDLER(MM_JOY2BUTTONDOWN,TMessage,UpdButton). MESSAGE_HANDLER(MM_JOY2BUTTONUP,TMessage,UpdButton). MESSAGE_HANDLER(MM_JOY2MOVE,TMessage,UpdCoord). END_MESSAGE_MAP(TForm). }; //--------------------------------------------------------------------------- Extern PACKAGE TForm1 *Form1; //--------------------------------------------------------------------------- #endif. Сам исходный текст модуля, связанного с главной формой приложения, имеет вид: //--------------------------------------------------------------------------- #include <vcl.h> #pragma hdrstop. #include <mmsystem.h> #include "joy1.h". //--------------------------------------------------------------------------- #pragma package(smart_init). #pragma resource "*.dfm". TForm1 *Form1; //--------------------------------------------------------------------------- __fastcall TForm1::TForm1(TComponent* Owner). : TForm(Owner). { } //--------------------------------------------------------------------------- Void __fastcall TForm1::FormCreate(TObject *Sender). { MMRESULT jr; JOYINFOEX JoyInfo; Int joycount=joyGetNumDevs(); If (joycount=0) Memo1->Lines->Add("Драйверы джойстика не установлены"); Else. { Connect=false; Jr=joyGetPosEx(JOYSTICKID1,&JoyInfo); If (jr ==JOYERR_NOERROR). { Connect=true; Jnum= JOYSTICKID1; } Else if (jr == MMSYSERR_INVALPARAM). ShowMessage("Ошибка определения наличия джойстика"); Else if((jr=joyGetPosEx(JOYSTICKID2,&JoyInfo)) == JOYERR_NOERROR). { Connect = true; Jnum= JOYSTICKID2; } } JoyGetDevCaps(jnum,&JoyCaps, sizeof(JOYCAPS)); If (connect) Memo1->Lines->Add("Джойстик подключен") ; Else Memo1->Lines->Add("Джойстик не подключен") ; Memo1->Lines->Add("Номер устройства - "+ IntToStr(jnum)); Memo1->Lines->Add("Наименование - " + AnsiString(JoyCaps.szPname)); Memo1->Lines->Add("Число кнопок - " + IntToStr(JoyCaps.wNumButtons)); If (connect) joySetCapture(Handle,jnum,2*JoyCaps.wPeriodMin,FALSE); StepX = (JoyCaps.wXmax - JoyCaps.wXmin)/ PaintBox1->Width; StepY = (JoyCaps.wYmax - JoyCaps.wYmin)/ PaintBox1->Height; } //--------------------------------------------------------------------------- Void __fastcall TForm1::UpdButton(TMessage &msg). { Shape1->Visible= (msg.WParam &JOY_BUTTON1); Shape2->Visible= (msg.WParam &JOY_BUTTON2); Shape3->Visible= (msg.WParam &JOY_BUTTON3); Shape4->Visible= (msg.WParam &JOY_BUTTON4); } //--------------------------------------------------------------------------- Void __fastcall TForm1::UpdCoord(TMessage &msg). { JOYINFO JoyInfo; TCanvas *pCanvas = PaintBox1->Canvas; PCanvas->Brush->Color=Form1->Color; PCanvas->FillRect(Rect(0,0,PaintBox1->Width,PaintBox1->Height)); Pos.x = msg.LParamLo; Pos.y = msg.LParamHi; Int x=(Pos.x-JoyCaps.wXmin)/stepX-ImageList1->Width/2; Int y=(Pos.y-JoyCaps.wYmin)/stepY-ImageList1->Height/2; ImageList1->Draw(pCanvas,x,y,0,true); } //--------------------------------------------------------------------------- Void __fastcall TForm1::FormDestroy(TObject *Sender). { If (connect) joyReleaseCapture(jnum); } //---------------------------------------------------------------------------
Запустив приложение при корректно установленном драйвере и подключенном джойстике, можно попробовать нажимать на кнопки и перемещать рычаг. При этом изображение прицела будет перемещаться внутри компонента TPaintBox, а при нажатии на кнопки на экране будут появляться красные эллипсы в соответствующих местах (рис.2).
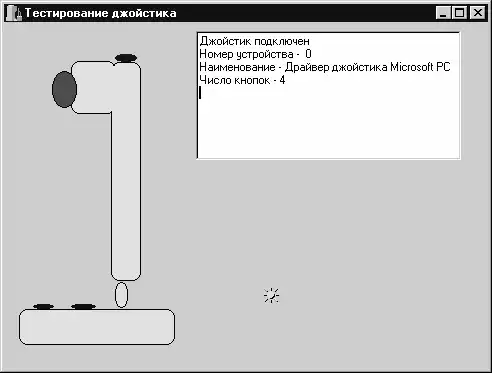
Рис.2. Приложение для тестирования джойстика на этапе выполнения
P.S. для дельфи практически всё так же, использованные функции api находятся в модуле mmsystem.pas.
Взято из http://delphi.chertenok.ru.
©Drkb::01623.
Немного философии.
| Немного философии |
8. Немного философии.
ВВЕДЕНИЕ.
Этот урок будет отличаться от других уроков в нашей серии по синтаксическому анализу и конструированию компиляторов. На этом уроке не будет никаких экспериментов или кода. На этот раз я хотел бы просто поговорить с вами некоторое время. К счастью, это будет короткий урок и затем мы сможем продолжить с того места где остановились, надо надеяться с обновленной энергией.
Когда я учился в университете, я обнаружил, что могу всегда следить за профессорской лекцией намного лучше, если знал куда он идет. Готов поспорить, с вами было то же самое.
Так что я подумал, может быть пришло время рассказать вам куда мы идем с этой серией: что нас ждет в будущих главах и вообще что к чему. Я также поделюсь своими общими мыслями о полезности того, что мы делали.
ДОРОГА ДОМОЙ.
Пока что мы охватили синтаксический анализ и трансляцию арифметических выражений, булевых выражений и их комбинаций, связанных операторами отношений. Мы также сделали то же самое для управляющих конструкций. Во всем этом мы склонялись в основном к использованию нисходящего синтаксического анализа методом рекурсивного спуска, определение синтаксиса в БНФ и непосредственной генерации ассемблерного кода. Мы также изучили значение такого приема как одно-символьные токены. В последней главе мы работали с лексическим анализом и я показал вам простой но мощный способ преодоления одно-символьного барьера.
В течение всех этих исследований, я особенно выделял философию KISS... Keep It Simple, Sidney... и я надеюсь, что к настоящему времени вы поняли, насколько простыми могут в действительности быть эти вещи. Хотя наверняка имеются области в теории компиляции которые являются по настоящему пугающими, основной мыслью этой серии является то, что на практике вы можете просто вежливо обойти многие из этих областей. Если определение языка способствует этому или, как в этой серии, если вы можете определить язык по ходу дела, то возможно записать определение языка в БНФ с достаточным удобством. И, как мы видели, вы можете вывести процедуры синтаксического анализа из БНФ почти также быстро, как вы можете набирать на клавиатуре.
По мере того, как наш компилятор принимал некоторую форму, он приобретал больше частей, но каждая часть довольно мала и проста и очень похожа на все другие.
К этому моменту у нас есть многое из того, что составляет настоящий практический компилятор. Фактически, мы уже имеем все что нам нужно для создания игрушечного языка столь же мощного, как, скажем, Tiny Basic. В следующих двух главах мы пойдем вперед и определим этот язык.
Для завершения этой серии, у нас все еще есть несколько тем для раскрытия. Они включают:
· Вызовы процедур, с параметрами и без.
· Локальные и глобальные переменные.
· Базовые типы, такие как символьные и целочисленные типы.
· Массивы.
· Строки.
· Типы и структуры, определяемые пользователем.
· Синтаксические анализаторы с деревьями и промежуточные языки.
· Оптимизация.
Все это будет рассмотрено в будущих главах. Когда мы закончим, вы будете иметь все инструменты, необходимые для разработки и создания своего собственного языка и компиляторов для его трансляции.
Я не могу спроектировать эти языки для вас, но я могу дать некоторые комментарии и рекомендации. Я уже высказал некоторые из них в прошлых главах. Вы видели, например, какие управляющие структуры я предпочитаю.
Эти конструкции будут частью создаваемых мной языков. К этому моменту я представляю три языка, два из которых вы увидите в очередных главах:
TINY - минимальный, но пригодный для использования язык уровня Tiny Basic или Tiny C. Он не будет очень практичным, но будет достаточно мощным, чтобы позволить вам писать и запускать настоящие программы которые делают что-нибудь заслуживающее внимание.
KISS - язык, который я создаю для своего собственного использования. KISS предназначен быть языком системного программирования. Он не будет иметь строгого контроля типов или причудливых структур данных, но он будет поддерживать большинство вещей, которые я хочу делать с языком более высокого уровня (HOL), за исключением возможно написания компиляторов.
Я также играл в течение нескольких лет с идеей HOL-подобного ассемблера со структурными управляющими конструкциями и HOL-подобными операциями присваивания. Это фактически было стимулом для моего первоначального углубления в джунгли теории компиляции. Этот язык возможно никогда не будет создан просто потому, что я узнал, что проще реализовать язык типа KISS, который использует только подмножество инструкций ЦПУ. Как вы знаете, ассемблер может быть предельно причудливым и нерегулярным, и язык, который отображается в него один к одному, может быть настоящим вызовом. Однако я всегда чувствовал, что синтаксис, используемый в стандартных ассемблерах тупой... почему.
MOVE.L A,B.
Лучше или проще для трансляции, чем.
B=A?
Я думаю, было бы интересным упражнением разработка "компилятора" который дал бы программисту полный доступ и к контролю над полным набором инструкций ЦПУ, и позволил бы вам генерировать программы настолько же эффективные как язык ассемблер без болезненного изучения набора мнемоник. Это может быть сделано? Я не знаю. Настоящим вопросом может быть вопрос "будет ли полученный язык проще, чем ассемблер?" Если нет, то в нем нет никакого смысла. Я думаю, что это может быть сделано, но я полностью еще не уверен в том, как должен выглядеть синтаксис.
Возможно у вас есть некоторые комментарии или предложения об этом. Буду рад услышать их.
Вы возможно не будете удивлены узнав, что уже работал в большинстве тех областей, которые мы рассмотрим. Я имею несколько хороших новостей: дела никогда не будут намного более сложными, чем они были до этого. Возможно построить завершенный, работающий компилятор для реального языка используя только те самые методы которые вы изучили до этого. И это поднимет некоторые интересные вопросы.
ПОЧЕМУ ЭТО ТАК ПРОСТО?
Перед осуществлением этой серии я всегда думал, что компиляторы были просто естественно сложными компьютерными программами... предельно вызывающими. Однако то, что мы здесь делали обычно оказывалось совершенно простым, иногда даже тривиальным.
Некоторое время я думал, что это было просто потому, что я еще не залез в глубь темы. Я только охватил простые части. Я легко признаюсь вам что даже когда я начинал эту серию я не был уверен в том, как далеко мы будем способны продвинуться прежде чем дела станут слишком сложными для работы имеющимися способами. Но сейчас я уже нахожусь достаточно близко, чтобы увидеть конец пути. Какой вывод?
ЗДЕСЬ НЕТ НИЧЕГО СЛОЖНОГО!
Затем я думал, что причина в том, что мы не генерировали очень хороший объектный код. Те из вас, кто следовали этой серии и пытались компилировать примеры, знают, что хотя код работает и достаточно отказоустойчив, его эффективность довольно ужасна. Я подчеркивал, что если бы мы сконцентрировались на получении компактного кода, то быстро бы получили всю недостающую сложность.
В какой то степени это так. В частности, мои первые небольшие усилия при попытке повысить эффективность подняли сложность до опасного уровня. Но с той поры когда я возился с некоторыми простыми методами оптимизацией и обнаружил некоторые, которые приводят к очень приличному качеству кода без добавления больших сложностей.
Наконец я подумал, что возможно причина была в "игрушечной" природе компилятора Я не претендовал на то, что мы когда-нибудь будем способны построить компилятор, конкурирующий с Borland и Microsoft. И однако снова, когда я забираюсь глубже в эти дела различия начинают стираться.
Просто чтобы удостовериться что до вас дошла эта мысль, позвольте мне ее высказать напрямую:
Используя методы, которые мы здесь применяли, возможно создать работающий, промышленного качества компилятор не добавляя много сложности к тому, что мы уже сделали.
С тех пор, как началась эта серия, я получил от вас некоторые комментарии. Большинство из них повторяют мои собственные мысли: "Это просто! Почему учебники представляют это настолько сложным?" Хороший вопрос.
Недавно я возвратился и взглянул на некоторые из этих текстов снова и даже купил и читаю некоторые новые. Каждый раз я возвращался с тем же чувством: эти ребята представляют это слишком сложным.
Что происходит? Почему все это кажется сложным в этих книгах, но легким для нас? Действительно ли мы умней чем Ахо, Ульман, Бринч Хансен и все остальные?
Едва ли. Но мы делаем некоторые вещи по-другому и все более и более я начинаю ценить значение нашего подхода и способ, которым он упрощает дело. Кроме очевидных сокращений, которые я выделил в первой части, типа одно-символьных токенов и консольного ввода/вывода, мы сделали некоторые неявные предположения и сделали некоторые вещи отличными от того, как разрабатывали компиляторы в прошлом. Как оказалось, наш метод делает жизнь намного проще.
Но почему все другие ребята не используют его?
Вы должны вспомнить контекст некоторых ранних разработок компиляторов. Эти люди работали на очень небольших компьютерах с ограниченными возможностями. Объемы памяти были очень ограничены, набор команд центрального процессора был минимален и программы чаще выполнялись в пакетном режиме, чем в интерактивном. Как оказалось, это повлияло на некоторые ключевые решения проекта, которые действительно усложнили проект. До недавнего времени я не понимал, насколько классический дизайн компилятора был обусловлен доступным оборудованием.
Даже в тех случаях, где эти ограничения больше не накладывались, люди предпочитали структурировать их программы тем же самым образом, так как это способ, которому они обучались.
В нашем случае мы начали с чистого листа бумаги. Имеется опасность, конечно, что вы попадетесь в ловушки, которые другие люди давно научились избегать. Но это также позволило нам использовать различные подходы, которые, частично из-за проекта, частично из-за чистой удачи, позволили нам добиться простоты.
Имеются области, которые, я думаю, в прошлом приводили к сложности:
· Ограниченная оперативная память, вынуждающая выполнять множество проходов.
Я только что прочитал "Brinch Hansen on Pascal Compilers" (отличная книга, BTW). Он разработал компилятор Pascal для PC, но он начал в 1981 г. с систем с 64К памяти и поэтому почти каждое решение проекта который он делал, было нацелено на то, чтобы уместить компилятор в ОЗУ. Чтобы сделать это, его компилятор выполнял три прохода, один из которых - лексический анализ. Не было никакого способа, с помощью которого он мог бы, например, использовать распределенный сканер, который я представил в последней главе, потому что структура программы не позволяла этого. Ему также требовались не один а два промежуточных языка для обеспечения связи между фазами.
Все ранние создатели компиляторов были вынуждены иметь дело с такой проблемой: разбить компилятор на достаточные части так, чтобы они поместились в памяти. Когда у вас есть множество проходов, вы должны добавить структуры данных для поддержки информации которую каждый проход оставляет для следующего. Это добавляет сложность и завершает управление проектом. В книге Ли "The Anatomy of a Compiler" упоминается компилятор Fortran, разработанный для IBM 1401. Он имел не менее 63 отдельных проходов! Само собой разумеется, в компиляторе, подобном этому, разделение на фазы доминировало бы над дизайном.
Даже в ситуации, когда ОЗУ достаточно, люди предпочитали использовать те же самые методы, с которыми они хорошо знакомы. До тех пор, пока не появился Turbo Pascal, мы не знали насколько может быть простым компилятор если бы вы начали с других предположений.
· Пакетная обработка.
В ранние дни пакетная обработка была единственным выбором... не существовало никаких интерактивных вычислений. Даже сегодня компиляторы по существу выполняются в пакетном режиме.
В компиляторах для майн-фреймов, так же как и во многих микро компиляторах, значительные усилия расходуются на восстановление после ошибок... это может занять 30-40% компилятора и полностью управлять проектом. Идея состоит в том, чтобы избежать остановки на первой ошибке, а скорее идти любой ценой, так чтобы вы могли сказать программисту о как можно большем количестве ошибок во всей программе насколько возможно.
Все это возвращает нас к дням ранних майн-фреймов, где время выполнения измерялось в часах и днях и было важно выжать каждую последнюю унцию информации из каждого выполнения.
В этой серии я был очень осторожен и избежал проблемы восстановления после ошибок и вместо этого наш компилятор просто останавливается с сообщением на первой ошибке. Я откровенно признаюсь, что это было в основном потому, что я захотел использовать легкий путь и сохранить простоту. Но этот метод, заданный изначально Borland в Turbo Pascal также имеет много полезного в любом случае. Кроме сохранения простоты компилятора это также очень хорошо соответствует идее интерактивной системы. Когда компиляция происходит быстро и, особенно, когда вы имеете редактор типа Borland который будет правильно указывать вам на точку ошибки, тогда имеет смысл остановиться там и просто перезапустить компиляцию после того, как ошибка исправлена.
· Большие программы.
Ранние компиляторы были разработаны для поддержки больших программ... по существу бесконечных. В те дни существовал небольшой выбор; идея с библиотеками подпрограмм и раздельной компиляцией была еще в будущем. Снова, это предположение вело к многопроходному дизайну и промежуточным файлам для поддержки результатов раздельной обработки.
Поставленная Бринч Хансеном цель состояла в том, чтобы компилятор был способен компилировать сам себя. Снова, из-за ограничений оперативной памяти это приводило его к многопроходному дизайну. Он нуждался в таком маленьком резидентном коде компилятора, насколько возможно, так чтобы необходимые таблицы и другие структуры данных поместились в оперативную память.
Я не заявил об этом пока, потому что не было необходимости... мы всегда просто читали и записывали данные как потоки, в любом случае. Но, для заметки, мой план всегда был в том, чтобы в промышленном компиляторе исходные и объектные данные должны сосуществовать в ОЗУ с компилятором, а ля ранний Turbo Pascal. Вот почему я был осторожен и сохранил подпрограммы типа GetChar и Emit как отдельные подпрограммы, несмотря на их небольшой размер. Будет просто изменить их на чтение и запись из памяти.
· Акцент на эффективность.
Джон Бэкус заявил, что когда он и его коллеги разработали первоначальный компилятор Fortran они знали, что они должны получать компактный код. В те дни имелись сильные чувства против HOL в пользу ассемблера и причиной была эффективность. Если бы Fortran не производил очень хороший код по стандартам ассемблера, пользователи просто бы отказались использовать его. Заметьте, компилятор Fortran оказался одним из наиболее эффективных из когда либо созданных в терминах качества кода. Но он был сложным!
Сегодня мы имеем мощь ЦПУ и размер ОЗУ с запасом, так что эффективность кода не такая большая проблема. Старательно игнорируя эту проблему мы действительно были способны сохранить простоту. Как ни странно, тем не менее, как я сказал, я нашел некоторую оптимизацию которую мы можем добавить в базовую структуру компилятора не добавляя слишком много сложности. Так что в этом случае мы получим свой пирог и съедим его: мы в любом случае закончим с приемлемым качеством кода.
· Ограниченный набор инструкций.
Первые компьютеры имели примитивный набор команд. Вещи, которые мы считаем само собой разумеющимися, такие как операции со стеком и косвенная адресация появились с большими сложностями.
Пример: в большинстве компиляторов имеется структура данных, называемая литерный пул (literal pool). Компилятор обычно идентифицирует все литералы, используемые в программе, и собирает их в одиночную структуру данных. Все ссылки на литералы сделаны косвенно на этот пул. В конце компиляции компилятор выдает команды для выделения памяти и инициализации литерного пула.
Нам пока не нужно было обращаться к этой проблеме. Когда нам нужно загрузить литерал мы просто делаем это строкой:
MOVE #3,D0.
Можно кое-что упомянуть об использования литерного пула особенно на машине типа 8086, где данные и код могут быть разделены. Однако все это добавляет довольно большое количество сложности с небольшим результатом.
Конечно, без стека мы бы потерялись. И вызовы подпрограмм и временная память сильно зависят от стека и мы использовали его даже больше, чем необходимо для облегчения синтаксического анализа выражений.
· Желание общности.
Многое из содержимого типичной книги по компиляторам акцентировано на вопросы, к которым мы совсем не обращались... вопросы типа автоматической трансляции грамматик или генерация таблиц LALR анализа. Это не просто, потому что авторы хотят впечатлить вас. Имеются хорошие практические причины, почему эти темы рассмотрены здесь.
Мы концентрировались на использовании синтаксического анализатора с рекурсивным спуском для анализа детерминированной грамматики, т.е. грамматики, которая однозначна и, следовательно, может быть проанализирована с одним уровнем предсказания. Я не сделал из этого большого ограничения, но факт то, что это представляет небольшое подмножество возможных грамматик. Фактически, существует бесконечное число грамматик, которые мы не можем анализировать используя наш метод. LR метод более мощный и может работать с теми грамматиками, с которыми мы не можем.
В теории компиляции важно знать, как работать с этими другими грамматиками и как преобразовать их в грамматики которые проще для работы с ними. К примеру многие (но не все) неоднозначные грамматики могут быть преобразованы в однозначные. Способ сделать это не всегда очевиден, все таки, и так много людей посвятили годы на разработку способа их автоматического преобразования.
На практике, эти проблемы оказываются значительно менее важными. Современные языки стараются разрабатывать так, чтобы они были простыми для анализа в любом случае. Это было ключевой мотивацией при разработке Pascal. Несомненно, имеются паталогические грамматики, для которых вы с большим трудом написали бы однозначную БНФ, но в реальном мире лучшим ответом возможно было бы избежание этих грамматик.
В нашем случае, конечно, мы трусливо позволили языку развиваться по ходу дела. Вы не можете всегда иметь такую роскошь. Однако, с небольшой заботой вы были бы способны сохранить синтаксический анализатор простым без необходимости прибегать к автоматическому переводу грамматик.
В этой серии мы приняли значительно отличающийся подход. Мы начали с чистого листа бумаги и разработали методы, которые работают в том контексте, в котором мы находимся: это однопользовательский персональный компьютер с вполне достаточно мощным ЦПУ и объемом ОЗУ. Мы ограничили сами себя приемлемыми грамматиками, которые легки для анализа, мы с успехом использовали систему команд ЦПУ, и мы не концентрировались на эффективности. Именно поэтому это было просто.
Означает ли это, что мы навсегда обречены создавать только игрушечные компиляторы? Нет, я так не думаю. Я уже сказал, что мы можем добавить некоторую оптимизацию без изменения структуры компилятора. Если мы захотим обрабатывать большие файлы, мы всегда можем добавить для этого буферизацию файлов. Эти вещи не оказывают влияния на общий дизайн компилятора.
И я думаю что это главный фактор. Начав с маленьких и ограниченных случаев мы были способны сконцентрироваться на структуре компилятора, которая естественна для работы. Так как структура естественным образом удовлетворяет работе, она почти обречена быть простой и прозрачной. Добавление возможностей не должно изменять основную структуру. Мы можем просто добавить расширения типа файловой структуры или добавить уровень оптимизации. Я считаю, что когда ресурсы были ограничены, структуры, которые люди получали, были искусственно искажены чтобы заставить их работать в этих условиях, и не были оптимальными структурами для имеющейся проблемы.
ЗАКЛЮЧЕНИЕ.
В любом случае, это мое личное предположение каким образом у нас была возможность сохранить простоту. Мы начали с чего-то простого и позволили ему развиваться естественным образом, не пытаясь направит его в какое-то традиционное русло.
Мы собираемся продолжать таким же образом. Я дал вам список областей, которые мы охватим в следующих главах. После прочтения этих глав вы будете способны создавать законченные, работающие компиляторы почти для любого случая и делать это легко. Если вы действительно хотите создать компилятор промышленного качества вы сможете сделать и это также.
Для тех из вас, кто застоялся в ожидании кода для синтаксического анализатора, я приношу извинения за это отклонение. Я просто подумал, что вы хотели бы немного рассмотреть дела в перспективе. В следующий раз мы вернемся к основной цели обучения.
Пока что мы рассмотрели только части компиляторов и хотя мы имеем многое из завершенного языка мы не говорили о том как сложить все это вместе. Это будет темой наших следующих двух глав. Затем мы поспешим к новым темам, которые я указал в начале этой главы.
Очень простой пример поиска информации в реестре.
| Очень простой пример поиска информации в реестре. |
Очень простой пример поиска информации в реестре. Используется стандартный класс TRegistry.
Скачать демонстрационный пример
Александр (Rouse_) Багель.
©Drkb::02280.
| Парсер подавляющего большинства нотаций XML. |
Автор: Delirium Сайт: http://delphibase.endimus.com.
Code: { **** UBPFD *********** by delphibase.endimus.com **** >> Парсер подавляющего большинства нотаций XML. Для задачи десериализации мне потребовался парсер. Основное преимущество - никак не связан с операционной системой. (в отличие от TXMLDocument), ну и разумеется - простота :). Зависимости: SysUtils, StrUtils. Автор: Delirium, VideoDVD@hotmail.com, ICQ:118395746, Москва. Copyright: Delirium (Master BRAIN) 2003. Дата: 16 сентября 2003 г. ***************************************************** } Unit BNFXMLParser; Interface. Uses SysUtils, StrUtils; Type. PXMLNode = ^TXMLNode; TXMLValues = (TextNode, XMLNode); TXMLNode = record. Name: string; Attributes: array of record. Name: string; Value: string; End; SubNodes: array of record. RecType: TXMLValues; Case TXMLValues of. TextNode: (Text: PString); XMLNode: (XML: PXMLNode); End; Parent: PXMLNode; End; Function BNFXMLTree(var Value: string): PXMLNode; Implementation. Function fnTEG(var Node: PXMLNode; var Value: string): boolean; forward; Function fnVAL(var Node: PXMLNode; var Value: string): boolean; forward; Function fnATT(var Node: PXMLNode; var Value: string): boolean; forward; Function fnXML(var Node: PXMLNode; var Value: string): boolean; Var. I: integer; Begin. If (Pos('<', Value) > 0). And (Pos('>', Value) > Pos('<', Value)). And (Pos('<', Value) <> Pos('</', Value)) then. Begin. // Оганизую узел. If Node = nil then. Begin. New(Node); Node.Parent := nil; End. Else. Begin. I := length(Node.SubNodes); Setlength(Node.SubNodes, i + 1); New(Node.SubNodes[i].XML); Node.SubNodes[i].RecType := XMLNode; Node.SubNodes[i].XML.Parent := Node; Node := Node.SubNodes[i].XML; End; Result := fnTEG(Node, Value); End // '<' Else. Result := True; End; Function fnTEG(var Node: PXMLNode; var Value: string): boolean; Var. I, i1, i2, i3: integer; S: string; Begin. Result := False; I1 := Pos('<', Value); If i1 > 0 then. Begin. I2 := PosEx('/>', Value, i1); I3 := PosEx('>', Value, i1); If (i2 > 0) and (i2 < i3) then. Begin // <abc/> // Value. S := Copy(Value, i1 + 1, (i2 - i1) - 1); Delete(Value, i1, (i2 - i1) + 2); // TEXT, этот текст пренадлежит предку. If Node.Parent <> nil then. Begin // Добавляюсь к предку. I := length(Node.Parent.SubNodes); Setlength(Node.Parent.SubNodes, i + 1); New(Node.Parent.SubNodes[i].Text); Node.Parent.SubNodes[i].RecType := TextNode; Node.Parent.SubNodes[i].Text^ := Copy(Value, 1, Pos('<', Value) - 1); End; Delete(Value, 1, Pos('<', Value) - 1); // If fnVAL(Node, S) then. Begin // Вложенных тегов не бывает. Node := Node.Parent; Result := fnXML(Node, Value); End; End. Else. Begin // <abc>...</abc> // Value. S := Copy(Value, i1 + 1, (i3 - i1) - 1); Delete(Value, i1, (i3 - i1) + 1); // TEXT. I := length(Node.SubNodes); Setlength(Node.SubNodes, i + 1); New(Node.SubNodes[i].Text); Node.SubNodes[i].RecType := TextNode; Node.SubNodes[i].Text^ := Copy(Value, 1, Pos('<', Value) - 1); Delete(Value, 1, Pos('<', Value) - 1); // If fnVAL(Node, S) then. Begin // Val. // Проверяю закрытие тега, удаляю хвост и передаю управление предку. If Pos('</' + AnsiLowerCase(Node.Name) + '>', AnsiLowerCase(Value)) = 1. Then. Begin. Delete(Value, 1, Length('</' + Node.Name + '>')); // TEXT принадлежащий предку. If Node.Parent <> nil then. Begin // Добавляюсь к предку. I := length(Node.Parent.SubNodes); Setlength(Node.Parent.SubNodes, i + 1); New(Node.Parent.SubNodes[i].Text); Node.Parent.SubNodes[i].RecType := TextNode; Node.Parent.SubNodes[i].Text^ := Copy(Value, 1, Pos('<', Value) - 1); End; Delete(Value, 1, Pos('<', Value) - 1); Node := Node.Parent; Result := fnXML(Node, Value); End. Else. Begin. // Обрабатываю вложенные теги, на выходе мой узел. If fnXML(Node, Value) then. Begin. // закрываю его. If Pos('</' + AnsiLowerCase(Node.Name) + '>', AnsiLowerCase(Value)). = 1 then. Begin. Delete(Value, 1, Length('</' + Node.Name + '>')); // TEXT принадлежащий предку. If Node.Parent <> nil then. Begin // Добавляюсь к предку. I := length(Node.Parent.SubNodes); Setlength(Node.Parent.SubNodes, i + 1); New(Node.Parent.SubNodes[i].Text); Node.Parent.SubNodes[i].RecType := TextNode; Node.Parent.SubNodes[i].Text^ := Copy(Value, 1, Pos('<', Value). - 1); End; Delete(Value, 1, Pos('<', Value) - 1); End; // Остальной XML - предку. If Node.Parent <> nil then. Node := Node.Parent; Result := fnXML(Node, Value); End; End; End; // Val. End; // <abc>...</abc> End; // i1. End; Function fnVAL(var Node: PXMLNode; var Value: string): boolean; Begin. Value := AnsiReplaceStr(Value, '''', '"'); If (Pos(' ', Value) > 0). And (Pos('="', Value) > Pos(' ', Value)) then. Begin. Node.Name := Trim(Copy(Value, 1, Pos(' ', Value) - 1)); // Название тега Name. Delete(Value, 1, Pos(' ', Value)); Result := fnATT(Node, Value); End // ' ' и ('="' Else. Begin. // Название тега Name. Value := Trim(Value); If Pos(' ', Value) > 0 then. Node.Name := Copy(Value, 1, Pos(' ', Value) - 1). Else. Node.Name := Value; Value := ''; Result := True; End; End; Function fnATT(var Node: PXMLNode; var Value: string): boolean; Begin. Result := True; Value := Trim(Value); If Pos('="', Value) > 0 then. Begin. Result := False; SetLength(Node.Attributes, Length(Node.Attributes) + 1); // Название атрибута. Node.Attributes[Length(Node.Attributes) - 1].Name := Trim(Copy(Value, 1, Pos('="', Value) - 1)); Delete(Value, 1, Pos('="', Value) + 1); If Pos('"', Value) > 0 then. Begin. // Значение атрибута. Node.Attributes[Length(Node.Attributes) - 1].Value := Copy(Value, 1, Pos('"', Value) - 1); Delete(Value, 1, Pos('"', Value)); If Length(Value) > 0 then. Result := fnATT(Node, Value). Else. Result := True; End; End; End; Function BNFXMLTree(var Value: string): PXMLNode; Begin. Result := nil; FnXML(Result, Value); End; End.
| Парсер XML. |
Code: { **** UBPFD *********** by kladovka.net.ru **** >> Разбор XML. Данный прасер не такой универсальный, как предыдущий, за то - почти в 1000 раз эффективнее! Зависимости: Windows, Forms, SysUtils, StrUtils. Автор: Delirium, VideoDVD@hotmail.com, ICQ:118395746, Москва. Copyright: Delirium (Master BRAIN) 2003. Дата: 22 октября 2003 г. ********************************************** } Unit BNFXMLParser2; Interface. Uses Windows, Forms, SysUtils, StrUtils; Type. PXMLNode=^TXMLNode; PXMLTree=^TXMLTree; TXMLAttr=record. NameIndex, NameSize:integer; TextIndex, TextSize:integer; End; TXMLNode=record. NameIndex, NameSize:integer; Attributes:array of TXMLAttr; TextIndex, TextSize:integer; SubNodes:array of PXMLNode; Parent:PXMLNode; Data:PString; End; TXMLTree=record. Data:PString; TextSize:integer; NodesCount:integer; Nodes:array of PXMLNode; End; Function BNFXMLTree(Value:String):PXMLTree; Function GetXMLNodeName(Node:PXMLNode):String; Function GetXMLNodeText(Node:PXMLNode):String; Function GetXMLNodeAttr(AttrName:String; Node:PXMLNode):String; Implementation. Function BNFXMLTree(Value:String):PXMLTree; Var LPos, k, State, CurAttr:integer; I:integer; CurNode:PXMLNode; Begin. New(Result); Result^.TextSize:=Pos('<', Value)-1; New(Result^.Data); Result^.Data^:=Value; K:=0; State:=0; CurNode:=nil; CurAttr:=-1; For LPos:=Result.TextSize+1 to Length(Value) do. Case State of. 0:case Value[LPos] of. '<':begin. I:=length(Result.Nodes); Setlength(Result.Nodes, i+1); New(Result.Nodes[i]); Inc(k); If k mod 10 = 0 then. Begin. Application.ProcessMessages; If k mod 100 = 0 then SleepEx(1, True); End; CurNode:=Result.Nodes[i]; CurNode^.NameIndex:=0; CurNode^.NameSize:=0; CurNode^.TextIndex:=0; CurNode^.Parent:=nil; CurNode^.Data:=Result^.Data; State:=1; End; End; 1:case Value[LPos] of. ' ':; '>':State:=9; '/':State:=10; Else begin. CurNode^.NameIndex:=LPos; CurNode^.NameSize:=1; State:=2; End; End; 2:case Value[LPos] of. ' ':State:=3; '>':State:=9; '/':State:=10; Else Inc(CurNode^.NameSize); End; 3:case Value[LPos] of. ' ':; '>':State:=9; '/':State:=10; Else begin. I:=length(CurNode^.Attributes); Setlength(CurNode^.Attributes, i+1); CurNode^.Attributes[i].NameIndex:=LPos; CurNode^.Attributes[i].NameSize:=1; CurAttr:=i; State:=4; End; End; 4:case Value[LPos] of. '=':State:=5; Else Inc(CurNode^.Attributes[CurAttr].NameSize); End; 5:case Value[LPos] of. '''':State:=6; '"':State:=7; End; 6:case Value[LPos] of. '''':begin. CurNode^.Attributes[CurAttr].TextIndex:=LPos; CurNode^.Attributes[CurAttr].TextSize:=0; State:=8; End; Else begin. CurNode^.Attributes[CurAttr].TextIndex:=LPos; CurNode^.Attributes[CurAttr].TextSize:=1; State:=61; End; End; 7:case Value[LPos] of. '"':begin. CurNode^.Attributes[CurAttr].TextIndex:=LPos; CurNode^.Attributes[CurAttr].TextSize:=0; State:=8; End; Else begin. CurNode^.Attributes[CurAttr].TextIndex:=LPos; CurNode^.Attributes[CurAttr].TextSize:=1; State:=71; End; End; 61:case Value[LPos] of. '''':State:=8; Else Inc(CurNode^.Attributes[CurAttr].TextSize); End; 71:case Value[LPos] of. '"':State:=8; Else Inc(CurNode^.Attributes[CurAttr].TextSize); End; 8:case Value[LPos] of. ' ':State:=3; '>':State:=9; '/':State:=10; End; 9:case Value[LPos] of. '<':State:=12; Else begin. CurNode^.TextIndex:=LPos; CurNode^.TextSize:=1; State:=11; End; End; 10:case Value[LPos] of. '>':begin. CurNode:=CurNode^.Parent; If CurNode=nil. Then State:=0. Else State:=9; End; End; 11:case Value[LPos] of. '<':State:=12; Else Inc(CurNode^.TextSize); End; 12:case Value[LPos] of. '/':State:=10; Else begin. I:=length(CurNode^.SubNodes); Setlength(CurNode^.SubNodes, i+1); New(CurNode^.SubNodes[i]); Inc(k); If k mod 10 = 0 then. Begin. Application.ProcessMessages; If k mod 100 = 0 then SleepEx(1, True); End; CurNode^.SubNodes[i]^.Parent:=CurNode; CurNode^.SubNodes[i]^.Data:=Result^.Data; CurNode^.SubNodes[i].NameIndex:=LPos; CurNode^.SubNodes[i].NameSize:=1; CurNode^.SubNodes[i].TextIndex:=0; CurNode:=CurNode^.SubNodes[i]; State:=2; End; End; End; Result^.NodesCount:=k; End; Function GetXMLNodeName(Node:PXMLNode):String; Begin. Result:=Copy(Node^.Data^, Node^.NameIndex, Node^.NameSize); End; Function GetXMLNodeText(Node:PXMLNode):String; Begin. Result:=Copy(Node^.Data^, Node^.TextIndex, Node^.TextSize); End; Function GetXMLNodeAttr(AttrName:String; Node:PXMLNode):String; Var i:integer; Begin. Result:=''; If Length(Node^.Attributes)=0 then exit; I:=0; While (i<Length(Node^.Attributes)). And (AnsiLowerCase(AttrName)<>AnsiLowerCase(Trim(Copy(Node^.Data^, Node^.Attributes[i].NameIndex, Node^.Attributes[i].NameSize)))). Do Inc(i); Result:=Copy(Node^.Data^, Node^.Attributes[i].TextIndex, Node^.Attributes[i].TextSize); End; End.
| Несколько расширенных функций по определению позиции |
| Массив Edit-компонентов |
Code: Procedure DoSomethingWithEditControls; Var. K: Integer; EditArray: array[0..99] of Tedit; Begin. Try. For K := 0 to 99 do. Begin. EditArray[K] := TEdit.Create(Self); EditArray[K].Parent := Self; {Устанавливаем необходимые свойства TEdit}. SetSomeOtherPropertiesOfTEdit; Left := 100; Top := K * 10; {Что-то делаем при перемещении мыши}. OnMouseMove := WhatToDoWhenMouseIsMoved; End; {Делаем все что хотим с полученным массивом Edit-компонентов}. DoWhateverYouWantToDoWithTheseEdits; Finally. For K := 0 to 99 do. EditArray[K].Free; End; End;
| Массив компонентов |
Возможно ли создание массива компонентов? Для показа статуса я использую набор LED-компонентов и хотел бы иметь к ним доступ, используя массив.
| Масштабирование для Canvas. |
Code: Procedure SetCanvasZoomFactor(Canvas: TCanvas; AZoomFactor: Integer); Var. I: Integer; Begin. If AZoomFactor = 100 then. SetMapMode(Canvas.Handle, MM_TEXT). Else. Begin. SetMapMode(Canvas.Handle, MM_ISOTROPIC); SetWindowExtEx(Canvas.Handle, AZoomFactor, AZoomFactor, nil); SetViewportExtEx(Canvas.Handle, 100, 100, nil); End; End; Procedure TForm1.Button1Click(Sender: TObject); Var. Bitmap: TBitmap; Begin. Bitmap := TBitmap.Create; Try. Bitmap.Assign(Form1.image1.Picture.Bitmap); SetCanvasZoomFactor(bitmap.Canvas, 70); Canvas.Draw(30, 30, bitmap); Finally. Bitmap.Free. End; End;
| Масштабирование формы под разрешение экрана |
Эта подпрограмма сделает жизнь программиста намного легче. Она делает так, чтобы ваша программа корректно масштабировалась при ЛЮБОМ разрешении экрана. Обратите внимание на число 640. Дело в том, что я разрабатываю свои приложения при разрешении 640x480. Вы можете настроить подпрограмму на ваше экранное разрешение при разработке программ и больше не беспокоиться о всевозможных низких и больших разрешений ваших пользователей. Разместите в обработчике события формы (которую вы хотите автомасштабировать) OnCreate следующую строку:
| Пасхальные яйца в Delphi. |
Пасхальные яйца были придуманы самими разработчиками программного продукта, чтобы хранить в них информацию о себе. Однако потом пасхальные яйца стали использоваться для небольших игрушек или смешных надписей.
| Нестрогое сравнение строк |
| Настройка панелей и меню |
Автор: Дмитрий Кузан
| Настройка сетки графика по оси ординат |
Code: { **** UBPFD *********** by kladovka.net.ru **** >> Настройка оси. Настройка сетки графика по оси ординат. Имеет смысл при. Передаче данных в другие пакеты, использующие графическое. Представление данных (например, в Excel). Зависимости: uses Chart, TeEngine, Math; Автор: lookin. Copyright: lookin. Дата: 25 декабря 2002 г. ********************************************** } //для использования в Delphi. Procedure CalcAxis(NChart: TChart); Var step,ymx,ymn,rmx,rmn,raz: double; I,n,m,d: integer; Begin. With NChart do begin ymx:=-10000000000; ymn:=10000000000; m:=0; n:=0; For i:=0 to SeriesCount-1 do if Series[i].XValues.Count<>0 then begin. If Series[i].YValues.MaxValue>ymx then ymx:=Series[i].YValues.MaxValue; If Series[i].YValues.MinValue<ymn then ymn:=Series[i].YValues.MinValue; end; Rmx:=ymx; rmn:=ymn; While ymn<0 do begin ymn:=ymn+100; ymx:=ymx+100; Inc(m); end; raz:=ymx-ymn; While raz<100 do begin ymn:=ymn*10; ymx:=ymx*10; raz:=ymx-ymn; Inc(n); end; Ymx:=Ceil(ymx); ymn:=Floor(ymn); D:=trunc(ymx) div 100; ymx:=(d+1)*100; D:=trunc(ymn) div 100; ymn:=d*100; raz:=ymx-ymn; step:=raz/5; Ymx:=ymx/(Power(10,n))-m*100; ymn:=ymn/(Power(10,n))-m*100; Step:=step/(Power(10,n)); d:=0; For i:=1 to 5 do if (d=0) and (ymn+step*i>rmx) then d:=i; If d<>0 then ymx:=ymn+step*d; d:=0; For i:=1 to 5 do if (d=0) and (ymn+step*i<rmn) then d:=i; If d<>0 then ymn:=ymn+step*d; With LeftAxis do begin Automatic:=false; Increment:=step; Minimum:=-100000000000; Maximum:=ymx; Minimum:=ymn; end; end; End;
Настройка системы безопасности DCOM сервера.
| Настройка системы безопасности DCOM сервера |
Алексей Вуколов
Как я понял, основная проблема в DCOM, с которой сталкиваются разработчики - настройка системы безопасности. Далее описано, как были сделаны настройки безопасности у меня.
Создана группа, в которую включены пользователи, которым нужен доступ к данному DCOM серверу (назовем ее DCOM_DEBUG).
В DCOMCNFG : (это было добавлено и на сервере и на клиенте).
DefaultSecurity -> Default Access Permissions.
DCOM_DEBUG: Allow Access.
SYSTEM: Allow Access.
Everyone: Allow Access.
2.DefaultSecurity -> Default Launch Permissions.
DCOM_DEBUG: Allow Launch.
SYSTEM: Allow Launch.
INTERACTIVE: Allow Launch.
Everyone: Allow Launch.
3.DefaultSecurity -> Default Configuration Permissions.
SYSTEM: Full Control.
DCOM_DEBUG: Full Control.
Everyone: Full Control.
Установка этих параметров необходима, по-моему, потому, что контекст безопасности интерфейса передаваемого на сервер для нотификации клиента берется из установок по умолчанию.
Только на сервере.
Установки параметров безопасности для объекта были установлены точно такие же, за исключением того, что Everyone включена не была. На вкладке Identity был выбран пользователь, от имени которого запускается COM сервер. Одна тонкость: у пользователя, от имени которого запускается COM сервер должно быть право "Log on as batch job", иначе сервер не запустится (это право было дано всей группе DCOM_DEBUG). Если выбрать Interactive User, то сервер не запустится, в том случае если пользователь делает Logoff. В случае с Launching User происходили какие-то невнятные проблемы (видимо это было связано со спецификой решаемой мной задачи - DCOM сервер с поддержкой множественных клиентских соединений).
©Drkb::04327.
Настройки листа и печать в MS Excel.
| Настройки листа и печать в MS Excel. |
После окончательного формирования информации на листе рабочей книги необходимо задать настройки листа и переходить к печати. Эта часть будет посвящена функциям настройки общих параметров листа, выбора и настройки принтера, подготовки листа и функциям печати. Excel.Application имеет большие возможности для выбора и настройки принтера и параметров печати. Здесь представлен только минимальный их набор. Если в вашей операционной системе не установлен принтер, то большинство описанных ниже функций завершится ошибкой. Для использования информации в своих приложениях начните изучение статьи с первой части.
Местоположение символа в строке.
| Местоположение символа в строке |
Code: CHARINDEX('#',@TableName).
©Drkb::02825.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
Место занимаемое таблицей.
| Место занимаемое таблицей |
Code: Exec master..sp_spaceused MyTable.
©Drkb::02843.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
Математические основы реляционных СУБД.
| Математические основы реляционных СУБД |
Понятие отношения. Основные операции. Реляционная алгебра и реляционное исчисление. Понятие о нормализации. Первая, вторая, третья и четвертая нормальные формы.
4.1. Основные понятия.
Дадим точное, математическое понятие терминов, используемых для реляционных баз данных.
Доменом называется некоторое множество значений определенного типа. Это множество может быть конечным, так и бесконечным. Например, доменом является множество {true, false}, множество всех целых чисел, множество всех символьных строк и т.д. Декартовым произведением доменов D1, D2,…., Dk, обозначаемое как D1ЧD2Ч….ЧDк называется множество всех кортежей (d1, d2,…., dk), где di принадлежит Di. То есть декартовое произведение состоит из всех возможных комбинаций значений из доменов. Общее число кортежей в декартовом произведении равно произведению размеров каждого домена. Кроме того, ничто не мешает умножать домены сами на себя.
Существенным в декартовом произведении является порядок доменов. Так, D1ЧD2 не равно D2ЧD1. При сравнении кортежей внутри одного произведения также важно учитывать порядок значений внутри кортежа - кортеж (0, 1) не равен кортежу (1, 0).
Отношением называется некоторое подмножество декартового произведения доменов. Это множество может быть пустым. Теоретически, ничто не мешает отношению состоять из бесконечного числа кортежей, но в приложении к базам данных имеет смысл рассматривать только конечные множества.
В реальных, практических задачах имеет смысл ввести именование доменов внутри декартового произведения (и, следовательно, построенного из него отношения), что позволит отказаться от нумерации доменов и использовать более привычное именование. Кроме того, в реляционных базах данных используется термин таблица вместо отношения, и термин запись или ряд вместо кортежа. Мы будем использовать эти термины в одном смысле, но при описании математических деталей будет использоваться термин “отношение”, а при рассмотрении конкретных задач - термин “таблица”.
Для представления реальных сущностей (объектов) используется следующая интерпретация приведенных выше математических понятий. Каждый домен, который мы договорились именовать, описывает некоторый атрибут, то есть ту или иную именованную характеристику реальной сущности, реального объекта. Например, это может быть “вес” (тогда домен представляет собой положительное целое), это может быть “имя” (тогда домен есть множество символьных строк) и т.д. Таблица описывает некоторую совокупность однотипных объектов реального мира (например, сотрудников на предприятии, список продаваемых товаров и т.д.), а каждая отдельная запись в отношении описывает некоторый конкретный объект (конкретного человека или конкретный товар). При этом каждая запись состоит из значений атрибутов, которые определяют характеристики этой сущности или объекта. Например, если мы описываем товары, то атрибутами будут (имеет смысл выбрать эти атрибуты) название, стоимость, условия хранения, вес, габариты и т.д. Какие именно атрибуты будут задействованы, какие именно названия будут им приписаны, зависит от предметной области, от того, как это будет реализовано разработчиками. Приведем пример таблицы, описывающей товары и имеющей атрибуты “товар” (определяет название товара), “производитель” (определяет фирму, которая произвела этот товар) и “адрес” (определяет адрес фирмы, произведшей данный товар):
-----------T--------------------------T-----------------+ ¦ Товар ¦ производитель ¦ Адрес ¦ +----------+--------------------------+-----------------+ ¦ рога ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ копыта ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ кеды ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ джинсы ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ L----------+--------------------------+------------------
Рис. 4.1. Пример таблицы “Товары”.
Отметим еще раз, что, так как атрибуты именованы, и порядок записей в таблице не важен, можно поменять порядок столбцов и строк, а таблица с точки зрения реляционной модели останется той же самой:
+--------------------------T---------T ----------------+ ¦ производитель ¦ Товар ¦ Адрес ¦ +--------------------------+---------+-----------------+ ¦ АО Рога и Копыта ¦ кеды ¦ Одесса, п/я 13 ¦ ¦ АО Рога и Копыта ¦ копыта ¦ Одесса, п/я 13 ¦ ¦ ТОО Добро пожаловать ¦ джинсы ¦ Энск, 5-е авеню ¦ ¦ АО Рога и Копыта ¦ рога ¦ Одесса, п/я 13 ¦ L--------------------------+---------+------------------
Рис. 4.2. Другой вариант представления таблицы “Товары” из рисунка 4.1.
4.2. Ключи.
Для реальной работы с объектами, описанными в таблице, нужно уметь их различать. Один и тот же поставщик может поставлять два разных товара с одним и тем же названием (джинсы и джинсы). При этом могут совпадать и другие атрибуты (например, цена). Тем не менее, физически это будут разные товары. Для идентификации записей используются ключи. Ключ - это набор атрибутов, которые позволяет идентифицировать запись внутри таблицы, при этом никакое подмножество этих атрибутов не будет ключом. Ключ может быть простым и составным. Простой ключ состоит из одного атрибута, составной ключ - из двух и более. Атрибут, входящий в тот или иной ключ, называется ключевым атрибутом. Соответственно, ключ, который не входит ни в один из ключей, называется неключевым атрибутом.
Заметим, что ключ должен гарантировать уникальную идентификацию записи для всех возможных комбинаций записей в отношении. Например, в таблице с описанием товаров, представленной на рисунках 4.1. и 4.2., если смотреть по ее конкретному состоянию, поле “Товар” вроде бы может считать ключом (в этой таблице 4 записи, в поле “Товар” имеем 4 разных значения и каждая запись в данной ситуации может быть идентифицирована по полю “Товар”). Однако очевидно, что один и тот же товар может поставляться несколькими поставщиками и в общем случае в данной таблице поле “Товар” не может считаться ключевым. Более того, в той схеме, какую эта таблица имеет сейчас, вообще нет ключей.
Некоторый ключ, который разаработчики или проектировщики схемы базы данных выделяют и стараются использовать, называется первичным. Любой из ключей может считаться первичным, вопрос именно в предпочтении и простоте использования.
Ключи бывают естественными и искусственными. Естественный ключ состоит из реальных атрибутов, то есть атрибутов, которые существуют в предметной области и которые представляют интерес для решаемой задачи (например, фамилия-имя-отчество, номер счета и т.д.). Искусственный ключ вводится специально и используется как исскуственный атрибут именно для выполнения функции ключа. Потребность во введении искусственных ключей возникает по нескольким причинам. Первое, естественный ключ может состоять из большого числа атрибутов и работать с таким ключом очень неудобно. Второе, как показывает опыт, естественные ключи, то есть набор реальных атрибутов, действительно однозначно определяющих запись в отношении встречается очень редко. Даже такой, казалось бы, естественный ключ для идентификации человека, как номер внутреннего паспорта, не может быть естественным ключом (хотя бы по той причине, что паспорта выдаются только в 16 лет).
Вообще говоря, нигде нет ограничений на то, что ключ должен быть неизменным. Однако с точки зрения организации длительного использования информации, с точки зрения того, что данные могут храниться и использоваться в распределенной системе, использование изменяемого ключа может вызвать трудности.
Рассмотрим пример. Предположим, мы все же хотим ввести ключ в таблицу “Товары” (см. Рисунок 4.2.). Вообще говоря, товар может идентифицироваться по бар-коду, который дается данному изделию производителем.
---------T----------T ----------------------T-----------------+ ¦ Товар ¦ Бар-код ¦ производитель ¦ Адрес ¦ +--------+----------+----------------------+-----------------+ ¦ рога ¦ 46131313 ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ копыта ¦ 46061235 ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ кеды ¦ 01000004 ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ джинсы ¦ 02000551 ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ L--------+----------+----------------------+------------------
Рис. 4.3. Модифицированная таблица “Товары”.
Однако, введение атрибута “Бар-код” не до конца решает задачу идентификации записи в таблице, так как один и тот же товар может поставляться несколькими фирмами. Следовательно, ключом надо будет считать пару атрибутов (Бар-код, Производитель). В простейшей системе такое решение, может быть, и будет правильным, но в реальной жизни возможны всякие нюансы типа того, что нам потребуется различать поставку оптовой партией и мелкого заказа и это будет разным видом поставляемого товара. Кроме того, не все производители пока еще используют бар-код для идентификации товара. Более того, возможны и подделки. Поэтому, скорее всего, наиболее оптимальным вариантов введения ключа в таблицу товары будет введение искусственного ключа, некоего внутреннего номера. Для единообразия будем такие ключи именовать именем “id” (идентификатор) и использовать для него целые значения (а сами конкретные значения ключа будем записывать начиная с символа “#”):
---------T----------T ----------------------T-----------------+ ¦ Товар ¦ id ¦ Производитель ¦ Адрес ¦ +--------+----------+----------------------+-----------------+ ¦ рога ¦ #105 ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ копыта ¦ #106 ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ кеды ¦ #214 ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ джинсы ¦ #157003 ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ L--------+----------+----------------------+------------------
Рис. 4.4. Таблица “Товары” с введеным искусственным ключом.
Требование наличия ключа в отношении, строго говоря, не является обязательным. Возможно, что в отношении вообще нет ключей. Это означает, что в отношении возможны дублирующие записи. Так как отношение предназначено для описания объектов или сущностей реальной предметной области, то возможность дублирования записей означает, что мы или имеем несколько идентичных записей об одном и том же объекте, или не можем различать эти объекты с помощью имеющегося набора атрибутов. И в том, и в другом случае такое отношение не представляет для нас практического интереса и в дальнейшем мы всегда будем предполагать, что для рассматриваемых отношений ключ всегда существует.
4.3. Основные операции над таблицами и их интерпретация.
Проекция - операция, заключающаяся в удалении некоторых столбцов в отношении. Среди оставшихся записей с меньшим числом атрибутов может проводиться удаление дупликатов (одинаковых записей). С математической точки зрения, проекция отношения D(d1, d2,…., dk) на набор атрибутов D1,D2,….,Dn, где n<=k есть множество записей P(p1, p2,…., pk) таких, что для каждой записи из P существует набор атрибутов {dk+1, dk+2,…., dn} такой, что запись {p1, p2,…., pk dk+1, dk+2,…., dn} принадлежит исходному отношению D. Смысл операции проекции заключается в выделении из отношения той информации, которая нам нужна. Например, проекция отношения “Товары” по атрибутам “Производитель” и “Адрес” даст нам список всех поставщиков с их адресами:
+----------------------T-----------------+ ¦ Производитель ¦ Адрес ¦ +----------------------+-----------------+ ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ +----------------------+-----------------+
Рис. 4.5. Проекция таблицы “Товары” для получения списка фирм-производителей.
Селекция - операция, заключающаяся в удалении некоторых записей в отношении на основе некоторого условия. Условие определяться как логическое выражение на значениями атрибутов. В этом логическом выражении можно использовать операции “больше”, “меньше”, “равно”, “принадлежит множеству” и т.д. Операция селекции, как и операция проекции, позволяет выделеть из отношения ту информацию, которая нам нужна. Но, в отличии от операции проекции, выбираются подходходящие записи, а не интересующие нас атрибуты. Например, селекция отношения “Товары” по условию “атрибут “Производитель” есть “АО Рога и Копыта”” позволит нам получить список всех товаров, поставляемых данной фирмой:
-----------T--------------------------T-----------------+ ¦ Товар ¦ производитель ¦ Адрес ¦ +----------+--------------------------+-----------------+ ¦ рога ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ копыта ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ кеды ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ L----------+--------------------------+------------------
Рис. 4.6. Селекция таблицы “Товары” по условию.
Объединение - операция, заключающаяся в построении нового отношения на основе двух других (все отношения должны иметь одинаковое число атрибутов). В объединение попадают все записи как первого отношения, так и второго, и никакие другие записи. При этом совсем не обязательно, чтобы объединяемые таблицы, как и результирующая таблица имели одинаковые названия атрибутов (в случае, если мы используем именованные атрибуты). Конечно, не стоит забывать о том, что результирующее объединение должно быть осмысленным.
Операция объединения позволяет собрать информацию из разных источников. Например, если мы имеем отдельную таблицу со списком фирм-производителей товаров, и отдельную таблицу со списком фирм, которым мы поставляем некоторую продукцию, то объединив эти две таблицы мы можем получить список фирм-партнеров.
Таблица “Фирмы-производители” +----------------------T-----------------+ ¦ Производитель ¦ Адрес ¦ +----------------------+-----------------+ ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ +----------------------+-----------------+
Таблица “Фирмы-потребители” +----------------------T-----------------+ ¦ Потребитель ¦ Адрес ¦ +----------------------+-----------------+ ¦ ЗАО Антилопа Гну ¦ Приморск, Остапу¦ ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ +----------------------+-----------------+
Результирующая таблица “Фирмы-партнеры” +----------------------T-----------------+ ¦ Партнер ¦ Адрес ¦ +----------------------+-----------------+ ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ ЗАО Антилопа Гну ¦ Приморск, Остапу¦ ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ +----------------------+-----------------+
Рис. 4.8. Объединение двух таблиц.
Декартово произведение - операция, заключающаяся в построении нового отношения на основе двух других путем попарной комбинации всех возможных записей из первого отношения и второго отношения. Если в первом отношении-операнде I записей и m атрибутов, а во втором - J и n соответственно, то в результирующей таблице будет I*J записей и m+n атрибутов. Декартово произведение позволяет связать разные объекты, объединить информацию, описывающую разные типы сущностей или объектов предметной области. Например, если мы имеем отдельную таблицу со списком фирм-производителей, и отдельную таблицу со списком всевозможных товаров, то декартово произведение этих двух таблиц позволит построить всевозможные пары “товар-производитель”:
Таблица “Фирмы-производители” +----------------------T-----------------+ ¦ Производитель ¦ Адрес ¦ +----------------------+-----------------+ ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ +----------------------+-----------------+
Таблица “Товары” -----------T ¦ Товар ¦ +----------+ ¦ рога ¦ ¦ кеды ¦ L----------+
Результирующая таблица “Товар-производитель” -----------T--------------------------T-----------------+ ¦ Товар ¦ производитель ¦ Адрес ¦ +----------+--------------------------+-----------------+ ¦ рога ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ кеды ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ рога ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ ¦ кеды ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ L----------+--------------------------+------------------
Рис. 4.9. Декартово произведение двух таблиц.
Вставка, удаление и модификация записей. Рассмотренные выше теоретико-множественные операции позволяют манипулировать уже имеющейся информацией, но не дают ответ на то, откуда приходит информация в отношения. В реальной жизни информация о сущностях и объектах реального мира собирается постепенно, запись за записью. И более естественно просто добавить какую-то конкретную запись в отношение, или модифицировать уже имеющуюся, нежели манипулировать со множеством записей в отношениях. Именно для этого и предназначены простые, но удобные операции вставки, модификации и удаления записей из отношения.
4.4. Нормализация.
Зачем нужна нормализация?
Представим себе ведомость на получение зарплаты. В ней содержится информация о всех сотрудниках некоего предприятия. Для каждого сотрудника имеется одна запись. В каждой записи первое поле содержит фамилию сотрудника, второе поле - сколько начислено денег, третье - сколько удержано, четвертое - сколько выдать на руки и т.д.
Если все эти данные собрать в единую таблицу, то есть описать с помощью таблицы людей, работающих на данном предприятии, и сколько каждый из них получал ежемесячно, и в каком отделе он работает и т.д., то получится таблица:
----T--------T--------T--------T--------T--------T-----T---------¬ ¦ N ¦Фамилия ¦дата ¦месяц, ¦месячная¦ дата ¦отдел¦должность¦ ¦ ¦ ¦рожден. ¦год ¦зарплата¦ приема ¦ ¦ ¦ +---+--------+--------+--------+--------+--------+-----+---------+ ¦ 1 ¦ Иванов ¦1.1.1955¦12,1994 ¦ 150000 ¦2.2.1986¦ОНТИ ¦инженер ¦ ¦ 2 ¦ Петров ¦3.4.1966¦11.1994 ¦ 280000 ¦4.9.1992¦ВОХР ¦охранник ¦ ¦ 3 ¦ Петров ¦3.4.1966¦12,1994 ¦ 350000 ¦4.9.1992¦ВОХР ¦охранник ¦ ¦ 4 ¦ Сидоров¦7.1.1968¦12,1994 ¦ 350000 ¦1.7.1989¦ВОХР ¦охранник ¦ ¦.. ¦ .... ¦ .... ¦ .... ¦ .... ¦ .... ¦.... ¦ .... ¦ L---+--------+--------+--------+--------+--------+-----+----------
Рис. 4.10. Пример ненормализованеной таблицы.
Здесь мы использовали однотабличное представление данных. Строится такая глобальная таблица достаточно просто - берется самый общий объект (сущность), для него выделяются атрибуты и все это организуется в единую таблицу. Например, в нашем примере такой базовой сущностью является описание конкретного человека.
Недостатки такой универсальной таблицы следующие:
- жесткость;
- ненадежность (потенциальная противоречивость);
- повышенный расход ресурсов;
- громоздкость (избыточность).
Под жесткостью понимается обязательная модификация самой таблицы при изменении постановки задачи. Например, если потребовалось хранить количество детей и их возраст, то потребуется модифицировать структуру таблицы,
Причиной остальных недостатков является дублирование данных, повторение той информации, которую повторять не надо.
Если предыдущий пример был несколько надуманным, то схема базы данных из следующего пример может считаться классическим примером плохо нормализованного отношения. Предположим, мы создаем базу данных о поставщиках и товарах. Пусть имеется таблица о поставках товара, для каждого товара указывается производитель в виде названия фирмы и ее адреса:
-----------T--------------------------T-----------------+ ¦ Товар ¦ производитель ¦ Адрес ¦ +----------+--------------------------+-----------------+ ¦ рога ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ копыта ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ кеды ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ джинсы ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ ¦ ...... ¦ .................... ¦ ............... ¦ L----------+--------------------------+------------------
Рис. 4.11. Таблица “Товары”.
Рассмотрим подробно недостатки такой схемы.
Избыточность - слова "АО Рога и Копыта" дублируются, то есть занимают лишнее место в системе хранения. Если размер таблицы большой, то это может привести к значительным дополнительным расходам на память и, следовательно, снизить общую производительность системы.
Потенциальная противоречивость - при попытке изменить адрес фирмы, поставляющей кеды, мы можем забыть изменить этот адрес у этой же фирмы для других изделий, получив в результате два адреса для одной и той же фирмы:
-----------T--------------------------T-----------------¬ ¦ рога ¦ АО Рога и Копыта ¦ Москва, Бутырка ¦ ¦ копыта ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ кеды ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ ...... ¦ .................... ¦ ............... ¦ L----------+--------------------------+------------------
Рис. 4.12. Последствия неполного обновления данных в ненормализованной таблице.
Этот недостаток опасен с точки зрения поддержания целостности, непротивноречивости данных в базе данных. Такое рассогласование в реальной жизни, случившееся по причине случайной ошибки программиста или оператора может служить причиной неоплаченных поставок, штрафных санкций и т.д.
Аномалии включения - в базу данных не может быть записан адрес поставщика, если он не поставляет ни одного товара. В реальной жизни это может означать, что мы не сможем принять от такого поставщика ни одного счета на предоплату, после политического решения о сотрудничестве сведения о поставщике будут отсутствовать до первой реальной поставки и т.д.
Аномалия удаления - при удалении всех товаров, поставляемых поставщиком, мы утрачиваем его адрес. В реальной жизни это нарушает логику работы приложения - в любой момент может обнаружиться, что поставщика, с которым наша фирма работает уже много лет и который закрылся на месячную реконструкцию, забудут пригласить на юбилейный банкет, не смогут принять от него запоздавшую платежку и будет крайне затруднительно вновь начать с ним сотрудничество.
В реальной жизни при решении реальных задач одной таблицей обойтись трудно. Например, при решении задачи полной автоматизации предприятия, надо хранить информацию и о стульях, выданных материально ответсвенным, и бюллетенях, и о размере зарплаты. Согласитесь, что собирать всю эту информацию в единую таблицу несколько противоестественно.
Процесс упорядочивания, структурирования представления данных называется нормализацией. Следствием нормализации будет набор таблиц с минимальным дублированием информации, достаточно гибкий и надежно работающий. Более подробно про нормализацию можно почитать в работах [kent, Ульман].
Первая нормальная форма.
Отношение находится в первой нормальной форме, если значения атрибутов (то есть домены, из которых построено данное отношение) являются простыми, неделимыми значениями. С программистской точки зрения это означает, что тип данных, приписанный домену может быть целым (integer), символьной строкой фиксированной или переменной длины , логическим (Boolean) и т.д., но не может быть массивом, списком, множеством и т.д. Требование к тому, чтобы все отношения находились в первой нормальной форме является обязательным в том смысле, что СУБД может считаться реляционной только тогда, когда она допускает существование отношений только в первой нормальной форме.
Вторая нормальная форма.
Приведение отношения ко второй нормальной форме позволяет убрать зависимость неключевых атрибутов от части ключа. Отношение имеет вторую нормальную форму, если она имеет первую нормальную форму и каждый атрибут отношения, не входящий ни в один ключ (то есть неключевой атрибут), полностью зависит от любого возможного ключа целиком, а не от его подмножества) [Мартин]. Зависимость в этом и следующих определениях означает, что существует функция, по которой зная один атрибут можно определить значение зависимого атрибута. Это может быть арифметическая функция, а может быть просто зависимость, как от ключа.
Если все ключи в отношении состоят только из одного атрибута, то отношение автоматически имеет вторую нормальную форму, так как по любому ключу всегда можно однозначно определить любой неключевой атрибут. Отношение может не находиться во второй нормальной форме только тогда, когда или вообще нет ключей, или существует составной ключ.
Рассмотрим примеры. Как мы уже договорились выше, варианты с отсутствием ключей не представляют практического интереса и рассматриваться не будут. Предположим, мы имеем таблицу “Товары” с описанием товаров и их производителей:
---------T----------------------T-----------------+ ¦ Товар ¦ производитель ¦ Адрес ¦ +--------+----------------------+-----------------+ ¦ рога ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ копыта ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ кеды ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ джинсы ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ ¦ кеды ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ | ... | ... | ... | L--------+----------------------+------------------
Рис. 4.13. Таблица “Товары”.
Один и тот же товар (товар с одним и тем же названием) может производиться несколькими фирмами, но конкретно то или иное изделие может быть идентифицировано по своему названию и по фирме-производителю. В нашем примере кеды производятся двумя разными фирмами и это будут разные товары. С другой стороны, в этой таблице мы храним и адрес фирмы производителя. Адрес фирмы производителя однозначно определяется названием фирмы. Обратное не верно, так как по одному и тому же адресу может располагаться несколько фирм. То есть, единственным ключом является пара атрибутов (Товар, Производитель). В этой таблице существует единственный неключевой атрибут - “Адрес”. Этот атрибут полностью зависит от ключевого атрибута “Производитель”, который является подмножеством ключа. Следовательно, данное отношение не находится во второй нормальной форме.
Теперь предположим, что фирма может выпускать несколько видов продукции с одним и тем же названием. Но каждый вид продукции данного производителя является интересующим нас объектом предметной области и ему соответствует одна и только одна запись (то есть мы не рассматриваем варианты разной упаковки одного и тогоже товара, сезонных скидок и т.л.). Для идентификации записей о производителе добавим в нашу таблицу атрибут “бар-код”. Каждый товар в этом случае будет идентифицироваться своим бар-кодом. Два разных производителя не могут выпускать товар с одним и тем же бар-кодом (это реальное предположение, так как в бар-код зашивается уникальный номер производителя). В результате получается следующая таблица:
---------T----------T----------------------T-----------------+ ¦ Товар ¦ Бар-код ¦ производитель ¦ Адрес ¦ +--------+----------+----------------------+-----------------+ ¦ рога ¦ 46131313 ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ копыта ¦ 46131235 ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ кеды ¦ 01130004 ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ кеды ¦ 01130006 ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ джинсы ¦ 02010551 ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ ¦ кеды ¦ 02010552 | ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ | ... | ... | ... | ... | L--------+----------+----------------------+------------------
Рис. 4.14. Таблица “Товары”.
В условиях наших предположений (то есть в нашей модели предметной области) в даной таблице есть только один ключ - это атрибут “бар-код”. Все остальные атрибуты являются неключевыми и зависят от него. Таким образом, данное отношение находится во второй нормальной форме, хотя при этом и остаются зависимости между неключевыми атрибутами (адрес по прежнему определяется фирмой-производителем).
Приведение отношения ко второй нормальной форме очень важно. Несоответсвие отношения второй нормальной форме может быть вызвано плохим анализом предметной области, как в нашем примере, когда не была предусмотрена возможность того, что один производитель может поставлять два вида товара с одинаковым названием. В нашем примере удалось привести отношение ко второй нормальной форме введением ключевого атрибута “Бар-код”. В большинстве других случаев более правильным способом приведения отношения ко второй нормальной форме будет расщепление его на два и более отношений. Атрибуты, которые зависят от части ключа должны быть выведены в отдельную таблицу:
Таблица “Товары” ---------T----------------------+ ¦ Товар ¦ производитель ¦ +--------+----------------------+ ¦ рога ¦ АО Рога и Копыта ¦ ¦ копыта ¦ АО Рога и Копыта ¦ ¦ кеды ¦ АО Рога и Копыта ¦ ¦ джинсы ¦ ТОО Добро пожаловать ¦ ¦ кеды ¦ ТОО Добро пожаловать ¦ | ... | ... | L--------+----------------------+
Таблица “Адреса_производителей” +----------------------T-----------------+ ¦ Производитель ¦ Адрес ¦ +----------------------+-----------------+ ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ +----------------------+-----------------+
Рис. 4.15. Приведение таблицы “Товары” во вторую нормальную форму.
Выделение отдельной таблицы для хранения адресов производителей (а, в более общем случае, для хранения любых атрибутов, специфичных для конкретной фирмы) позволит избежать аномалий вставки и удаления, повысить надежность системы и снизить затраты на хранение данных. А именно:
· можно хранить информацию о фирме, которая в данный момент ничего для нас не производит, но собирается начать это делать;
· удаление всех записей о товарах, производимых некоторой фирмой, не приведет к автоматической потери всей информации о данной фирме;
· при изменении адреса у фирмы это потребуется сделать только в одном месте, если бы мы не разделили отношение на два, то такое изменение потребовалось бы сделать для каждой записи о товаре. Это повышает надежность системы и повышает скорость обработки подобных запросов;
· адрес для каждой фирмы хранится в одном месте, дублирование же этой информации приводит к неоправданному расходу памяти.
Третья нормальная форма.
Третья нормальная форма исключает транзитивную зависимость. Отношение находится в третьей нормальной форме, если оно имеет вторую нормальную форму и каждый неключевой атрибут нетранзитивно зависит от от любого ключа в данном отношении [Мартин]. Другими словами, неключевые атрибуты должны зависеть только от ключей. Например, если мы идентифицируем товары по бар-коду, и имеем следующую таблицу, находящуюся во второй нормальной форме и не находящуюся в третьей:
Преимущества, которые дает приведение отношения к третьей нормальной форме аналогичны тем, что дает и приведение ко второй нормальной форме.
---------T----------T ----------------------T-----------------+ ¦ Товар ¦ Бар-код ¦ производитель ¦ Адрес ¦ +--------+----------+----------------------+-----------------+ ¦ рога ¦ 46131313 ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ копыта ¦ 46131235 ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ кеды ¦ 01130004 ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ кеды ¦ 01130006 ¦ АО Рога и Копыта ¦ Одесса, п/я 13 ¦ ¦ джинсы ¦ 02010551 ¦ ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ ¦ кеды ¦ 02010552 | ТОО Добро пожаловать ¦ Энск, 5-е авеню ¦ | ... | ... | ... | ... | L--------+----------+----------------------+------------------
Рис. 4.16. Другой вариант таблицы “Товары”.
Данное отношение не находится в третьей нормальной форме, так как адрес фирмы однозначно зависит от ее названия, а название (поле “производитель”) не являются ни ключом, ни частью ключа в данном отношении. Для того, чтобы привести данное отношение в третью нормальную форму, нужно разбить это отношение на два - убрать из данного отношения атрибут “Адрес” и завести новое отношение “Адреса фирмпроизводителей”.
Приведение отношения к третьей нормальной форме в большинстве случаев оказывается достаточным, чтобы избежать проблем, возникающих с ненормализованными отношениями. Методика нормализации будет рассмотрена ниже, здесь же рассмотрим следующие нормальные формы, используемые на практике существенно реже, чем третья, но от этого не менее интересные.
Нормальная форма Бойса-Кодда.
Отношение находится в нормальной форме Бойса-Кодда, если оно находится в третьей нормальной форме, и существует некоторый неключевый атрибут A, который зависит от набора атрибутов X, и при этом X не включает A, то X должен обязательно включать некоторый ключ. Другими словами, если в таблице есть какие-то зависимые неключевые атрибуты, то они должны обязательно зависеть от ключа.
В качестве примера отношения, которое находится в третьей нормальной форме, но при этом не находится в нормальной форме Бойса-Кодда, можно привести пример таблицы, определяющей почтовый индекс по названию города и названию улицы. При этом предполагается, что всю улица обслуживается одним почтовым отделением задающей номер почтового индекса. При этом, одно почтовое отделение может обслуживать несколько улиц. Ключом в данной таблице будет пара атрибутов (Город, Улица). С другой стороны, в данной таблице имеет место зависимость города от почтового индекса - по индексу всегда можно определить город:
+--------+----------------------+--------+ ¦ Город ¦ Улица ¦ Индекс ¦ +--------+----------------------+--------+ ¦ Москва ¦ Профсоюзная ¦ 116321 ¦ ¦ Москва ¦ Островитянова ¦ 116321 ¦ ¦ Москва ¦ Академическая ¦ 117303 ¦ ¦ Дмитров¦ Профсоюзная ¦ 157400 ¦ ¦ Клин ¦ Профсоюзная ¦ 190005 ¦ ¦ Клин ¦ Абрикосовая ¦ 190006 ¦ | ... | ... | ... | L--------+----------------------+--------+
Рис. 4.17. Таблицы “Почтовые индексы”.
Следовательно, данная таблица не находится в нормальной форме Бойса-Кодда.
Приведение таблицы к нормальной форме Бойса-Кодда позволяет устранить проблемы, которые не устраняет третья нормальная форма. Тем не менее, в нашем примере с индексами данная схема отношения приемлима для большинства приложений и, скорее всего, в данном случае, особых проблем не возникнет. В других случаях, когда отношение не находится в нормальной форме Бойса-Кодда имеет смысл проанализировать это отношение более тщательно.
Четвертая нормальная форма.
В отличии от нормальных форм, рассмотренных выше, четвертая нормальная форма определяет требования к отношению не только на уровне зависимостей между атрибутами, но и на уровне зависимостей между разными записями внутри одного отношения.
Дадим определение многозначной зависимости, используемой при определении четвертой нормальной формы. В отношении R существует многозначная зависимость между набором атрибутов X и Y (Y многозначно зависит от X), если для любых двух записей r1 и r2, таких что они совпадают на множестве атрибутов X , то есть r1[X]=r2[X], всегда существует запись r3 такая, что.
1. r3 совпадает на множестве атрибутов X с записями r1 и r2, то есть r1[X]=r2[X]=r3[X],
2. на множестве атрибутов Y запись r3 совпадает с r1, то есть r1[Y]=r3[Y],
3. на множестве атрибутов, не входящих ни в X, ни в Y , запись r3 совпадает с r2, то есть r2[R-(X+Y)]=r3[R-(X+Y)].
Если попытатьться перефразировать это определение, то можно пояснить его смысл следующим образом: Если существует запись [x, y1, z1] и запись [x, y2, z2], то должна существовать запись [x, y1, z2] и (в силу симметричности определения) запись [x, y2, z1]. Многозначные зависимости проявляются при логическом группировании некоторых атрибутов, и их симметричном вхождении в отношении. Например, рассмотрим таблицу, в которой хранится информация о семинарах, проводимых в некотором Университете. Данная таблица может иметь следующие атрибуты:
+---------------+----------+-----------+--------+--------+ ¦ Преподаватель ¦ Студент ¦ Аудитория | Время ¦ День ¦ +---------------+----------+-----------+--------+--------+ ¦ Бякин ¦ Петров ¦ 711 | 9:00 ¦ Понед ¦ ¦ Бякин ¦ Иванова ¦ 745 | 10:50 ¦ Понед ¦ | ... | ... | ... | ... | ... ¦ L---------------+----------+-----------+--------+--------+
Рис. 4.18. Таблица “Семинары”.
Если предположить, что студенты Петров и Иванова учатся в одной группе, то, следовательно, они ходят на одни и те же занятия (болезни и прогулы для простоты не рассматриваются). Следовательно, в данной таблице должны быть и следующие записи:
7+---------------+----------+-----------+--------+--------+ ¦ Преподаватель ¦ Студент ¦ Аудитория | Время ¦ День ¦ +---------------+----------+-----------+--------+--------+ ¦ Бякин ¦ Петров ¦ 711 | 9:00 ¦ Понед ¦ ¦ Бякин ¦ Иванова ¦ 745 | 10:50 ¦ Понед ¦ ¦ Бякин ¦ Петров ¦ 745 | 10:50 ¦ Понед ¦ ¦ Бякин ¦ Иванова ¦ 711 | 9:50 ¦ Понед ¦ | ... | ... | ... | ... | ... ¦ L---------------+----------+-----------+--------+--------+
Рис. 4.19. Таблица “Семинары” в случае отсутствия 4-й нормальной формы.
В этом случае атрибут “Студент” функционально зависит от атрибута “Преподаватель”.
Так вот, отношение R находится в четвертой нормальной форме, если оно находится в третьей нормальной форме, и существует набор атрибутов Y, который функционально зависит от Х, при этом Y не пусто, Y не является подмножеством и в R есть атрибуты, не входящие ни в Х, ни в Y, то Х должен содержать какой-либо ключ.
Если отношение не находится в четвертой нормальной форме, то обычно это означает, что при рассмотрении предметной области, при отображении ее в схему базы данных, были пропущены какие-то классы объектов или сущностей, которые стоило бы выделить в отдельные отношения. Например, в нашем примере с семинарами напрашивается введение отношения “Группы”, в котором будут перечислены студенты и для каждого студента будет указан номер группы. А преподаватель теперь будет проводить семинары не для студентов, а для группы.
Методика нормализации.
Нормализация схемы базы данных призвана упорядочить схему, сделать ее более надежной и удобной в работе. То есть нормализация не должна рассматриваться как самоцель. Существуют специальные методики разбиения таблиц на две таблицы с целью приведения их к нормальным формам [Мартин, Мейер]. Здесь же мы рассмотрим несколько иной подход, а именно как изначально проектировать “правильную” схему базы данных так, что потребность в нормализации была минимальной.
Первый шаг - анализ предметной области. Необходимо четко выделить объектны (сущности), которые нас интересуют, проклассифицировать их, определить для них те атрибуты, которые представляют интерес в данной задаче. Например, если мы разрабатываем систему для оптового склада, и должны вести учет поставлямых товаров, то, по всей видимости, на первом шаге для нас будет представлять интерес единственная сущности реального мира - “факт поставки товара”. В этом факте должно быть указано какой товар, когда и нам основании какого документа (контракт) поставлен. Эти сущности тоже должны быть представлены в схеме базы данных. В более общем случае, если при описании какого-либо объекта, какой-либо сущности реального мира возникает необходимость задействовать другой объект, другую сущность, то описание этих объектов (сущностей) должны быть вынесены в отдельную таблицу. Применяя это правило к нашей задаче, имеем следующий набор сущностей реального мира и их атрибуты (указаны в скобках):
· Факт поставки (товар, кто поставил, когда поставил, контракт, условия поставки)
· Товар (производитель, название)
· Контракт (кто подписал, что предусматривает, срок действия)
· Поставщик товара (название, адрес)
· Производитель товара (название, адрес)
Следующий шаг в построениии схемы базы данных должен заключаться в поиске ключей. Атрибуты, входящие в ключ, должны быть тщательно проанализированы на тот факт, что они действительно всегда однозначно будут идентифицировать реальный объект или сущность. В противном случае, имеет смысл ввести искусственный ключ. Более того, хорошим тоном может считаться обязательное введение искуственного ключа и использование его в качестве первичного для всех (или почти всех) таблиц в базе данных.
Следующий шаг - детальная спецификация атрибутов для таблиц, в том числе, определение доменов, то есть типов данных, которые будут приписаны атрибутам. В нашем случае можно предположить, что схема базы данных будет выглядеть следующим образом (стрелками показаны свяки между таблицами):
Факты_поставки ( id integer, товар integer, -----------+ поставщик integer, ---------+ | дата date, | | контракт integer) -------+ | | | | | Товары ( | | | id integer, <--------+ производитель integer, ---+ | | название character) | | | | | | Контракты ( | | | id integer, <------+ | подписал character, | | условия character, | | срок interval) | | | | Поставщики ( | | id integer, <--------+ название character, | адрес character) | | Производители ( | id integer, <----+ название character, адрес character).
После того, как схема базы данных таким образом формализована, нужно еще раз внимательно ее проанализирповать на предмет зависимостей и неточностей. Для упрощения этого анализа следует рассмотреть те действия, которые будут совершаться с информацией в базе данных. В нашем случае к таким действиям можно отнести занесение информации о контракте, занесение факта поставки, поиск фирмы, поставившей или сделавшей тот или иной товар и т.д. В частности, в нашей схеме есть один спорный момент и одна неточность.
Спорный момент в нашей схеме базы данных заключается в том, что контракт обычно содержит информацию о фирме, которая будет поставлять тот или иной товар. Поэтому, возможно, информацию об этой фирме не надо хранить в описании фактов поставок, а надо хранить в описаниях контрактов. С другой стороны, когда мы заключаем с какой-то фирмой договор о поставке, нас может не интересовать, каким образом она поставит нам этот товар. Возможно, она найдет субподрядчика и организует эту поставку через другую фирму. Если это так, или такие случаи возможны в будущем, то ссылку на поставку стоит оставить в описании фактов поставок.
Неточность в нашей схеме проявится тогда, когда мы заключим договор на поставку товара непосредственно с фирмой-производителем данного товара. В этом случае нам потребуется занести информацию о данной фирме сразу в две таблицы - производетелей и поставщикков. Более того, эти две сущности очень похожи, и являются детализацией другой сущности - “Фирма”. Поэтому стоит объединить потсавщиков и производителей в единую таблицу “Фирмы”. В результате получится схема базы данных, которая будет работоспособной:
Факты_поставки ( id integer, товар integer, -----------+ поставщик integer, ---------+ | дата date, | | контракт integer) -------+ | | | | | Товары ( | | | id integer, <--------+ производитель integer, ---+ | | название character) | | | | | | Контракты ( | | | id integer, <------+ | подписал character, | | условия character, | | срок interval) | | | | Фирмы ( | | id integer, <----+---+ название character, адрес character).
Общие правила нормализации.
Подводя итоги описания методики нормализации, можно выделить следующие правила “хорошего тона”:
1. Помни про нормальные формы.
2. Схема должна соответсвовать реальной предметной области
3. Атрибуты должны зависеть от ключа, от всего ключа целиком и ни от чего другого, кроме ключа [П.Грей]
4. Чем меньше зависимостей внутри таблицы, тем лучше.
5. Естественные ключи на поверку редко оказываются ключами.
При разработке схемы базы данных важно учитывать и мировой опыт в смежных областях, а именно, помнить про следующие правила:
1. Не надо плодить сущностей сверх меры [К.Прутков]
2. Семь раз отмерь, один раз отрежь (семь раз подумай, один раз создай таблицу).
3. Первый блин комом (первая схема редко бывает удачной).
Грачев А.Ю. Введение в СУБД Informix.
©Drkb::02453.
| Математика времени |
Работа с временными величинами в Delphi очень проста, если пользоваться встроенными функциями преобразования. Определите глобальные Hour, Minute, Second и инициализируйте их следующим образом:
| Механизм вызова удаленных процедур - RPC. |
Механизм вызова удаленных процедур - RPC.
Программы, общающиеся через сеть, нуждаются в механизме связи. На нижнем уровне по поступлении пакетов подается сигнал, обрабатываемый сетевой программой обработки сигналов. На верхнем уровне работает механизм rendezvous (рандеву), принятый в языке Ада. В NFS используется механизм вызова удаленных процедур (RPC), в котором клиент взаимодействует с сервером (см. Рисунок 1). В соответствии с этим процессом клиент сначала обращается к процедуре, посылающей запрос на сервер. По прибытии пакета с запросом сервер вызывает процедуру его вскрытия, выполняет запрашиваемую услугу, посылает ответ, и управление возвращается клиенту.
Интерфейс RPC можно представить состоящим из трех уровней:
- Верхний уровень полностью "прозрачен". Программа этого уровня может, например, содержать обращение к процедуре rnusers(), возвращающей число пользователей на удаленной машине. Вам не нужно знать об использовании механизма RPC, поскольку вы делаете обращение в программе.
- Средний уровень предназначен для наиболее общих приложений. RPC-вызовами на этом уровне занимаются подпрограммы registerrpc() и callrpc(): registerrpc() получает общесис темный код, а callrpc() исполняет вызов удаленной процедуры. Вызов rnusers() реализуется с помощью этих двух подпрограмм.
- Нижний уровень используется для более сложных задач, изменяющих умолчания на значения параметров процедур. На этом уровне вы можете явно манипулировать гнездами, используемыми для передачи RPC-сообщений.
Как правило, вам следует пользоваться верхним уровнем и избегать использования нижних уровней без особой необходимости.
Несмотря на то, что в данном руководстве мы рассматриваем интерфейс только на Си, обращение к удаленным процедурам может быть сделано из любого языка. Работа механизма RPC для организации взаимодействия между процессами на разных машинах не отличается от его работы на одной машине.
RPC (Remote Procedure Call, Сервис вызова удаленных процедур) представляет собой интерфейс между удаленными пользователями и определенными программами хоста, которые запускаются по запросам этих пользователей. Сервис RPC какого-либо хоста, как правило, предоставляет клиентам комплекс программ. Каждая из таких программ состоит, в свою очередь, из одной или нескольких удаленных процедур. Например, сервис удаленной файловой системы NFS, который построен на вызовах RPC, может состоять только из двух программ: например, одна программа взаимодействует с высокоуровневыми пользовательскими интерфейсами, а другая - с низкоуровневыми функциями ввода-вывода.
В каждом вызове удаленной процедуры участвуют две стороны: активный клиент, который отправляет запрос вызова процедуры на сервер, и сервер, который отправляет клиенту ответ.
Примечание. Следует иметь в виду, что термины "клиент" и "сервер" в данном случае относятся к определенной транзакции Конкретный хост или программное обеспечение (процесс или программа) могут работать как в роли клиента, так и в роли сервера. Например, программа, которая обеспечивает работу сервиса удаленных процедур, в то же время может быть клиентом в работе с сетевой файловой системой.
Протокол RPC построен на модели вызовов удаленных процедур, подобному механизму вызовов локальных процедур. При вызове локальной процедуры вы помещаете аргументы в определенное место памяти, в стек или переменные окружения и передаете управление процессом по определенному адресу. После завершения работы вы читаете результаты по конкретному адресу и продолжаете свой процесс.
В случае работы с удаленной процедурой, основное отличие состоит в том, что вызов удаленной функции обслуживают два процесса: клиентский процесс и серверный процесс.
Процесс клиента отправляет серверу сообщение, в которое включены параметры вызываемой процедуры и ожидает ответного сообщения с результатами ее работы. При получении ответа результат считывается, и процесс продолжает работу. Со стороны сервера процесс-обработчик вызовов находится в состоянии ожидания, и, при поступлении сообщения, считывает параметры процедуры, выполняет ее, отправляет ответ и становится в состояние ожидания следующего вызова.
RPC-протокол не накладывает каких-либо требований на дополнительные связи между процессами и не требует синхронности выполняемых функций, т. е. вызовы могут быть асинхронными и взамонезависимыми, так что клиент во время ожидания ответа может выполнять другие процедуры. Сервер RPC может выделять для каждой функции отдельный процесс или виртуальную машину, поэтому, не дожидаясь окончания работы предыдущих запросов, сразу же может принимать следующие.
Однако между вызовами локальных и удаленных процедур есть несколько важных отличий:
1. Обработка ошибок. Клиент в любом случае должен получать уведомление об ошибках, возникающих при вызовах удаленных процедур на сервере или в сети.
2. Глобальные переменные. Поскольку сервер не имеет доступа к адресному пространству клиента, при вызовах удаленных процедур нельзя использовать скрытые параметры в виде глобальных переменных.
3. Производительность. Скорость выполнения удаленных процедур, как правило на один или два порядка ниже скорости выполнения аналогичных локальных процедур.
4. Аутентификация. Поскольку вызовы удаленных процедур происходят по сети, необходимо использовать механизмы аутентификации клиента.
Принципы построения протокола.
Протокол RPC может использовать несколько различных транспортных протоколов. В обязанности RPC-протокола входит только обеспечение стандартов и интерпретация передачи сообщений. Достоверность и надежность передачи сообщений целиком обеспечивается транспортным уровнем.
Однако RPC может контролировать выбор и некоторые функции транспортного протокола. В качестве примера взаимодействия между RPC и транспортным протоколом рассмотрим процедуру назначения RPC-порта работы прикладного процесса через RPC - Portmapper.
Эта функция динамически (по запросу) назначает соединению RPC определенный порт. Функция Portmapper используется довольно часто, поскольку набор зарезервированных для RPC транспортных портов ограничен, а количество процессов, которые потенциально могут одновременно работать очень высоко. Portmapper, например, вызывается при выборе портов взаимодействия клиента и сервера системы NFS.
Сервис Portmapper использует механизм широковещательных сообщений RPC на определенный порт - III. На этот порт клиент отправляет широковещательное сообщение запроса порта определенного сервиса RPC. Сервис Portmapper обрабатывает таксе сообщение, определяет адрес локального сервиса RPC и отправляет клиенту ответ. Сервис RPC Portmapper может работать как с TCP, так и с UDP-протоколами.
RPC может работать с различными транспортными протоколами, но никогда не дублирует их функции, т. е. если RPC работает поверх TCP, все заботы о надежности и достоверности соединения RPC возлагает на TCP. Однако, если протокол RPC установлен поверх UDP, он может обеспечивать дополнительные собственные функции обеспечения гарантированной доставки сообщений.
Примечание. Прикладные задачи могут рассматривать RPC-протокол как определенную процедуру вызова функции по сети JSR (Jump Subroutine Instruction).
Для работы RPC-протокола необходимо выполнение следующих условий:
1. Уникальная идентификации всех удаленно вызываемых процедур на данном хосте. RPC-запросы содержат три поля идентификаторов - номер удаленной программы (сервиса), номер версии удаленной программы и номер удаленной процедуры указанной программы. Номер программы назначается производителем сервиса, номер процедуры указывает на конкретную функцию данного сервиса
2. Идентификация версии RPC-протокола. RPC-сообщения содержат поле версии RPC-протокола. Она используется для согласования форматов передаваемых параметров при работе клиента с различными версиями RPC.
3. Предоставление механизмов аутентификации клиента на сервере. RPC-протокол обеспечивает процедуру аутентификации клиента в сервисе, и, в случае необходимости, при каждом запросе или отправке ответа клиенту. Кроме того, RPC позволяет использовать различные дополнительные механизмы безопасности.
RPC может использовать четыре типа механизмов аутентификации:
- AUTH_NULL - без использования аутентификации
- AUTH_UNIX - аутентификация по стандарту UNIX.
- AUTH_SHORT - аутентификация по стандарту UNIX с собственной структурой кодирования
- AUTH_DES - аутентификация по стандарту DES.
4. Идентификация сообщений ответа на соответствующие запросы. Ответные сообщения RPC содержат идентификатор запроса, на основании которого они были построены. Этот идентификатор можно назвать идентификатором транзакции вызова RPC. Данный механизм особенно необходим при работе в асинхронном режиме и при выполнении последовательности из нескольких RPC-вызовов.
5. Идентификация ошибок работы протокола. Все сетевые или серверные ошибки имеют уникальные идентификаторы, по которым каждый из участников соединения может определить причину сбоя в работе.
Структуры сообщений протокола
При передаче RPC-сообщений поверх транспортного протокола, несколько RPC-сообщений могут располагаться внутри одного транспортного пакета. Для того чтобы отделять одно сообщение от другого, используется маркер записи (RM - Record Marker). Каждое RPC-сообщение "маркируется" ровно одним RM.
RPC-сообщение может состоять из нескольких фрагментов. Каждый фрагмент состоит из четырех байт заголовка и (от 0 до 2**31-1) данных. Первый бит заголовка указывает, является ли данный фрагмент последним, а остальные 31 бит указывают длину пакета данных.
Структура RPC формально описана на языке описания и представления форматов данных - XDR с дополнениями, касающимися описания процедур. Можно даже сказать, что язык описания RPC является расширением XDR, дополненным работой с процедурами.
Структура RPC-пакета выглядит следующим образом:
Code: Struct rpc_msg { Unsigned int xid; Union switch (msg_type mtype) { Case CALL: Call_body cbody; Case REPLY: Reply body rbody; } body; };
Обучающее руководство по PostgreSQL.
| Обучающее руководство по PostgreSQL. |
Обучающее руководство по PostgreSQL.
Команда разработчиков PostgreSQL.
Под редакцией
Thomas Lockhart.
Авторское право на PostgreSQL принадлежит Postgres Global Development Group.
Резюме
Postgres изначально разрабатывался в UC Berkeley Computer Science Department, цитадели многих объектно-реляционных концепций, теперь ставших доступными в некоторых коммерческих базах данных. Он обеспечивает поддержку языка SQL92/SQL3, целостность транзакций и расширяемость типов. PostgreSQL является всеобщим достоянием, потомком с открытыми исходными текстами этого оригинального кода Berkeley.
Глава 1. Введение
Оглавление
Что такое Postgres?
Краткая история Postgres.
Об этой версии
Ресурсы
Терминология
Нотация
О Y2K.
Авторские права и торговые марки
Этот документ является пользовательским руководством для систем управления базами данных PostgreSQL, изначально разработанной в калифорнийском университете Berkeley. PostgreSQL основан на Postgres версии 4.2. Проект Postgres ,возглавляемый профессором Michael Stonebraker, был субсидирован в рамках министерства обороны агентством по перспективным научным проектам (DARPA), Army Research Office (ARO), национальным научным фондом (NSF), и ESL, Inc.
Что такое Postgres?
Традиционные реляционные системы управления базами данных (DBMSs) поддерживают модель данных, состоящую из набора именованных отношений, содержащих атрибуты определенных типов. В настоящий момент, коммерческие системы включают такие возможные типы: числа с плавающей точкой, целые, строки символов, денежную единицу и даты. Обычно признаётся, что эта модель недостаточна для работы приложений с типами данных, которые появятся в будущем. Реляционная модель успешно замещает предыдущие модели, в частности, из-за её "спартанской простоты". Однако иногда, эта простота часто делает реализацию некоторых приложений очень сложной. Postgres предлагает значительную дополнительную мощность, объединяя следующие четыре дополнительные концепции с основными таким образом, что пользователи могут легко расширить систему:
классы наследование типы функции
Прочие свойства обеспечивают дополнительную мощность и гибкость:
ограничения триггеры правила целостность транзакций
Из-за этих свойств Postgres относят к категории баз данных, называемых объектно-реляционными. Обратите внимание, что они отличаются от так называемых объектно-ориентированных, которые, в общем, плохо подходят для традиционных языков реляционных баз данных. Но хотя Postgres и имеет некоторые объектно-ориентированные свойства, он остаётся в мире реляционных баз данных. Фактически, некоторые новые коммерческие базы данных включают свойства, открытые Postgres.
Краткая история Postgres.
Объектно-реляционная система управления базами данных, теперь известная как PostgreSQL (и сокращённо называемая Postgres95) , происходит от пакета Postgres , написанного в Berkeley. После десятилетия разработки, PostgreSQL это наиболее прогрессивная база данных с открытыми исходными текстами, доступная везде, предлагает многовариантное управление параллелизмом, поддерживает почти все конструкции SQL (включая вложенную выборку, транзакции, и определяемые пользователем типы и функции), и имеет широкий ряд связей с языками (включая C, C++, Java, perl, tcl, и python).
Проект Berkeley Postgres.
Реализация Postgres DBMS началась в 1986. Первоначальные концепции системы представлены в Задачи Postgres, а определение первоначальной модели данных показано в Модель данных Postgres. Проект правил системы для этого времени описывается в Проектирование системы правил Postgres. Логическое обоснование и архитектура администратора хранения описана в Система хранения Postgres.
Postgres за это время пережил несколько основных версий. Первая система "demoware" заработала в 1987 и была представлена в 1988 на ACM-SIGMOD конференции. Мы выпустили Версию 1, описываемую в Реализация Postgres, для нескольких внешних пользователей в июне 1989. В ответ на критику первого правила системы (Комментарий к системе правил Postgres), система правил была переконструирована (О правилах, процедурах, кэшировании и представлениях в системах баз данных) и Версия 2 увидела свет в июне 1990 с новой системой правил. Версия 3 появилась в 1991 и добавила поддержку для составного администратора хранения, улучшился исполнитель запросов, и была переписана система правил перезаписи. По большей части, после выпуска Postgres95 (смотри ниже) всё внимание было перенесено на портативность и надёжность.
Postgres использовался для реализации многих различных исследований и производства приложений. Среди них: система анализа финансовых данных, пакет контроля за производительностью реактивных двигателей, база данных передвижения астероидов и несколько географических информационных систем. Postgres также использовался как учебное пособие в нескольких университетах. Наконец, Illustra Information Technologies (потом слилась с Informix) подобрала код и коммерциализовала его. Позже, в 1992 году, Postgres стал первичным администратором данных для Sequoia 2000, научного вычислительного проекта.
Размер сообщества внешних пользователей в течении 1993 года практически удвоился. Становилось всё больше и больше понятно, что сопровождение прототипа кода и поддержка заберут большое количество времени, которое должно было быть посвящено исследованию баз данных. Из-за этого напряжения сократилась поддержка на накладные расходы, и проект официально прекратился с версией 4.2.
Postgres95.
В 1994 году, Andrew Yu и Jolly Chen добавили интерпретатор языка SQL в Postgres. Впоследствии, Postgres95 был запущен в паутину, найдя свой собственный путь в мир в качестве всеобщего достояния, как потомок с открытым исходным текстом, изначально бывшим Berkeley кодом Postgres .
Код Postgres95 был полностью на ANSI C и урезан в размере на 25%. Много внешних изменений улучшили производительность и обслуживаемость. Postgres95 v1.0.x запускался на 30-50% быстрее на Wisconsin Benchmark по сравнению с Postgres v4.2. Кроме исправленных багов, появились такие улучшения:
· Язык запросов Postquel был заменён на SQL (реализован в сервере). Подзапросы не поддерживались до PostgreSQL (смотри ниже), но они могли быть съимитированы в Postgres95 с помощью функций SQL, определённых пользователем. Сложные функции были реализованы заново. Также был добавлен пункт поддержки запросов GROUP BY. Для программ на C остался доступен интерфейс <>.
· В дополнении к программе мониторинга, появилась программа (psql) , которая позволяла выполнять интерактивные запросы SQL, используя GNU readline.
· Новая клиентская библиотека, libpgtcl, стала поддерживать клиентов основанных на Tcl. Пример на shell, pgtclsh, обеспечивал новые Tcl команды для связи tcl программ с Postgres95 сервером.
· Взаимодействие с большими объектами было основательно перестроено. От перестановки больших объектов остался только механизм хранения больших объектов. (Перестановочная файловая система была удалена.)
· Объектно-уровневое системное правило было удалено. Правила еще доступны как правила перезаписи.
· Вместе с исходным кодом стало распространяться краткое обучающее руководство по официальным возможностям SQL, работающим в Postgres95.
· Для сборки стал использоваться GNU make (вместо BSD make). Также, Postgres95 может быть скомпилирован с помощью непропатченного gcc (выравнивание данных типа double было исправлено).
PostgreSQL.
В 1996 году, стало ясно, что название “Postgres95” не выдержало испытания временем. Мы выбрали новое имя, PostgreSQL, отражающее взаимосвязь между первоначальным Postgres и возможностями SQL в более новых версиях. В тоже время, мы установили нумерацию версий, начиная с 6.0, вернув нумерацию обратно к прежней последовательности изначально начатой проектом Postgres.
При разработке Postgres95 акцент делался на установление и понимание существующих проблем в коде сервера. В PostgreSQL акцент был сдвинут на прибавление свойств и возможностей, хотя работа продолжалась во всех областях.
Основные улучшения в PostgreSQL включают:
· Блокировка на уровне таблиц была заменена на многовариантное управление параллелизмом, который позволяет читающему продолжать чтение согласованных данных во время деятельности пишущего и разрешает горячее резервирование из pg_dump, и то же время база данных остаётся доступной для запросов.
· Были реализованы важные свойства сервера, включая вложенную выборку, значения по умолчанию, ограничители, и триггеры.
· Были добавлены дополнительные свойства языка SQL92, включая первичные ключи, объявление идентификаторов, преобразование литерального строкового типа, приведение типа, и ввод двоичных и шестнадцатеричных целых.
· Были улучшены встроенные типы, включая новые широкомасштабные типы даты/время и поддержка дополнительных геометрических типов.
· Скорость всего кода сервера была увеличена приблизительно на 20-40%, и время запуска сервера было уменьшено на 80%, начиная с выпуска v6.0.
Терминология
В последующем тексте, термин сайтозначает хост машину, на которой установлен Postgres. Т.к. возможно установить более одной базы данных Postgres на один хост, то этот термин более точно указывает на любой отдельный набор установленных исполняемых файлов и баз данных Postgres.
Суперпользователь Postgres - это имя пользователя postgres, которому принадлежат исполняемые и файлы баз данных Postgres. Для суперпользователя, все механизмы защиты пропускаются и доступны любые произвольные данные.К тому же, суперпользователю Postgres позволено запускать некоторые программы поддержки, которые, в основном, недоступны для всех пользователей. Заметим, что суперпользователь Postgres - это не суперпользователь Unix (на который будем ссылаться как на root). Суперпользователь должен иметь не нулевой идентификатор пользователя (UID) по причинам безопасности.
Администратор базы данных или DBA - это человек, который отвечает за установку механизмов Postgres в соответствии с политикой безопасности сайта. DBA может добавлять новых пользователей по методике, описанной ниже и поддерживать набор шаблонов баз данных для использования с createdb.
Postmaster - это процесс, который работает как расчётная палата для запросов к системе Postgres. Клиентские приложения подключаются к postmaster, который отслеживает любые системные ошибки и взаимодействие с процессами сервера. postmaster может принимать некоторые аргументы из командной строки для настройки своего поведения. Однако, указывать аргументы необходимо только если ты намереваешься запускаться на нескольких сайтах или не на сайте по умолчанию.
Сервер Postgres (т.е. исполняемая программа postgres) может быть запущена прямо из пользовательского shell суперпользователем Postgres (с именем базы данных в качестве аргумента). Однако, из-за этого не принимается во внимание разделяемый буферный пул и блокировка таблиц, связанных с postmaster/сайтом, поэтому это не рекомендуется на многопользовательском cайте.
Нотация
“...” или /usr/local/pgsql/ в начале имени файла используются для представления пути к домашнему каталогу суперпользователя Postgres.
В командном синтаксисе, скобки (“[” и “]”) показывают, что выражение или ключевое слово необязательны. Всё в фигурных скобках (“{” и “}”) и содержащие вертикальные штрихи (“|”) показывают, что ты можешь выбрать из них что-то одно.
В примерах, круглые скобки (“(” и “)”) используются для группировки логических выражений. “|” - это логический оператор OR.
В примерах показано выполнение команд из различных бюджетов и программ. Команды, выполняемые из бюджета root предваряются “>”. Команды, выполняемые из бюджета суперпользователя Postgres предваряются “%”, в то время как команды выполняемые из бюджета непревелигерованных пользователей предваряются “$”. Команды SQL предваряются “=>” или не имеют приглашения, в зависимости от смысла.
Глава 2. SQL.
Оглавление
Реляционная модель данных
Формальное описание реляционной модели данных
Операции в реляционной модели данных
Язык SQL.
Эта глава изначально появилась как часть диссертации Stefan Simkovicss (Simkovics, 1998).
SQL стал наиболее популярным реляционным языком запросов. Название “SQL” это абривиатура Язык структурированных запросов. В 1974 году Donald Chamberlin и другие в IBM Research разработали язык SEQUEL (Язык английских структурированных запросов). Этот язык был впервые реализован в прототипе IBM названном SEQUEL-XRM в 1974-75 годах. В 1976-77 годах зародилась пересмотренная версия SEQUEL называемая SEQUEL/2 и впоследствии название было изменено на SQL.
В 1977 году был разработан новый прототип, названный System R. System R реализовывал большое подмножество SEQUEL/2 (сейчас SQL) и в течении проекта SQL было сделано много изменений. System R была установлена на многих пользовательских сайтах, как на внутренних сайтах IBM так и на некоторых выбранных клиентских сайтах. Благодаря успеху и приёму System R на этих пользовательских сайтах IBM начала разрабатывать коммерческие продукты, которые реализовывали язык SQL, основанный на технологии System R.
Через несколько лет IBM и еще несколько других продавцов анонсировали такие SQL продукты как SQL/DS(IBM), DB2 (IBM), ORACLE (Oracle Corp.), DG/SQL (Data General Corp.), и SYBASE (Sybase Inc.).
SQL стал, также, официальным стандартом. В 1982 году Американский национальный институт стандартов (ANSI) заказал своему комитету по базам данных X3H2 разработать план по стандартизации реляционного языка. Этот план был утверждён в 1986 году и состоял преимущественно из IBM-кого диалекта SQL. В 1987 году этот ANSI стандарт также был принят в качестве международного стандарта международной организацией по стандартизации (ISO). Эту версия первоначального стандарта SQL часто называют неформально как "SQL/86". В 1989 году первоначальный стандарт был расширен и этот новый стандарт часто, опять же неформально, стали называть как "SQL/89". Также в 1989 году, был разработан родственный стандарт, называемый Встроенный язык баз данных SQL (ESQL).
Комитеты ISO и ANSI много лет работали над определением значительно дополненной версии изначального стандарта, неформально называемого SQL2 или SQL/92. Эта версия стала утверждённым стандартом - "Международный стандарт ISO/IEC 9075:1992, языка баз данных SQL" - в конце 1992 года. SQL/92 - это версия обычно используется людьми, хотя они подразумевают " стандарт SQL". Подробное описание SQL/92 дано Дейтом и Дарвеном в 1997 году. За время написания этого документа стал разрабатываться новый стандарт, неформально называемый как SQL3. Планируется сделать SQL полным языком по Тьюрингу, т.е. сделать возможными все вычислимые запросы (например рекурсивные запросы). Это очень сложная задача и поэтому завершения нового стандарта не стоит ждать ранее 1999 года.
Реляционная модель данных
Как упоминалось выше, SQL это реляционный язык. Это значит, что он основывается на реляционной модели данных, впервые опубликованной E.F. Codd в 1970 году. Мы дадим формальное описание реляционной модели позже (в Формальное описание реляционной модели данных), но во-первых, мы хотели бы взглянуть на неё с интуитивно понятной стороны.
Реляционная база данных это база данных, которая воспринимается пользователями в виде набора таблиц (и ничего больше кроме таблиц). Таблица состоит из строк и столбцов, где каждая строка означает запись и каждый столбец означает атрибут записи, содержащейся в таблице. В База данных поставщиков и деталей показан пример базы данных, состоящей из трёх таблиц:
· SUPPLIER это таблица, в которой хранится номер (SNO), название (SNAME) и город (CITY) поставщика.
· PART это таблица, в которой хранится номер (PNO), название (PNAME) и цена (PRICE) детали.
· В SELLS хранится информация о том какую деталь (PNO) продаёт поставщик (SNO). Она служит в буквальном смысле для объединения двух других таблиц вместе.
Пример 2-1. База данных поставщиков и деталей
SUPPLIER SNO | SNAME | CITY SELLS SNO | PNO.
-----+---------+-------- -----+-----
1 | Smith | London 1 | 1.
2 | Jones | Paris 1 | 2.
3 | Adams | Vienna 2 | 4.
4 | Blake | Rome 3 | 1.
3 | 3.
4 | 2.
PART PNO | PNAME | PRICE 4 | 3.
-----+---------+--------- 4 | 4.
1 | Screw | 10.
2 | Nut | 8.
3 | Bolt | 15.
4 | Cam | 25.
Таблицы PART и SUPPLIER можно рассматривать как объекты, а SELLS как связь между отдельной деталью и отдельным поставщиком.
Как мы увидим позднее, SQL оперирует таблицами подобно тем, что определены, но перед этим мы изучим теорию реляционной модели.
Формальное описание реляционной модели данных
Математическая концепция, лежащая в основе реляционной модели - это теоретико-множественное отношение, которое является подмножеством декартова произведения набора доменов. Это теоретико-множественное отношение и дало имя этой модели (не путайте с взаимоотношением из Entity-Relationship model). Формально, домен - это просто набор значений. Например, набор целых чисел - это домен. Также, набор символьных строк длинной 20 и дробные числа являются доменами.
Декартово произведение доменов D1, D2, ... Dk записывается как D1 ? D2 ? ... ? Dk - это множество всех k-кортежей v1, v2, ... vk, таких что v1 ? D1, v1 ? D1, ... vk ? Dk.
Например, когда мы имеем k=2, D1={0,1} и D2={a,b,c} то D1 ? D2 is {(0,a),(0,b),(0,c),(1,a),(1,b),(1,c)}.
Отношение - это любое подмножество декартова произведения одного или более доменов: R ? D1 ? D2 ? ... ? Dk.
Например, {(0,a),(0,b),(1,a)} - это отношение; фактически, это подмножество D1 ? D2, упомянутого выше.
Члены отношения называются кортежами. Каждое отношение некоторого декартова произведения D1 ? D2 ? ... ? Dk, говорят, имеет степень k и поэтому это множество k-кортежное.
Отношение можно рассматривать как таблицу (мы это уже делали, вспомни Базу данных поставщиков и деталей, где каждый кортеж представлен строкой и каждая колонка соответствует одному элементу кортежа. Заданные названия (называемые атрибутами) колонок приводят к определению реляционной схемы.
Реляционная схема R - это ограниченное множество атрибутов A1, A2, ... Ak. Существует домен Di для каждого атрибута Ai, 1 <= i <= <TTCLASS="LITERAL"k, откуда берутся значения атрибутов. Мы часто записываем реляционную схему в виде R(A1, A2, ... Ak).
Замечание: Реляционная схема это только шаблон, тогда как отношение - это экземпляр реляционной схемы. Отношение состоит из кортежей (и поэтому может отображаться в виде таблицы); в отличие от реляционной схемы.
Домены и типы данных
В последнем разделе мы часто упоминали о доменах. Вспомним, что домены, формально, просто набор значений (например, набор целых или дробных чисел). В терминах систем баз данных мы часто говорим о типах данных вместо доменов. Когда мы определяем таблицу, мы решаем какие атрибуты включать. Также, мы решаем, какие данные будут храниться как значения атрибутов. Например, значениями SNAME из таблицы SUPPLIER будут символьные строки, тогда как SNO будет содержать целые числа. Мы определили это, назначив тип данных каждому атрибуту. Типом SNAME является VARCHAR(20) (это SQL тип для символьных строк длиной <= 20), типом SNO является INTEGER. Назначая тип данных, мы также выбираем домен для атрибута. Доменом SNAME является множество всех символьных строк длиной <= 20, доменом SNO является множество всех целых значений.
Операции в реляционной модели данных
В предыдущем разделе (Формальное описание реляционной модели данных), мы обозначили математическое представление о реляционной модели. Теперь мы знаем, как можно хранить данные с помощью реляционной модели данных, но мы не знаем что делать с всеми этими таблицами, чтобы получить от базы данных что-нибудь ещё. Например, кто-то хочет узнать имена всех поставщиков, которые продают деталь 'Screw'. Можно определить два различных типа записи отражающих операции над отношениями:
· Реляционная алгебра т.е. алгебраическое изображение, в котором запросы выражаются с помощью специальных операторов отношений.
· Реляционное исчисление т.е. логическое изображение, в котором запросы выражаются с помощью формулирования некоторых логических ограничений, которым должны удовлетворять кортежи.
Реляционная алгебра
Реляционная алгебра была представлена E. F. Codd в 1972 году. Она состоит из множества операций над отношениями:
· ВЫБОРКА(SELECT) (?): извлечь кортежи из отношения, которые удовлетворяют заданным условиям. Пусть R - таблица, содержащая атрибут A. ?A=a(R) = {t ? R ∣ t(A) = a} где t обозначает кортеж R и t(A) обозначает значение атрибута A кортежа t.
· ПРОЕКЦИЯ(PROJECT) (?): извлечь заданные атрибуты (колонки) из отношения. Пусть R отношение, содержащее атрибут X. ?X(R) = {t(X) ∣ t ? R}, где t(X) обозначает значение атрибута X кортежа t.
· ПРОИЗВЕДЕНИЕ(PRODUCT) (?): построить декартово произведение двух отношений. Пусть R - таблица, со степенью k1 и пусть S таблица со степенью k2. R ? S - это множество всех k1 + k2 - кортежей, где первыми являются k1 элементы кортежа R и где последними являются k2 элементы кортежа S.
· ОБЪЕДИНЕНИЕ(UNION) (?): построить теоретико-множественное объединение двух таблиц. Даны таблицы R и S (обе должны иметь одинаковую степень),объединение R ? S - это множество кортежей, принадлежащих R или S или обоим.
· ПЕРЕСЕЧЕНИЕ(INTERSECT) (?): построить теоретико-множественное пересечение двух таблиц. Даны таблицы R и S, R ? S - это множество кортежей, принадлежащих R и S. Опять необходимо, чтобы R и S имели одинаковую степень.
· ВЫЧИТАНИЕ(DIFFERENCE) (? или ∖): построить множество различий двух таблиц. Пусть R и S опять две таблицы с одинаковой степенью. R - S - это множество кортежей R,не принадлежащих S.
· СОЕДИНЕНИЕ(JOIN) (?): соединить две таблицы по их общим атрибутам. Пусть R будет таблицей с атрибутами A,B и C и пусть S будет таблицей с атрибутами C,D и E. Есть один атрибут, общий для обоих отношений,атрибут C. R ? S = ?R.A,R.B,R.C,S.D,S.E(?R.C=S.C(R ? S)). Что же здесь происходит? Во-первых, вычисляется декартово произведение R ? S. Затем, выбираются те кортежи, чьи значения общего атрибута C эквивалентны (?R.C = S.C). Теперь мы имеем таблицу, которая содержит атрибут C дважды и мы исправим это, выбросив повторяющуюся колонку.
Пример 2-2. Внутреннее соединение
Давайте посмотрим на таблицы, которые получаются в результате шагов, необходимых для объединения. Пусть даны следующие две таблицы:
R A | B | C S C | D | E.
---+---+--- ---+---+---
1 | 2 | 3 3 | a | b.
4 | 5 | 6 6 | c | d.
7 | 8 | 9.
Во-первых, мы вычислим декартово произведение R ? S и получим:
R x S A | B | R.C | S.C | D | E.
---+---+-----+-----+---+---
1 | 2 | 3 | 3 | a | b.
1 | 2 | 3 | 6 | c | d.
4 | 5 | 6 | 3 | a | b.
4 | 5 | 6 | 6 | c | d.
7 | 8 | 9 | 3 | a | b.
7 | 8 | 9 | 6 | c | d.
После выборки ?R.C=S.C(R ? S)получим:
A | B | R.C | S.C | D | E.
---+---+-----+-----+---+---
1 | 2 | 3 | 3 | a | b.
4 | 5 | 6 | 6 | c | d.
Удалить повторяющуюся колонку S.C можно с помощью проекции следующей операцией: ?R.A,R.B,R.C,S.D,S.E(?R.C=S.C(R ? S))и получим:
A | B | C | D | E.
---+---+---+---+---
1 | 2 | 3 | a | b.
4 | 5 | 6 | c | d.
· ДЕЛЕНИЕ(DIVIDE) (?): Пусть R будет таблицей с атрибутами A, B, C, и D и пусть S будет таблицей с атрибутами C и D. Мы можем определить деление как: R ? S = {t ∣ ? ts ? S ? tr ? R так, что tr(A,B)=t?tr(C,D)=ts} где tr(x,y)означает кортеж таблицы R, который состоит только из элементов x и y. Заметим, что кортеж t состоит только из элементов A и B отношения R.
Зададим следующие таблицы
R A | B | C | D S C | D.
---+---+---+--- ---+---
A | b | c | d c | d.
A | b | e | f e | f.
B | c | e | f.
E | d | c | d.
E | d | e | f.
A | b | d | e.
R ? S получается
A | B.
---+---
A | b.
E | d.
Более подробное описание и определение реляционной алгебры смотри у [Ullman, 1988 год] или [Дейта, 1994 год].
Пример 2-3. Запрос с использованием реляционной алгебры
Вспомним, что мы формулируем все эти реляционные операторы для того чтобы получить данные из базы данных. Давайте вернёмся к нашему примеру из предыдущего раздела (Операции в реляционной модели данных), где кто-то захотел узнать имена всех поставщиков, продающих деталь Screw. На этот вопрос можно ответить, используя следующие операции реляционной алгебры:
?SUPPLIER.SNAME(?PART.PNAME='Screw'(SUPPLIER ? SELLS ? PART)).
Мы назовём такую операцию запросом. Если мы применим, приведённый выше запрос к таблицам нашего примера (База данных поставщиков и деталей), то получим следующий результат:
SNAME.
-------
Smith.
Adams.
Реляционное исчисление
Реляционное исчисление основано на логике первого порядка. Если два варианта реляционного исчисления:
· The Исчисление доменов (DRC), где переменными являются элементы (атрибуты) кортежа.
· The исчисление кортежей (TRC), где переменными являются кортежи.
Мы хотим обсудить исчисление кортежей потомучто оно лежит в основе большинства реляционных языков. Подробное обсуждение DRC (и также TRC) смотри у [Дейта, 1994 год] или [Ullman, 1988 год].
Исчисление кортежей
Запросы, использующие TRC, представлены в следующем виде: x(A) ∣ F(x) где x - это переменная кортежа, A - это множество атрибутов и F - формула. Результирующие отношение состоит из всех кортежей t(A), которые удовлетворяют F(t).
Если мы хотим ответить на вопрос из примера Запрос с использованием реляционной алгебры, с помощью TRC, то мы сформулируем следующий запрос:
{x(SNAME) ∣ x ? SUPPLIER ? \nonumber.
? y ? SELLS ? z ? PART (y(SNO)=x(SNO) ? \nonumber.
Z(PNO)=y(PNO) ? \nonumber.
Z(PNAME)='Screw')} \nonumber.
Вычисление запроса над таблицами из Базы данных поставщиков и товаров опять приведёт к тому же результату что и в Запрос с использованием реляционной алгебры.
Реляционная алгебра и реляционное исчисление
Реляционная алгебра и реляционное исчисление имеют одинаковую выражающую мощность; т.е. все запросы, которые можно сформулировать с помощью реляционной алгебры, могут быть также сформулированы с помощью реляционного исчисления и наоборот. Первым это доказал E. F. Codd в 1972 году. Это доказательство основано на алгоритме (“алгоритм редукции Кодда”) по которому произвольное выражение реляционного исчисления может быть сокращено до семантически эквивалентного выражения реляционной алгебры. Более подробное обсуждение смотри у [Дейта, 1994 год] и [Ullman, 1988 год].
Иногда говорят, что языки, основанные на реляционном исчислении "высокоуровневые" или "более описательные", чем языки, основанные на реляционной алгебре, потому что алгебра (частично) задаёт порядок операций, тогда как исчисление оставляет компилятору или интерпретатору определять наиболее эффективный порядок вычисления.
Язык SQL.
Как и большинство современных реляционных языков, SQL основан на исчислении кортежей. В результате, каждый запрос, сформулированный с помощью исчисления кортежей (или иначе говоря, реляционной алгебры), может быть также сформулирован с помощью SQL. Однако, он имеет способности, лежащие за пределами реляционной алгебры или исчисления. Вот список некоторых дополнительных свойств, предоставленных SQL, которые не являются частью реляционной алгебры или исчисления:
· Команды вставки, удаления или изменения данных.
· Арифметические возможности: в SQL возможно вызвать арифметические операции, так же как и сравнения, например A < B + 3. Заметим, что + или других арифметических операторов нет ни в реляционной алгебре ни в реляционном исчислении.
· Команды присвоения и печати: возможно напечатать отношение, созданное запросом и присвоить вычисленному отношению имя отношения.
· Итоговые функции: такие операции как average, sum, max, и т.д. могут применяться к столбцам отношения для получения единичной величины.
Выборка
Наиболее часто используемая команда SQL - это оператор SELECT, используемый для получения данных. Синтаксис:
SELECT [ALL|DISTINCT].
{ * | expr_1.
[AS c_alias_1] [, ...
[, expr_k [AS c_alias_k]]]}.
FROM table_name_1.
[t_alias_1].
[, ... [, table_name_n.
[t_alias_n]]].
[WHERE condition].
[GROUP BY name_of_attr_i.
[,... [, name_of_attr_j.
]] [HAVING condition]].
[{UNION [ALL] | INTERSECT | EXCEPT} SELECT ...].
[ORDER BY name_of_attr_i.
[ASC|DESC] [, ... [, name_of_attr_j [ASC|DESC]]]];
Сейчас на различных примерах, мы покажем сложные выражения оператора SELECT. Таблицы, используемые в примерах, определены в Базе данных поставщиков и деталей.
Простые выборки
Вот несколько простых примеров использования оператора SELECT:
Пример 2-4. Простой ограничивающий запрос
Получить все кортежи из таблицы PART, где атрибут PRICE больше 10:
SELECT * FROM PART.
WHERE PRICE > 10;
Получаемая таблица:
PNO | PNAME | PRICE.
-----+---------+--------
3 | Bolt | 15.
4 | Cam | 25.
Использовав "*" в операторе SELECT, получаем все атрибуты из таблицы. Если мы хотим получить только атрибуты PNAME и PRICE из таблицы PART, то используем следующее выражение:
SELECT PNAME, PRICE.
FROM PART.
WHERE PRICE > 10;
В этом случае получим:
PNAME | PRICE.
--------+--------
Bolt | 15.
Cam | 25.
Заметим, что SQL SELECT соответствует "проекции" в реляционной алгебре, а не "выборке" (подробней смотри Реляционная алгебра).
Ограничения в операторе WHERE могут также быть логически соединены с помощью ключевых слов OR, AND, и NOT:
SELECT PNAME, PRICE.
FROM PART.
WHERE PNAME = 'Bolt' AND.
(PRICE = 0 OR PRICE < 15);
приведёт к результату:
PNAME | PRICE.
--------+--------
Bolt | 15.
Арифметические операции могут использоваться в списке объектов и операторе WHERE. Например, если нам надо знать сколько будут стоить две штуки одной детали, то используем следующий запрос:
SELECT PNAME, PRICE * 2 AS DOUBLE.
FROM PART.
WHERE PRICE * 2 < 50;
и мы получим:
PNAME | DOUBLE.
--------+---------
Screw | 20.
Nut | 16.
Bolt | 30.
Заметим, что слово DOUBLE после ключевого слова AS - это новый заголовок второго столбца. Эта техника может быть использована для любого элемента списка объектов, для того чтобы задать новый заголовок столбцу результата. Этот новый заголовок часто называют псевдонимом. Псевдонимы не могут просто использоваться в запросе.
Соединения
Следующий пример показывает, как осуществлять соединения в SQL.
Для объединения трёх таблиц SUPPLIER, PART и SELLS по их общим атрибутам, мы формулируем следующее выражение:
SELECT S.SNAME, P.PNAME.
FROM SUPPLIER S, PART P, SELLS SE.
WHERE S.SNO = SE.SNO AND.
P.PNO = SE.PNO;
и получаем следующую таблицу в качестве результата:
SNAME | PNAME.
-------+-------
Smith | Screw.
Smith | Nut.
Jones | Cam.
Adams | Screw.
Adams | Bolt.
Blake | Nut.
Blake | Bolt.
Blake | Cam.
В операторе FROM мы вводим псевдоним имени для каждого отношения, так как в отношениях есть общие названия атрибутов (SNO и PNO). Теперь мы можем различить общие имена атрибутов, просто предварив имя атрибута псевдонимом с точкой. Соединение вычисляется тем же путём, как показано во внутреннем соединением. Во-первых, определяется декартово произведение SUPPLIER ? PART ? SELLS. Потом выбираются только те кортежи, которые удовлетворяют условиям, заданным в операторе WHERE (т.е. где общие именованные атрибуты равны).Наконец, убираются все колонки кроме S.SNAME и P.PNAME.
Итоговые операторы
SQL снабжён итоговыми операторами (например AVG, COUNT, SUM, MIN, MAX), которые принимают название атрибута в качестве аргумента. Значение итогового оператора высчитывается из всех значений заданного атрибута(столбца) всей таблицы. Если в запросе указана группа, то вычисления выполняются только над значениями группы (смотри следующий раздел).
Пример 2-5. Итоги
Если мы хотим узнать среднюю стоимость всех деталей в таблице PART, то используем следующий запрос:
SELECT AVG(PRICE) AS AVG_PRICE.
FROM PART;
Результат:
AVG_PRICE.
-----------
14.5.
Если мы хотим узнать количество деталей, хранящихся в таблице PART, то используем выражение:
SELECT COUNT(PNO).
FROM PART;
и получим:
COUNT.
-------
4.
Итоги по группам
SQL позволяет разбить кортежи таблицы на группы. После этого итоговые операторы, описанные выше, могут применяться к группам (т.е. значение итогового оператора вычисляется не из всех значений указанного столбца, а над всеми значениями группы. Таким образом, итоговый оператор вычисляет индивидуально для каждой группы.).
Разбиение кортежей на группы выполняется с помощью ключевых слов GROUP BY и следующим за ними списком атрибутов, которые определяют группы.Если мы имеем GROUP BY A1, ⃛, Ak мы разделяем отношение на группы так, что два кортежа будут в одной группе, если у них соответствуют все атрибуты A1, ⃛, Ak.
Пример 2-6. Итоги
Если мы хотим узнать сколько деталей продаёт каждый поставщик, то мы так сформулируем запрос:
SELECT S.SNO, S.SNAME, COUNT(SE.PNO).
FROM SUPPLIER S, SELLS SE.
WHERE S.SNO = SE.SNO.
GROUP BY S.SNO, S.SNAME;
и получим:
SNO | SNAME | COUNT.
-----+-------+-------
1 | Smith | 2.
2 | Jones | 1.
3 | Adams | 2.
4 | Blake | 3.
Теперь давайте посмотрим что здесь происходит. Во-первых, соединяются таблицы SUPPLIER и SELLS:
S.SNO | S.SNAME | SE.PNO.
-------+---------+--------
1 | Smith | 1.
1 | Smith | 2.
2 | Jones | 4.
3 | Adams | 1.
3 | Adams | 3.
4 | Blake | 2.
4 | Blake | 3.
4 | Blake | 4.
Затем, мы разбиваем кортежи на группы, помещая все кортежи вместе, у которых соответствуют оба атрибута S.SNO и S.SNAME:
S.SNO | S.SNAME | SE.PNO.
-------+---------+--------
1 | Smith | 1.
| 2.
--------------------------
2 | Jones | 4.
--------------------------
3 | Adams | 1.
| 3.
--------------------------
4 | Blake | 2.
| 3.
| 4.
В нашем примере мы получили четыре группы и теперь мы можем применить итоговый оператор COUNT для каждой группы для получения итогового результата запроса, данного выше.
Заметим, что для получения результата запроса, использующего GROUP BY и итоговых операторов, атрибуты сгруппированных значений должны также быть в списке объектов. Все остальные атрибуты, которых нет в выражении GROUP BY, могут быть выбраны при использовании итоговых функций. С другой стороны ты можешь не использовать итоговые функции на атрибутах, имеющихся в выражении GROUP BY.
Having.
Оператор HAVING выполняет ту же работу что и оператор WHERE, но принимает к рассмотрению только те группы, которые удовлетворяют определению оператора HAVING. Выражения в операторе HAVING должны вызывать итоговые функции. Каждое выражение, использующее только простые атрибуты, принадлежат оператору WHERE. С другой стороны каждое выражение вызывающее итоговую функцию должно помещаться в оператор HAVING.
Пример 2-7. Having.
Если нас интересуют поставщики, продающие более одной детали, используем запрос:
SELECT S.SNO, S.SNAME, COUNT(SE.PNO).
FROM SUPPLIER S, SELLS SE.
WHERE S.SNO = SE.SNO.
GROUP BY S.SNO, S.SNAME.
HAVING COUNT(SE.PNO) > 1;
и получим:
SNO | SNAME | COUNT.
-----+-------+-------
1 | Smith | 2.
3 | Adams | 2.
4 | Blake | 3.
Подзапросы
В операторах WHERE и HAVING используются подзапросы (вложенные выборки), которые разрешены в любом месте, где ожидается значение. В этом случае значение должно быть получено предварительно подсчитав подзапрос. Использование подзапросов увеличивает выражающую мощность SQL.
Пример 2-8. Вложенная выборка
Если мы хотим узнать все детали, имеющие цену больше чем деталь 'Screw', то используем запрос:
SELECT *
FROM PART.
WHERE PRICE > (SELECT PRICE FROM PART.
WHERE PNAME='Screw');
Результат:
PNO | PNAME | PRICE.
-----+---------+--------
3 | Bolt | 15.
4 | Cam | 25.
Если мы посмотрим на запрос выше, то увидим ключевое слово SELECT два раза. Первый начинает запрос - мы будем называть его внешним запросом SELECT - и второй в операторе WHERE, который начинает вложенный запрос - мы будем называть его внутренним запросом SELECT. Для каждого кортежа внешнего SELECT внутренний SELECT необходимо вычислить. После каждого вычисления мы узнаём цену кортежа с названием 'Screw' и мы можем проверить выше ли цена из текущего кортежа.
Если мы хотим узнать поставщиков, которые ничего не продают (например, чтобы удалить этих поставщиков из базы данных) используем:
SELECT *
FROM SUPPLIER S.
WHERE NOT EXISTS.
(SELECT * FROM SELLS SE.
WHERE SE.SNO = S.SNO);
В нашем примере результат будет пустым, потому что каждый поставщик продаёт хотя бы одну деталь. Заметим, что мы использовали S.SNO из внешнего SELECT внутри оператора WHERE в внутреннем SELECT. Как описывалось выше подзапрос вычисляется для каждого кортежа из внешнего запроса т.е. значение для S.SNO всегда берётся из текущего кортежа внешнего SELECT.
Объединение, пересечение, исключение
Эти операции вычисляют объединение, пересечение и теоретико-множественное вычитание кортежей из двух подзапросов.
Пример 2-9. Объединение, пересечение, исключение
Следующий запрос - пример для UNION(объединение):
SELECT S.SNO, S.SNAME, S.CITY.
FROM SUPPLIER S.
WHERE S.SNAME = 'Jones'
UNION.
SELECT S.SNO, S.SNAME, S.CITY.
FROM SUPPLIER S.
WHERE S.SNAME = 'Adams';
даёт результат:
SNO | SNAME | CITY.
-----+-------+--------
2 | Jones | Paris.
3 | Adams | Vienna.
Вот пример для INTERSECT(пересечение):
SELECT S.SNO, S.SNAME, S.CITY.
FROM SUPPLIER S.
WHERE S.SNO > 1.
INTERSECT.
SELECT S.SNO, S.SNAME, S.CITY.
FROM SUPPLIER S.
WHERE S.SNO > 2;
даёт результат:
SNO | SNAME | CITY.
-----+-------+--------
2 | Jones | Paris.
Возвращаются только те кортежи, которые есть в обоих частях запроса
и имеют $SNO=2$.
Наконец, пример для EXCEPT(исключение):
SELECT S.SNO, S.SNAME, S.CITY.
FROM SUPPLIER S.
WHERE S.SNO > 1.
EXCEPT.
SELECT S.SNO, S.SNAME, S.CITY.
FROM SUPPLIER S.
WHERE S.SNO > 3;
даёт результат:
SNO | SNAME | CITY.
-----+-------+--------
2 | Jones | Paris.
3 | Adams | Vienna.
Определение данных
Существует набор команд, использующихся для определения данных, включенных в язык SQL.
Создание таблицы
Самая основная команда определения данных - это та, которая создаёт новое отношение (новую таблицу). Синтаксис команды CREATE TABLE:
CREATE TABLE table_name.
(name_of_attr_1.
Type_of_attr_1.
[, name_of_attr_2.
Type_of_attr_2.
[, ...]]);
Пример 2-10. Создание таблицы
Для создания таблиц, определённых в Базе данных поставщиков и деталей, используются следующие SQL выражения:
CREATE TABLE SUPPLIER.
(SNO INTEGER,
SNAME VARCHAR(20),
CITY VARCHAR(20));
CREATE TABLE PART.
(PNO INTEGER,
PNAME VARCHAR(20),
PRICE DECIMAL(4 , 2));
CREATE TABLE SELLS.
(SNO INTEGER,
PNO INTEGER);
Типы данных SQL.
Вот список некоторых типов данных, которые поддерживает SQL:
· INTEGER: знаковое полнословное двоичное целое (31 бит для представления данных).
· SMALLINT: знаковое полсловное двоичное целое (15 бит для представления данных).
· DECIMAL (p [,q]): знаковое упакованное десятичное число с p знаками представления данных, с возможным q знаками справа от десятичной точки. (15 ? p ? qq ? 0). Если q опущено, то предполагается что оно равно 0.
· FLOAT: знаковое двусловное число с плавающей точкой.
· CHAR(n): символьная строка с постоянной длиной n.
· VARCHAR(n): символьная строка с изменяемой длиной, максимальная длина n.
Создание индекса
Индексы используются для ускорения доступа к отношению. Если отношение R проиндексировано по атрибуту A, то мы можем получить все кортежи tимеющие t(A) = a за время приблизительно пропорциональное числу таких кортежей t, в отличие от времени, пропорциональному размеру R.
Для создания индекса в SQL используется команда CREATE INDEX. Синтаксис:
CREATE INDEX index_name.
ON table_name ( name_of_attribute );
Пример 2-11. Создание индекса
Для создания индекса с именем I по атрибуту SNAME отношения SUPPLIER используем следующее выражение:
CREATE INDEX I.
ON SUPPLIER (SNAME);
Созданный индекс обслуживается автоматически, т.е. при вставке ново кортежа в отношение SUPPLIER, индекс I будет перестроен. Заметим, что пользователь может ощутить изменения в при существовании индекса только по увеличению скорости.
Создание представлений
Представление можно рассматривать как виртуальную таблицу, т.е. таблицу, которая в базе данных не существует физически, но для пользователя она как-бы там есть. По сравнению, если мы говорим о базовой таблице, то мы имеем в виду таблицу, физически хранящую каждую строку где-то на физическом носителе.
Представления не имеют своих собственных, физически самостоятельных, различимых хранящихся данных. Вместо этого, система хранит определение представления (т.е. правила о доступе к физически хранящимся базовым таблицам в порядке претворения их в представление) где-то в системных каталогах (смотри Системные каталоги). Обсуждение различных технологий реализации представлений смотри в SIM98.
Для определения представлений в SQL используется команда CREATE VIEW. Синтаксис:
CREATE VIEW view_name.
AS select_stmt.
где select_stmt, допустимое выражение выборки, как определено в Выборка. Заметим, что select_stmt не выполняется при создании представления. Оно только сохраняется в системных каталогах и выполняется всякий раз когда делается запрос представления.
Пусть дано следующее определение представления (мы опять используем таблицы из Базы данных поставщиков и деталей):
CREATE VIEW London_Suppliers.
AS SELECT S.SNAME, P.PNAME.
FROM SUPPLIER S, PART P, SELLS SE.
WHERE S.SNO = SE.SNO AND.
P.PNO = SE.PNO AND.
S.CITY = 'London';
Теперь мы можем использовать это виртуальное отношение London_Suppliers как если бы оно было ещё одной базовой таблицей:
SELECT *
FROM London_Suppliers.
WHERE P.PNAME = 'Screw';
которое возвращает следующую таблицу:
SNAME | PNAME.
-------+-------
Smith | Screw.
Для вычисления этого результата система базы данных в начале выполняет скрытый доступ к базовым таблицам SUPPLIER, SELLS и PART. Это делается с помощью выполнения заданных запросов в определении представления к этим базовым таблицам. После, это дополнительное определедение (заданное в запросе к представлению) можно использовать для получения результирующей таблицы.
Drop Table, Drop Index, Drop View.
Для уничтожения таблицы (включая все кортежи, хранящиеся в этой таблице) используется команда DROP TABLE:
DROP TABLE table_name;
Для уничтожения таблицы SUPPLIER используется следующее выражение:
DROP TABLE SUPPLIER;
Команда DROP INDEX используется для уничтожения индекса:
DROP INDEX index_name;
Наконец, для уничтожения заданного представления используется
команда DROP VIEW:
DROP VIEW view_name;
Манипулирование данными
Insert Into.
После создания таблицы (смотри Создание таблицы), её можно заполнять кортежами с помощью команды INSERT INTO. Синтаксис:
INSERT INTO table_name (name_of_attr_1.
[, name_of_attr_2 [,...]]).
VALUES (val_attr_1.
[, val_attr_2 [, ...]]);
Чтобы вставить первый кортеж в отношение SUPPLIER (из База данных поставщиков и деталей) мы используем следующее выражение:
INSERT INTO SUPPLIER (SNO, SNAME, CITY).
VALUES (1, 'Smith', 'London');
Чтобы вставить первый кортеж в отношение SELLS используется:
INSERT INTO SELLS (SNO, PNO).
VALUES (1, 1);
Обновление
Для изменения одного или более значений атрибутов кортежей в отношении используется команда UPDATE. Синтаксис:
UPDATE table_name.
SET name_of_attr_1 = value_1.
[, ... [, name_of_attr_k = value_k]].
WHERE condition;
Чтобы изменить значение атрибута PRICE детали 'Screw' в отношении PART используется:
UPDATE PART.
SET PRICE = 15.
WHERE PNAME = 'Screw';
Новое значение атрибута PRICE кортежа, чьё имя равно 'Screw' теперь стало 15.
Удаление
Для удаления кортежа из отдельной таблицы используется команда DELETE FROM. Синтаксис:
DELETE FROM table_name.
WHERE condition;
Чтобы удалить поставщика называемого 'Smith', из таблицы SUPPLIER используем следующее выражение:
DELETE FROM SUPPLIER.
WHERE SNAME = 'Smith';
Системные каталоги
В каждой системе базы данных SQL определены системные каталоги, которые используются для хранения записей о таблицах, представлениях, индексах и т.д. К системным каталогам также можно строить запросы, как если бы они были нормальными отношениями. Например, один каталог используется для определения представлений. В этом каталоге хранятся запросы об определении представлений. Всякий раз когда делается запрос к представлению, система сначала берёт запрос определения представления из этого каталога и материализует представление перед тем, как обработать запрос пользователя (подробное описание смотри в SIM98). Более полную информацию о системных каталогах смотри у Дейта.
Встраивание SQL.
В этом разделе мы опишем в общих чертах как SQL может быть встроен в конечный язык (например в C). Есть две главных причины, по которым мы хотим пользоваться SQL из конечного языка:
· Существуют запросы, которые нельзя сформулировать на чистом SQL(т.е. рекурсивные запросы). Чтобы выполнить такие запросы, нам необходим конечный язык, обладающий большей мощностью выразительности, чем SQL.
· Просто нам необходим доступ к базе данных из другого приложения, которое написано на конечном языке (например, система бронирования билетов с графическим интерфейсом пользователя написана на C и информация об оставшихся билетах хранится в базе данных, которую можно получить с помощью встроенного SQL).
Программа, использующая встроенный SQL в конечном языке, состоит из выражений конечного языка и выражений встроенного SQL (ESQL). Каждое выражение ESQL начинается с ключевых слов EXEC SQL. Выражения ESQL преобразуются в выражения на конечном языке с помощью прекомпилятора (который обычно вставляет вызовы библиотечных процедур, которые выполняют различные команды SQL).
Если мы посмотрим на все примеры из Выборка мы поймём, что результатом запроса очень часто являются множество кортежей. Большинство конечных языков не предназначено для работы с множествами, поэтому нам нужен механизм доступа к каждому отдельному кортежу из множества кортежей, возвращаемого выражением SELECT. Этот механизм можно предоставить, определив курсор. После этого, мы можем использовать команду FETCH для получения кортежа и установления курсора на следующий кортеж.
Архитектурные концепции Postgres.
Перед тем как мы начнём, ты должен понимать основы архитектуры системы Postgres. Понимание того, как части Postgres взаимодействуют друг с другом, поможет сделать следующую главу отчасти понятней. На жаргоне баз данных, Postgres использует простую "один процесс на пользователя" модель клиент/сервер. Работающий Postgres состоит из следующих взаимодействующих процессов Unix (программ):
· Контролирующий процесс демон (postmaster),
· клиентское приложение пользователя (например, программа psql),
· одна или более серверных частей базы данных (сам процесс postgres).
Отдельный postmaster управляет заданным набором баз данных на отдельном хосте. Такой набор баз данных называется установочным или сайтом. Клиентские приложения, которые хотят получить доступ к определенной базе данных в установочном наборе делают вызовы к библиотеке. Библиотека посылает запросы пользователя по сети postmaster (Как устанавливается соединение), который запускает новый очередной серверный процесс
Рисунок 3-1. Как устанавливается соединение
 и соединяет клиентский процесс с новым сервером. С этого места, клиентский процесс и и серверная часть взаимодействуют без вмешательства postmaster. Поэтому, postmaster всегда запущен, ждет запросов, несмотря на то, что клиентский и серверный процессы приходят и уходят.
Библиотека libpq позволяет одному клиенту делать несколько подключений к серверным процессам. Однако, клиентское приложение все же является однопотоковым процессом. Многопотоковые клиент/серверные соединения в настоящий момент не поддерживаются в libpq. Смысл этой архитектуры в том, что postmaster и сервер всегда запущены на одной машине (сервере баз данных), в то время как клиентское приложение может работать где-то еще. Ты должен помнить об этом, потому что файлы, которые доступны на клиентской машине могут быть недоступны (или доступны, но под другим именем) на машине сервере баз данных.
Также, ты должен знать, что postmaster и postgres сервера запускаются с id пользователя Postgres "суперпользователь." Заметим, что суперпользователь Postgres не должен быть специальным пользователем (например, пользователем с именем "postgres"). Более того, суперпользователь Postgres определенно не должен быть суперпользователем Unix ("root")! В любом случае, все файлы относящиеся к базе данных, должны принадлежать суперпользователю Postgres.
Начнём
Оглавление
Настройка среды
Запуск интерактивного монитора (psql).
Управление базой данных
С чего начать работу с Postgres новому пользователю.
Некоторые шаги, необходимые для использования Postgres могут быть выполнены любым пользователем Postgres, а некоторые должны выполняться администратором базы данных сайта. Администратор сайта - это человек, который устанавливает программное обеспечение, создает каталоги базы данных и запускает процесс postmaster. Это человек не должен быть суперпользователем Unix (“root”) или компьютерным системным администратором; человек может устанавливать и использовать Postgres без специальных бюджетов или привилегий.
Если ты устанавливаешь Postgres сам, то посмотри в Руководстве администратора инструкции по установке, и вернись к этому руководству когда установка закончится.
Во всех примерах этого руководства начальным символом “%” отмечены команды, которые должны быть набраны в командной строке Unix. Примеры, которые начинаются с символа “*” - это команды на языке запросов Postgres SQL.
Настройка среды
В этом разделе обсуждается как настроить среду, так чтобы можно было использовать клиентские приложения. Предполагается, что Postgres был уже успешно установлен и запущен; смотри Руководство администратора и замечания по установке, о том как установить Postgres.
Postgres - это приложение клиент/сервер. Пользователю необходим доступ только к клиентской части установки (например, такое клиентское приложение как интерактивный монитор psql). Для простоты предполагается, что Postgres установлен в каталог /usr/local/pgsql. Поэтому, если ты видишь каталог /usr/local/pgsql, то вместо него нужно подставить название каталога где установлен Postgres. Все команды Postgres установлены в каталоге /usr/local/pgsql/bin. Поэтому, нужно добавить этот каталог в путь к командам shell. Если используются различные Berkeley C shell, такие как csh или tcsh, то нужно добавить
% set path = ( /usr/local/pgsql/bin path ).
в файл .login в домашний каталог пользователя. Если используются различные Bourne shell, такие как sh, ksh, или bash, то нужно добавить
% PATH=/usr/local/pgsql/bin:$PATH.
% export PATH.
в файл .profile в домашний каталог пользователя. Отсюда предполагается, что bin каталог Postgres добавлен в путь. Кроме того, мы будем часто упоминать “установка переменных shell” или “установка переменных среды” во всём этом документе. Если ты полностью не понял последний параграф про изменение пути поиска, то почитай страницы руководства Unix, которые описывают shell, перед тем как двигаться дальше.
Если администратор сайта не установил это по умолчанию, то тебе необходимо выполнить еще кое-какую работу. Например, если сервер базы данных - удаленная машина, то нужно задать в переменной среды PGHOST имя машины сервера базы данных. Можно также установить PGPORT. И напоследок: если ты пытаешься запустить программу приложение и она жалуется что не может подключиться к postmaster, то тебе немедленно нужно проконсультироваться у администратора сайта чтобы убедиться что среда правильно настроена.
Запуск интерактивного монитора (psql).
Предполагается, что администратор сайта правильно запустил процесс postmaster и у тебя есть право использовать базу данных, и ты (пользователь) можешь запускать приложения. Как упоминалось выше, ты должен добавить /usr/local/pgsql/bin в свой путь поиска shell. В большинстве случаев, это все приготовления, которые необходимо сделать.
Как и в Postgres v6.3, есть два стиля подключения. Администратор сайта может позволить подключаться через сетевое соединение TCP/IP или ограничиться доступом к базе данных только локальной машиной (той же машиной) подключением через сокеты. Этот выбор становится значимым, если ты столкнулся с проблемой в подключении к базе данных.
Если ты получил следующие сообщения об ошибках при командах Postgres (таких как psql или createdb):
% psql template1.
Connection to database 'postgres' failed.
ConnectDB() failed: Is the postmaster running and accepting connections.
At 'UNIX Socket' on port '5432'?
или
% psql -h localhost template1.
Connection to database 'postgres' failed.
ConnectDB() failed: Is the postmaster running and accepting TCP/IP.
(with -i) connections at 'localhost' on port '5432'?
то это обычно из-за того что: (1) postmaster не запущен, или (2) ты попытался подключиться к не тому хосту-серверу. Если ты получил следующее сообщение об ошибках:
FATAL 1:Feb 17 23:19:55:process userid (2360) != database owner (268).
это значит, что администратор сайта запустил postmaster с неправильным пользователем. Попроси его перезапуститься как суперпользователь Postgres.
Управление базами данных
Теперь, когда Postgres установлен и запущен, мы можем создать несколько баз данных для экспериментирования с ними. Здесь, мы опишем основные команды для управления базами данных.
Большинство Postgres приложений предполагают, что имя базы данных, если не задано, то же самое имя что и имя твоего компьютерного бюджета.
Если администратор баз данных создал твой бюджет без права создания баз данных, то он должен сказать тебе имя твоей базы данных. Если это как раз твой случай, то ты можешь пропустить разделы по созданию и удалению баз данных.
Создание базы данных
Скажем, ты хочешь создать базу данным с именем mydb. Это можно сделать с помощью следующей команды:
% createdb mydb.
Если у тебя нет прав необходимых для создания базы данных, ты увидишь следующее:
% createdb mydb.
WARN:user "your username" is not allowed to create/destroy databases.
Createdb: database creation failed on mydb.
Postgres позволяет создавать любое количество баз данных на одном сайте и ты автоматически становишься администратором только что созданной базы данных. Имя базы данных должно начинаться с символа алфавита и ограничиваться длиной в 32 символа. Не каждый пользователь имеет право быть администратором базы данных. Если Postgres отказал тебе в создании базы данных, то администратору сайта нужно разрешить тебе создание баз данных. Поговори с администратором сайта, если это произошло.
Доступ к базе данных
После создания базы данных, ты можешь получить к ней доступ:
· запустив Postgres программу управления на терминале (например psql), который позволит тебе в диалоговом режиме вводить, редактировать, и выполнять команды SQL.
· написав программы на C, с помощью библиотеки подпрограмм LIBPQ. Это позволит тебе использовать команды SQL из C и получать ответы и сообщения о статусе обратно в твою программу. Этот интерфейс обсуждается далее в Руководство программиста PostgreSQL.
Ты можешь захотеть запустить psql, чтобы опробовать примеры из этого руководства. Это может быть выполнено с базой данных mydb при введении команды:
% psql mydb.
Ты увидишь приветствующее сообщение:
Welcome to the POSTGRESQL interactive sql monitor:
Please read the file COPYRIGHT for copyright terms of POSTGRESQL.
Type \? for help on slash commands.
Type \q to quit.
Type \g or terminate with semicolon to execute query.
You are currently connected to the database: template1.
Mydb=>
Эта подсказка показывает, что монитор терминала ждет ввода и что ты можешь вводить SQL запросы в рабочую область, контролируемую монитором терминала. Программа psql распознает управляющие коды, которые начинаются с символа обратного слэша “\”, например, можно получить справку о синтаксисе различных команд Postgres SQLнабрав:
Mydb=> \h.
После того как ты закончишь вводить запрос в рабочую область, можно передать содержимое рабочей области на сервер Postgres, набрав:
Mydb=> \g.
Это приказывает серверу обработать запрос. Если в конце запроса ты поставил точку с запятой, то “\g” не нужна. psql автоматически автоматически обрабатывает запросы, оканчивающиеся точкой с запятой. Чтобы прочитать запрос из файла myFile, вместо интерактивного ввода, набери:
Mydb=> \i fileName.
Чтобы выйти из psql и вернуться в Unix, набери
Mydb=> \q.
и psql закроется и ты вернешься в shell. (Другие управляющие коды можно посмотреть набрав \h в строке монитора.) Свободное место (т.е., пробелы, символы табуляции и новые строки) можно свободно использовать в SQL запросах. Одностроковые комментарии обозначаются “--”. Все после пунктира игнорируется до конца строки. Многостроковые комментарии - это комментарии внутри строк, ограниченных “/* ... */”
Удаление базы данных
Если ты являешься администратором базы данных mydb, то можешь удалить ее, с помощью следующей команды Unix:
% destroydb mydb.
Это действие физически удаляет все файлы Unix, связанные с базой данных, и обратно вернуть ничего нельзя, поэтому оно должно выполняться только предвидев, что она уже никому не понадобится.
Язык запросов
Оглавление
Интерактивный монитор
Концепции
Создание нового класса
Заполнение класса экземплярами
Запрос к классу
Перенаправление запросов SELECT.
Объединение классов
Обновление
Удаление
Использование итоговых функций
Язык запросов Postgres отличается от проекта SQL3 - следующего поколения стандарта. Он имеет много расширений, например, расширяемую систему типов, наследование, функции и образования правил. Эти свойства остались от первоначального языка запросов Postgres, PostQuel. Этот раздел содержит краткий обзор того, как использовать Postgres SQL для выполнения простых операций. Это руководство предназначено только для того, чтобы показать идеи разновидности нашего SQL и никоим образом не претендует на полный справочник по SQL. Было написано много книг по SQL, включая [MELT93] и [DATE97]. Ты должен сознавать, что некоторые свойства языка расширяют ANSI стандарт.
Интерактивный монитор
В примерах ниже, мы предполагаем, что ты создал базу данных mydb как описывалось в предыдущем разделе и запустил psql. Примеры из этого руководства также можно найти в /usr/local/pgsql/src/tutorial/. Обратись к файлу README в том же каталоге чтобы понять как их использовать. Чтобы запустить обучающее руководство, сделай следующее:
% cd /usr/local/pgsql/src/tutorial.
% psql -s mydb.
Welcome to the POSTGRESQL interactive sql monitor:
Please read the file COPYRIGHT for copyright terms of POSTGRESQL.
Type \? for help on slash commands.
Type \q to quit.
Type \g or terminate with semicolon to execute query.
You are currently connected to the database: postgres.
Mydb=> \i basics.sql.
Опция \i указывает читать запросы из заданных файлов. Опция -s переключает в пошаговый режим, который делает паузу перед посылкой запроса на сервер. Запросы этого раздела находятся в файле basics.sql.
У psql есть различные команды \d для отображения системной информации. Рассмотри эти команды более подробно; чтобы вывести весь список, набери \? в командной строке psql.
Концепции
Основное понятие в Postgres - это класс, т.е. именованный набор экземпляров объектов. Каждый экземпляр имеет одинаковое множество именованных атрибутов, а каждый атрибут имеет определенный тип. К тому же, каждый экземпляр имеет постоянный идентификатор объекта (OID), который является уникальным во всей установке. Т.к. синтаксис SQL ссылается на таблицы, мы будем использовать термины таблица и класс как взаимозаменяемые. Также, SQL строка - это экземпляр и SQL колонки - это атрибуты. Как уже говорилось, классы группируются в базы данных, а наборы баз данных управляются одним postmaster процессом, созданным установкой или сайтом.
Создание нового класса
Можно создать новый класс, указав имя класса вместе со всеми именами атрибутов и их типами:
CREATE TABLE weather (
City varchar(80),
Temp_lo int, -- минимальная температура
Temp_hi int, -- максимальная температура
Prcp real, -- осадки
Date date.
);
Заметим, что ключевые слова и идентификаторы регистронезависимы; идентификаторы могут стать регистрозависимым, если написать их в двойных кавычках, как в SQL92. Postgres SQL поддерживает обычные для SQL типы int, float, real, smallint, char(N), varchar(N), date, time, и timestamp, так и другие типы общих утилит и богатый набор геометрических типов. Как мы увидим позже, в Postgres можно создать произвольное количество типов данных, определенных пользователем. Следовательно, имена типов не должны быть ключевыми словами, кроме необходимой поддержки специальных случаев в SQL92 стандарте. Несомненно, команда Postgres create выглядит также как и команда создания таблиц в традиционной реляционной системе. Однако, вскоре мы увидим, что классы имеют свойства, которые расширяют реляционную модель.
Заполнение класса экземплярами
Выражение insert используется для заполнения класса экземплярами:
INSERT INTO weather.
VALUES ('San Francisco', 46, 50, 0.25, '11/27/1994');
Также можно использовать команду copy, чтобы выполнить загрузку большого количества данных из плоских (ASCII) файлов. Обычно это быстрее, потомучто данные читаются (или записываются) как единичная атомарная транзакция напрямую в или из заданной таблицы. Для примера:
COPY INTO weather FROM '/home/user/weather.txt'
USING DELIMITERS '|';
где файл источник должен быть доступен для машины сервера, а не клиента, т.к. серверная часть читает файл напрямую.
Запрос к классу
Класс weather может быть опрошен с помощью обычных запросов реляционной выборки и проекции. Для этого используется выражение SQL - select. Выражение делится на список объектов (часть, которая описывает возвращаемые атрибуты) и определение (часть, в которой указаны любые ограничения). Например, получить все строки из weather:
SELECT * FROM WEATHER;
и получим:
CLASS="PROGRAMLISTING".
+--------------+---------+---------+------+------------+
|city | temp_lo | temp_hi | prcp | date |
+--------------+---------+---------+------+------------+
|San Francisco | 46 | 50 | 0.25 | 11-27-1994 |
+--------------+---------+---------+------+------------+
|San Francisco | 43 | 57 | 0 | 11-29-1994 |
+--------------+---------+---------+------+------------+
|Hayward | 37 | 54 | | 11-29-1994 |
+--------------+---------+---------+------+------------+
Можно указывать любые произвольные выражения в списке объектов. Например:
SELECT city, (temp_hi+temp_lo)/2 AS temp_avg, date FROM weather;
Произвольные логические операторы (and, or и not) разрешены в определении любого запроса. Например,
SELECT * FROM weather.
WHERE city = 'San Francisco'
AND prcp > 0.0;
в результате:
+--------------+---------+---------+------+------------+
|city | temp_lo | temp_hi | prcp | date |
+--------------+---------+---------+------+------------+
|San Francisco | 46 | 50 | 0.25 | 11-27-1994 |
+--------------+---------+---------+------+------------+
В качестве последнего замечания, можно указать, чтобы результаты выборки возвращались в отсортированными и с удалением экземпляров копий.
SELECT DISTINCT city.
FROM weather.
ORDER BY city;
Перенаправление запросов SELECT.
Любой запрос выборки можно перенаправить в новый класс
SELECT * INTO TABLE temp FROM weather;
Это формирует неявную команду create, создавая новый класс temp с именами атрибутов и типами, указанными списке объектов команды select into. Затем, мы можем, конечно, выполнить любую операцию над классом результатом, такие какие мы могли выполнять над другими классами.
Соединение классов
До сих пор, наши запросы имели доступ только к одному классу одновременно. Запросам доступны несколько классов одновременно, или доступен один класс таким образом, что многочисленные экземпляры класса обрабатываются одновременно. Запрос, который работает с несколькими экземплярами одного или разных классов одновременно, называется соединительный запрос. Например, мы хотим найти все записи, которые лежат в температурном диапазоне других записей. В действительности, нам нужно сравнить атрибуты temp_lo и temp_hi каждого экземпляра EMP с атрибутами temp_lo и temp_hi всех остальных экземпляров EMP.
Замечание: Это только умозрительная модель. На самом деле, соединение может выполняться более эффективно, но это незаметно для пользователя.
Мы можем сделать это с помощью следующего запроса:
SELECT W1.city, W1.temp_lo AS low, W1.temp_hi AS high,
W2.city, W2.temp_lo AS low, W2.temp_hi AS high.
FROM weather W1, weather W2.
WHERE W1.temp_lo < W2.temp_lo.
AND W1.temp_hi > W2.temp_hi;
+--------------+-----+------+---------------+-----+------+
|city | low | high | city | low | high |
+--------------+-----+------+---------------+-----+------+
|San Francisco | 43 | 57 | San Francisco | 46 | 50 |
+--------------+-----+------+---------------+-----+------+
|San Francisco | 37 | 54 | San Francisco | 46 | 50 |
+--------------+-----+------+---------------+-----+------+
Замечание: Семантика такого соединения, означает что ограничение выражения истинно, для определённого декартова произведения классов, указанных в запросе. Для тех экземпляров из декартова произведения, для которых ограничение верно, Postgres вычисляет и возвращает значения, указанные в списке объектов. Postgres SQL, не принимает в внимание повторяющие значения в таких выражениях. Это значит, что Postgres иногда пересчитывает один и тот же объект несколько раз; это часто случается когда логические выражения соединяются с помощью "or". Для удаления таких повторений, ты должен использовать выражение select distinct.
В этом случае, оба W1 и W2 заменяются экземпляром класса weather, и он действует на все экземпляры класса. (По терминологии большинства систем баз данных, W1 и W2 известны как переменные диапазона.) Запрос может содержать произвольное число названий классов и суррогатов.
Обновление
Можно обновлять существующие экземпляры с помощью команды update. Предположим, что температура понизилась на 2 градуса 28 ноября, ты можешь обновить данные так:
UPDATE weather.
SET temp_hi = temp_hi - 2, temp_lo = temp_lo - 2.
WHERE date > '11/28/1994';
Удаление
Удаление выполняется с помощью команды delete:
DELETE FROM weather WHERE city = 'Hayward';
Все записи о погоде в Hayward будут удалены. Надо быть осторожным с запросами в форме
DELETE FROM classname;
Без ограничения, delete просто удаляет все экземпляры данного класса, делая его пустым. Система не запрашивает подтверждения перед тем как сделать это.
Использование итоговых функций
Как и большинство других языков запросов, PostgreSQL поддерживает итоговые функции. Текущая реализация Postgres имеет некоторые ограничения для итоговых функций. Особенно, пока существует подсчет итогов такими функциями как count, sum, avg (среднее), max (максимум) и min (минимум) над множествами экземпляров, итоги могут только появляться в списке объектов запроса, и не прямо в определении (в предложении). Например,
SELECT max(temp_lo) FROM weather;
разрешено, хотя в
SELECT city FROM weather WHERE temp_lo = max(temp_lo);
нет. Однако, это часто требуется и для достижения нужного
результата может использоваться вложенная выборка:
SELECT city FROM weather WHERE temp_lo = (SELECT max(temp_lo) FROM weather);
Итоги могут также быть при group by предложениях:
SELECT city, max(temp_lo).
FROM weather.
GROUP BY city;
Расширенные свойства PostgresSQL.
Оглавление
Наследование
Неатомарные значения
Time Travel.
Остальные свойства
Получив основы использования e>Postgre> SQL для доступа к данным, теперь мы поговорим о таких свойствах Postgres, которые отличают его от обычных администраторов данных. Эти свойства включают наследование, time travel и неатомарные значения данных (массивы и многозначные атрибуты).Примеры этого раздела можно также найти в advance.sql в каталоге tutorial. (Смотри Главу 5 как их использовать.).
Наследование
Давайте создадим два класса. Класс capitals содержит столицы штатов, которые также есть и в cities. Естественно, класс capitals должен наследоваться от cities.
CREATE TABLE cities (
Name text,
Population float,
Altitude int -- (in ft).
);
CREATE TABLE capitals (
State char(2).
) INHERITS (cities);
В этом случае, экземпляр класса capitals наследует все атрибуты (name, population, и altitude) от своего родителя, cities. Тип атрибута name - это text, родной тип Postgres для ASCII строк переменной длины. Тип атрибута population - это float, родной тип Postgres для дробных чисел двойной точности. Строение capitals имеет дополнительный атрибут, state, который отображает штат. В Postgres, классы могут наследоваться от нуля и более классов, и запросы могут относится или ко всем экземплярам класса или ко всем экземплярам класса плюс ко всем его потомкам.
Замечание: Наследственная иерархия - это прямой нециклический граф.
Например, следующий запрос ищет все города, которые расположены на высоте 500ft или выше:
SELECT name, altitude.
FROM cities.
WHERE altitude > 500;
+----------+----------+
|name | altitude |
+----------+----------+
|Las Vegas | 2174 |
+----------+----------+
|Mariposa | 1953 |
+----------+----------+
С другой стороны, вот запрос как найти названия всех городов, включая столицы штатов, которые расположены на высоте ниже 500ft:
SELECT c.name, c.altitude.
FROM cities* c.
WHERE c.altitude > 500;
который возвращает:
+----------+----------+
|name | altitude |
+----------+----------+
|Las Vegas | 2174 |
+----------+----------+
|Mariposa | 1953 |
+----------+----------+
|Madison | 845 |
+----------+----------+
Здесь “*” после cities показывает, что запрос должен касаться всего cities и всех классов ниже cities в наследственной иерархии. Многие из команд, про которые мы уже говорили (select, and>upand> и delete) поддерживают “*” тип записи, как и другие типа alter.
Неатомарные значения
Одним из принципов реляционной модели является то, что атрибуты отношения атомарны. Postgres не имеет этого ограничения; атрибуты могут сами содержать под-значения, которые могут быть доступны из языка запросов. Например, можно создать атрибут, который является массивом базового типа.
Массивы
Postgres разрешает атрибуты экземпляров определяемые как многомерные массивы постоянной или переменной длины. Можно создавать массивы любого базового типа или типа определенного пользователем. Чтобы проиллюстрировать их использование, сначала создадим класс с массивами базовых типов.
CREATE TABLE SAL_EMP (
Name text,
Pay_by_quarter int4[],
Schedule text[][].
);
Запрос выше создает класс SAL_EMP с text строкой (name), одномерным массивом int4 (pay_by_quarter), который представляет из себя зарплату рабочему за квартал и двумерный массив text (schedule), который представляет из себя задание рабочему на неделю. Теперь мы выполним несколько вставок INSERTS; заметим, что при добавлении в массив, мы заключаем значения в скобки и разделяем их запятыми. Если ты знаешь язык C, то это похоже на синтаксис при инициализации структур.
INSERT INTO SAL_EMP.
VALUES ('Bill',
'{10000, 10000, 10000, 10000}',
'{{"meeting", "lunch"}, {}}');
INSERT INTO SAL_EMP.
VALUES ('Carol',
'{20000, 25000, 25000, 25000}',
'{{"talk", "consult"}, {"meeting"}}');
По умолчанию, Postgres использует "начало с единицы" соглашение о нумерации -- то есть, массив из n элементов начинается с array[1] и заканчивается array[n]. Теперь, мы можем выполнить несколько запросов к SAL_EMP. Во-первых, мы покажем как получить доступ к элементам массива по одному. Этот запрос возвращает имена рабочих, оплата которых изменилась во втором квартале:
SELECT name.
FROM SAL_EMP.
WHERE SAL_EMP.pay_by_quarter[1] <>
SAL_EMP.pay_by_quarter[2];
+------+
|name |
+------+
|Carol |
+------+
Этот запрос возвращает зарплату рабочих в третьем квартале:
SELECT SAL_EMP.pay_by_quarter[3] FROM SAL_EMP;
+---------------+
|pay_by_quarter |
+---------------+
|10000 |
+---------------+
|25000 |
+---------------+
Нам также доступны произвольные части массива, или подмассивы. Этот запрос возвращает первую часть задания Billа для первых двух дней недели.
SELECT SAL_EMP.schedule[1:2][1:1].
FROM SAL_EMP.
WHERE SAL_EMP.name = 'Bill';
+-------------------+
|schedule |
+-------------------+
|{{"meeting"},{""}} |
+-------------------+
©Drkb::03009.
| Нахождение последнего вхождения подстроки в строку |
| Методы криптографической защиты информации Windows. |
Мы вступили в цифровой век. На смену бумажным документам пришли электронные, а личные контакты все чаще уступают место переписке по e-mail. Поэтому «шпионские штучки» вроде паролей и шифровок становятся все более привычными и необходимыми инструментами безопасности.
| Методы использования и создания BSP деревьев |
Автор: Роман Акопов
Опубликовано: 12.02.2001.
Версия текста: 1.1.
Интро
Эта статья объясняет как BSP деревья (binary space partition, двоичное деление пространства) могут быть использованы частью алгоритмов прорисовки для удаления односторонних поверхностей, частичной z-сортировки, удаления невидимых частей.
| Методы программрования: переборные алгоритмы |
Методы программрования: переборные алгоритмы 

Булычев В.А.
Данная статья открывает цикл работ, посвященных не особенностям какого-то отдельного языка программирования (например Паскаля), а общим ИДЕЯМ и МЕТОДАМ разработки алгоритмов. Тем не менее, опираться мы все равно будем на теория, числа, оптимальные алгоритмы, вычислительная, определение, который вы уже знаете. Первоначальный вариант любого алгоритма мы будем записывать на псевдокоде - языке, который занимает промежуточное положение между нашим обычным языком и языками программирования. Он не имеет каких-то жестких правил и требований, т.к. предназначен прежде всего для человека, а не компьютера. Это позволит нам избавиться от излишней детализации алгоритма на раннем этапе разработки и сразу выразить его основную идею. Превратить этот псевдокод в программу на Паскале задача совсем несложная - как это делать вы быстро поймете.
Основные идеи первого задания - ПЕРЕБОР, РЕКУРСИЯ, ПЕРЕБОР С ОТХОДОМ HАЗАД. Этими понятиями должен хорошо владеть каждый программист. Кроме того, переборные задачи составляют значительную долю всех школьных олимпиад по информатике.
1. Порождение и перебор комбинаторных объектов
Во многих прикладных задачах требуется найти оптимальное решение среди очень большого (но конечного!) числа вариантов. Иногда удается построить это решение сразу, но в большинстве случаев единственный способ его отыскать состоит в переборе ВСЕХ возможных вариантов и сравнении их между собой. Поэтому так важно для нас научиться строить алгоритмы ПЕРЕБОРА различных комбинаторных объектов - последовательностей, перестановок, подмножеств и т.д.
Схема перебора всегда будет одинакова:
- во-первых, надо установить ПОРЯДОК на элементах, подлежащих перечислению (в частности, определить, какой из них будет первым, а какой последним); - во-вторых, научиться переходить от произвольного элемента к HЕПОСРЕДСТВЕHHО СЛЕДУЮЩЕМУ за ним (т.е. для заданного элемента x1 строить такой элемент x2, что x1<x2 и между x1 и x2 нет других элементов).
Hаиболее естественным способом упорядочения составных объектов является ЛЕКСИКОГРАФИЧЕСКИЙ порядок, принятый в любом словаре (сначала сравниваются первые буквы слов, потом вторые и т.д.) - именно его мы и будем чаще всего использовать. А вот процедуру получения следующего элемента придется каждый раз изобретать за- ново. Пока запишем схему перебора в таком виде:
X:=First;
While X<>Last do Next(X);
где First - первый элемент; Last - последний элемент; Next - процедура получения следующего элемента.
1.1. Последовательности
Hапечатать все последовательности длины N из чисел 1,2,...,M.
First = (1,1,...,1) Last = (M,M,...,M).
Всего таких последовательностей будет M^N (докажите!). Чтобы понять. как должна действовать процедура Next, начнем с примеров. Пусть N=4,M=3. Тогда:
Next(1,1,1,1) -> (1,1,1,2) Next(1,1,1,3) -> (1,1,2,1) Next(3,1,3,3) -> (3,2,1,1).
Теперь можно написать общую процедуру Next:
Code: Procedure Next; Begin. {найти i: X[i]<M,X[i+1]=M,...,X[N]=M}; X[i]:=X[i]+1; X[i+1]:=...:=X[N]:=1. End;
| Метод Гаусса решения системы линейных уравнений |
Code: { **** UBPFD *********** by kladovka.net.ru **** >> Метод Гаусса решения системы линейных уравнений. Рещение системы линейных уравнений (возможно переопределенной) методом Гаусса. Определяется ситуация, что система не имеет рещений. Ситуация, когда система. Имеет более чем одно решение не рассматривается. В случае удачного завершения. Возвращает нуль. Зависимости: System. Автор: Mystic, mystic2000@newmail.ru, ICQ:125905046, Харьков. Copyright: (C) Mystic. Дата: 25 апреля 2002 г. ********************************************** } Function LinGauss(M, N: Integer; Data: PExtended; X: PExtended): Cardinal; Var. PtrData: PExtended; PtrData1, PtrData2: PExtended; Temp: Extended; I, J, Row: Integer; Max: Extended; MaxR: Integer; Begin. Assert(M >= N, 'Invalid start data'); For I := 0 to N-1 do // Для каждой переменной. Begin. // 1. Поиск максимального элемента. PChar(PtrData) := PChar(Data) + I*(N+2)*SizeOf(Extended); MaxR := I; Max := PtrData^; For J := I+1 to M-1 do. Begin. PChar(PtrData) := PChar(PtrData) + (N+1)*SizeOf(Extended); If Abs(PtrData^) > Abs(Max) then. Begin. Max := PtrData^; MaxR := J; End; End; // 2. А вдруг неразрешима? If Abs(Max) < 1.0E-10 then. Begin. Result := $FFFFFFFF; Exit; End; // 3. Меняем местами строки. If MaxR <> I then. Begin. PChar(PtrData1) := PChar(Data) + MaxR*(N+1)*SizeOf(Extended); PChar(PtrData2) := PChar(Data) + I*(N+1)*SizeOf(Extended); For J := 0 to N do. Begin. Temp := PtrData1^; PtrData1^ := PtrData2^; PtrData2^ := Temp; PChar(PtrData1) := PChar(PtrData1) + SizeOf(Extended); PChar(PtrData2) := PChar(PtrData2) + SizeOf(Extended); End; End; // 4. Пересчет направляющей строки. PChar(PtrData) := PChar(Data) + I*(N+1)*SizeOf(Extended); For J := 0 to N do. Begin. PtrData^ := PtrData^ / Max; PChar(PtrData) := PChar(PtrData) + SizeOf(Extended); End; // 5. Пересчет всей оставшйся части таблицы. PtrData1 := Data; For Row := 0 to M-1 do. Begin. If Row = I then. Begin. PChar(PtrData1) := PChar(PtrData1) + (N+1)*SizeOf(Extended); Continue; End; PChar(PtrData2) := PChar(Data) + I*(N+1)*SizeOf(Extended); Temp := PExtended(PChar(PtrData1) + I*SizeOf(Extended))^; For J := 0 to N do. Begin. PtrData1^ := PtrData1^ - Temp * PtrData2^; PChar(PtrData1) := PChar(PtrData1) + SizeOf(Extended); PChar(PtrData2) := PChar(PtrData2) + SizeOf(Extended); End; End; End; // 6. Проверка того, что система переопределена. PChar(PtrData) := PChar(Data) + N*(N+1)*SizeOf(Extended); For I := N to M-1 do. For J := 0 to N do. Begin. If Abs(PtrData^) > 1.0E-10 then. Begin. Result := $FFFFFFFF; Exit; End; PChar(PtrData) := PChar(PtrData) + SizeOf(Extended); End; // Все ОК. PChar(PtrData) := PChar(Data) + N*SizeOf(Extended); For I := 0 to N-1 do. Begin. X^ := PtrData^; PChar(X) := PChar(X) + SizeOf(Extended); PChar(PtrData) := PChar(PtrData) + (N+1) * SizeOf(Extended); End; Result := 0; End;
Метод Дихотомии.
| Метод Дихотомии |
Code: Program dicotomie; Var y:integer; Function f(var x:real):real; Begin. If y=1 then f:=sin(x)-1/2. Else begin if y=2 then f:=exp(x)-2. Else begin if y=3 then f:=sqr(x)-2 end; end; End; Procedure verif; Var a,b,m,ep,va:real; I,n:integer; R,c:char; Begin repeat. Writeln('choisir une fonction parmis les trois'); Writeln('f[x]=sin(x)-1/2.....[1]'); Writeln('f[x]=exp(x)-2.......[2] '); Writeln('f[x]=x(puiss)2-2....[3] '); Write('entrer le nombre [i] de 1..3 i='); Readln(y); Writeln('pour calculer la racine de la fonction f[x] donne lintervalle [a,b]') ; Write(' donner a='); Readln(a); Write(' donner b='); Readln(b);begin. If a>b then. Repeat writeln('*****************REMARQUE**************'); Writeln(' *** il faut que a<b *** '); Write('S.V.P entrer un autre intervalle ou invercer les valeurs a='); Readln(a); Write(' b='); Readln(b); Until a<b; Begin. If f(a)*f(b)>0 then. Repeat. Writeln('*******************REMARQUE************************'); Writeln(' *** la fonction ne admet aucun zero dans se intervalle *** '); Writeln(' '); Write('S.V.P entrer un autre intervalle a='); Readln(a); Write(' b='); Readln(b); Until f(a)*f(b)<=0; Writeln('la fonctin f admet au moins un zero dans [',a,';',b,']'); Write(' '); Write('entrer le nombre d"iteration n='); Readln(n); M:=(a+b)/2; if f(m)=0 then ep:=m. Else. Begin for i:=1 to n-1 do. Begin if f(m)*f(a)>0 then begin a:=m; m:=(b+m)/2; end. Else m:=(a+m)/2; b:=2*m-a; End; End; i:=i+1; Ep:=m; Writeln(' la RACINE pour l"iteration ',n,' est epsilon=',ep); Write('voulez vous calculerf[',ep,'] O/N?'); Readln(c); if c='O' then writeln('f[',ep,']=',f(ep)); Write('voulez vous continuer O/N? '); Readln(r); end; end; Until r='N'; End; Begin. Writeln(' DICOTOMIE '); Writeln(' '); Writeln(' '); Verif; End.
©Drkb::04247.
| Метод Рунге-Кутта решения дифференциальных уравнений и их систем |
Метод Рунге-Кутта решения дифференциальных уравнений и их систем.
© 2006 Андрей Садовой.
Метод позволяет решать системы обыкновенных дифференциальных уравнений (ОДУ) первого порядка следующего вида:
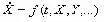 ,
 ,
и т.д.,
которые имеют решение:
 ,
 ,
и т.д.,
где t – независимая переменная (например, время); X, Y и т.д. – искомые функции (зависимые от t переменные). Функции f, g и т.д. – заданы. Также предполагаются заданными и начальные условия, т.е. значения искомых функций в начальный момент.
Одно дифференциальное уравнение – частный случай системы с одним элементом. Поэтому, далее речь пойдет для определенности о системе уравнений.
Метод может быть полезен и для решения дифференциальных уравнений высшего (второго и т.д.) порядка, т.к. они могут быть представлены системой дифференциальных уравнений первого порядка.
Метод Рунге-Кутта заключается в рекурентном применении следующих формул:

 ...
где
 ,
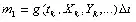 ,
 ,
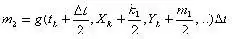 ,
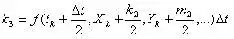 ,
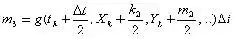 ,
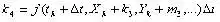 ,

Реализация Метода Рунге-Кутта на Delphi может выглядеть так (привожу полностью модуль):
Code: Unit RK_Method; Interface. Type. TVarsArray = array of Extended; // вектор переменных включая независимую. TInitArray = array of Extended; // вектор начальных значений. TFunArray = array of function(VarsArray: TVarsArray ):Extended; // вектор функций. TResArray = array of array of Extended; // матрица результатов. TCoefsArray = array of Extended; // вектор коэффициетов метода. Function Runge_Kutt( // метод Рунге-Кутта. FunArray: TFunArray; // массив функций. First: Extended; // начальная точка по независимой координате. Last: Extended; // конечная точка по независимой координате. Steps: Integer; // число шагов по независимой координате. InitArray: TInitArray; // вектор начальных значений. Var Res: TResArray // матрица результатов включая независ. переменную. ):Word; // возвращаемое значение - код ошибки. Implementation. Function Runge_Kutt( // метод Рунге-Кутта. FunArray: TFunArray; // массив функций. First: Extended; // начальная точка по независимой координате. Last: Extended; // конечная точка по независимой координате. Steps: Integer; // число шагов по независимой координате. InitArray: TInitArray; // вектор начальных значений. Var Res: TResArray // матрица результатов включая независ. переменную. ):Word; // возвращаемое значение - код ошибки. Var. Num: Word; // число уравнений. NumInit: Word; // число начальных условий. Delt: Extended; // шаг разбиения. Vars: TVarsArray; // вектор переменных включая независимую. Vars2,Vars3,Vars4: TVarsArray; // значения перем. для 2-4 коэф. Coefs1: TCoefsArray; // вектор 1-ых коэффициентов в методе. Coefs2: TCoefsArray; // вектор 2 коэффициентов в методе. Coefs3: TCoefsArray; // вектор 3 коэффициентов в методе. Coefs4: TCoefsArray; // вектор 4 коэффициентов в методе. I: Integer; // счетчик цикла по иттерациям. J: Word; // индекс коэф.-тов метода. K: Integer; // счетчик прочих циклов. Begin. Num:=Length(FunArray); // узнаем число уравнений. NumInit:=Length(InitArray); // узнаем число начальных условий. If NumInit<>Num then. Begin. Result:=100; // код ошибки 100: число уравнений не равно числу нач. усл. Exit; End; Delt:=(Last-First)/Steps; // находим величину шага разбиений. SetLength(Res,Num+1,Steps+1); // задаем размер матрицы ответов с незав. перем. SetLength(Vars,Num+1); // число переменных включая независимую. SetLength(Vars2,Num+1); // число переменных для 2-го коэф. включая независимую. SetLength(Vars3,Num+1); // число переменных для 3-го коэф. включая независимую. SetLength(Vars4,Num+1); // число переменных для 4-го коэф. включая независимую. SetLength(Coefs1,Num); // число 1-ых коэф. метода по числу уравнений. SetLength(Coefs2,Num); // число 2-ых коэф. метода по числу уравнений. SetLength(Coefs3,Num); // число 3-их коэф. метода по числу уравнений. SetLength(Coefs4,Num); // число 4-ых коэф. метода по числу уравнений. // Начальные значения переменных: Vars[0]:=First; For K:=0 to NumInit-1 do Vars[K+1]:=InitArray[K]; For J:=0 to Num do Res[J,0]:=Vars[J]; // первая точка результата. For I:=0 to Steps-1 do // начало цикла иттераций. Begin. For J:=0 to Num-1 do Coefs1[J]:=FunArray[J](Vars)*delt; // 1-й коэфф. // Находим значения переменных для второго коэф. Vars2[0]:=Vars[0]+delt/2; For K:=1 to Num do Vars2[K]:=Vars[K]+Coefs1[K-1]/2; For J:=0 to Num-1 do Coefs2[J]:=FunArray[J](Vars2)*delt; // 2-й коэф. // Находим значения переменных для третьго коэф. Vars3[0]:=Vars[0]+delt/2; For K:=1 to Num do Vars3[K]:=Vars[K]+Coefs2[K-1]/2; For J:=0 to Num-1 do Coefs3[J]:=FunArray[J](Vars3)*delt; // 3 коэфф. // Находим значения переменных для 4 коэф. Vars4[0]:=Vars[0]+delt; For K:=1 to Num do Vars4[K]:=Vars[K]+Coefs3[K-1]; For J:=0 to Num-1 do Coefs4[J]:=FunArray[J](Vars4)*delt; // 4 коэфф. // Находим новые значения переменных включая независимую. Vars[0]:=Vars[0]+delt; For K:=1 to Num do. Vars[K]:=Vars[K]+(1/6)*(Coefs1[K-1]+2*(Coefs2[K-1]+Coefs3[K-1])+Coefs4[K-1]); // Результат иттерации: For J:=0 to Num do Res[J,I+1]:=Vars[J]; End; // конец итераций. Result:=0; // код ошибки 0 - нет ошибок. End; End.
| Метод Монте-Карло |
Рассмотрим произвольный квадрат с центром в начале координат и вписанный в него круг. Будем рассматривать только первую координатную четверть. В ней будет находиться четверть круга и четверть квадрата. Обозначим радиус круга r, тогда четверть квадрата тоже будет квадратом(очевидно) со стороной r.
Будем случайным образом выбирать точки в этом квадрате и считать количество точек, попавших в четверть круга. Благодаря теории вероятности мы знаем, что отношение попаданий в четверть круга к попаданиям 'в молоко' равно отношению площадей - пи/4. Вот, собственно, и весь алгоритм... Чем больше взятых наугад точек мы проверим, тем точнее будет отношение площадей.
Вот простенькая программа на Паскале, считающая пи этим способом... Четыре первых знака требуют на моем PentiumII-300 около 5 минут...
Code: Uses Crt; Const. N=10000000; R=46340; R2=46340*46340; Var. I,pass : LongInt; X,y : real; {$F+}. Begin. WriteLn('Поехали!'); Randomize; Pass:=0; For i:=1 to n do. Begin. X:=Random(r+1); Y:=Random(r+1); If ( x*x+y*y < r2 ) then INC(pass); End; TextColor(GREEN); WriteLn('Число ПИ получилось равным: ',(pass/i*4):0:5); ReadLn; End.
| Метод Ньютона |
Code: Program newton; Type. Vect1 = array [1..15] of real; Vect2 = array [1..15] of char; Vect3 = array [1..15] of integer; Var. Coef,ncoef :vect1; Cha:vect2;bol:boolean; Pui:vect3; B1,n,i,deg,l,nbr,ln,gen,k:integer; S,p,c,x,y,z,r,d,ep,fd,x0,a,b :real; Co,rep:char;op,op1: set of char; Ch:string; Ca:char; (*fonction de la puissance*). Function pow(x:real;n:integer):real; Begin. P:=1; For i := 1 to abs(n) do begin. If n < 0 then p:=p/10. Else p:=p*x; End; Pow:=p; End; (****************) Function chifi(chifr:char):integer; Begin. Case chifr of. '1':chifi:=1;'2':chifi:=2;'3':chifi:=3;'4':chifi:=4;'5':chifi:=5; '6':chifi:=6;'7':chifi:=7;'8':chifi:=8;'9':chifi:=9;'0':chifi:=0; End; End; (*fonction qui lit la chaine de caractSre*). Function cach(chaine:string):real; Var res:real; Point,j:integer; Begin. B1:=0; For i:=1 to length(chaine) do if chaine[i]='.'then b1:=1; If b1 = 0 then chaine:=chaine+'.'; If (chaine[1]<>'+') and (chaine[1]<>'-')then chaine:='+'+chaine; Point:=length(chaine)+1; J:=1; For i:=2 to length(chaine) do begin. If chaine[i]='.'then point:=i. Else begin cha[j]:=chaine[i];j:=j+1;end; End; For i:=1 to length(chaine)-2 do begin. Case cha[i] of. '1':ncoef[i]:=1;'2':ncoef[i]:=2;'3':ncoef[i]:=3;'4':ncoef[i]:=4;'5':ncoef[i]:=5; '6':ncoef[i]:=6;'7':ncoef[i]:=7;'8':ncoef[i]:=8;'9':ncoef[i]:=9;'0':ncoef[i]:=0; End; End; Res:=0; J:=0; For l:=point-2 downto 1 do begin. Res:= res + ncoef[l] * pow(10,j); J:=j+1; End; J:=1; For l:=point-1 to length(chaine)-2 do begin. Res:= res + ncoef[l] * pow(10,-j); J:=j+1; End; Case chaine[1] of. '+':res:=+1*res; '-':res:=-1*res; End; Cach:=res; End; (*procedure qui affiche la formule *). Procedure tri(st:string); Var l,di:integer; Mot,mots,chifre:string; Begin. Op1:=['0','1','2','3','4','5','6','7','8','9']; Ln:=1;op:=['+','-','=']; St:=st+'='+'0'; If st[1] in op then else. St:='+'+st; For l:=1 to length(st) do begin. If l=1 then mot :=st[l]. Else mot:=mot+st[l]; If (st[l]in op) and (st[l+1]='x')then. Mot:=mot+'1'; If (st[l+1]in op) and (st[l]='x')then. Mot:=mot+'1'; End; Mots:=mot[1]; For l:=2 to length(mot)-2 do mots:=mots+mot[l]; St:=mot;writeln('l"‚quation est: [ ', mots,'=0 ]'); L:=1; While st[l] <> '=' do. Begin. Chifre:=st[l]; While (st[l+1]<>'x')and(st[l+1]<>'=') do. Begin. L:=l+1; Chifre:=chifre+st[l]; End; Coef[ln]:=cach(chifre);ln:=ln+1; Case st[l+1] of. '=':l:=l+1; 'x':begin. Pui[ln-1]:=chifi(st[l+2]); L:=l+3; End; End; End; End; (*foction qui calcule f(x)*). Function f(r:real):real; Begin. C:=0; Case gen of. 4:for l:=1 to ln-1 do c:= c + coef[l] * pow(r,(pui[l])); End; F := c; End; {*fonction qui calcule la 1er deriv‚*}. Function df(var x:real):real; Begin. C:=0; Case gen of. 4:for l:=1 to ln-2 do c:=c+pui[l] * coef[l] * pow(x,(pui[l]-1)); End; Df:=c; End; {*fonction qui calcule la 2eme deriv‚*}. Function df2(var x:real):real; Begin. C:=0; Case gen of. 4:for l:=1 to ln-3 do c:=c+pui[l]*(pui[l]-1)*coef[l]*pow(x,(pui[l]-2)); End; Df2:=c; End; {*programme principale*}. Begin. Rep:='n'; b1:=2; While rep<>'o' do. Begin. Writeln('PROGRAMME DE LA SOLUTION D"UNE FONCTION NON LINEAIRE PAR LA METHODE DE NEWTON');writeln(' '); Writeln('* * * * * * * * * PRESENTE PAR BACHIR ET SAMIA * * * * * * * ');writeln; If b1<>2 then readln; Writeln(' POUR CALCULER LA RACINE DE LA FONCTION: ');writeln(''); Write(' donner f[x]=');readln(ch); Case ch[1] of. '1'..'9','+','-','x':begin gen:=4; tri(ch); end; End; Begin. Readln; Write('donner la valeur a=');readln(a); Write('donner la valeur b=');readln(b); Write('donner l"erreur ep=');readln(ep);writeln(''); k:=0; If f(a)=0 then begin writeln(' SOLUTION x=',a); Writeln(' f[',a,']=',f(a)); Writeln('ET LE NOMBRE D"ETERATION EST i=0'); End. Else if f(b)=0 then begin writeln(' SOLUTION x=',b); Writeln(' f[',b,']=',f(b)); Writeln('ET NOMBRE D"ETERATION EST i=0'); End. Else. If f(a)*f(b)>0 then begin. Writeln(' ***************REMARQUE*************** '); Writeln('ERREUR!!! LA FONCTION NE ADMET AUCUN ZERO...');end. Else begin. If f(a)*df2(a)>0 then x0:=a. Else x0:=b; If f(x0)=0 then begin r:=x0; Writeln(' SOLUTION x=',r); Writeln(' f[',r,']=',f(r)); Writeln(' ET LE NOMBRE D"ITERATION EST i=',k); end. Else begin. If df(x0)=0 then begin. Writeln(' ***************REMARQUE*************** '); Writeln('ERREUR!!! la derive est NULLE df(x)=0...');end. Else begin repeat. D:=-f(x0)/df(x0); X0:=x0+d; K:=k+1; Until abs(d)<abs(ep*x0); R:=x0; Writeln(' '); Writeln(' SOLUTION x=',r); Writeln(' '); Writeln(' f[',r,']=',f(r) ); Writeln(' '); Writeln(' ET '); Writeln(' '); Writeln(' LE NOMBRE D"ITERATUION EST N=',k); Writeln(' '); end;end;end; Write('voulez vous quiter O/N?'); read(rep); Writeln(' '); Writeln(' '); Writeln(' '); Writeln(' '); End;end; End.
| Объединение двух иконок |
Code: { I want to combine 2 icons like Windows does with. The links (the small arrow). Can anyone tell me how that works? } Function CombineIcons(FrontIcon, BackIcon: HIcon): HIcon; Var. WinDC: HDC; FrontInfo: TIconInfo; FrontDC: HDC; FrontSv: HBITMAP; BackInfo: TIconInfo; BackDC: HDC; BackSv: HBITMAP; BmpObj: tagBitmap; Begin. WinDC := GetDC(0); GetIconInfo(FrontIcon, FrontInfo); FrontDC := CreateCompatibleDC(WinDC); FrontSv := SelectObject(FrontDC, FrontInfo.hbmMask); GetIconInfo(BackIcon, BackInfo); BackDC := CreateCompatibleDC(WinDC); BackSv := SelectObject(BackDC, BackInfo.hbmMask); GetObject(FrontInfo.hbmMask, SizeOf(BmpObj), @BmpObj); BitBlt(BackDC, 0,0,BmpObj.bmWidth, BmpObj.bmHeight, FrontDC, 0,0,SRCAND); SelectObject(BackDC, BackInfo.hbmColor); DrawIconEx(BackDC, 0,0,FrontIcon, 0,0,0,0,DI_NORMAL); Result := CreateIconIndirect(BackInfo); SelectObject(FrontDC, FrontSv); DeleteDC(FrontDC); SelectObject(BackDC, BackSv); DeleteDC(BackDC); ReleaseDC(0,WinDC); DeleteObject(FrontInfo.hbmColor); DeleteObject(FrontInfo.hbmMask); DeleteObject(BackInfo.hbmColor); DeleteObject(BackInfo.hbmMask); End; // Remember: The icon created with this function must be destroyed with. // DestroyIcon() function when finished using it.
Объединить 2 файла.
| Объединить 2 файла |
Code: Procedure ConCatFiles(Const targetname: String; Const Sourcenames: Array of String); Var. I: Integer; Target, source: TFileStream; Begin. Target := TFileStream.Create( targetname, fmCreate ); Try. For i:= Low(Sourcenames) To High(Sourcenames) Do Begin. Source := TFileStream.Create( Sourcenames[i], FmOpenread or fmShareDenyNone ); Try. Target.Copyfrom( source, 0 ); Finally. Source.free; End. End; Finally. Target.Free; End; End;
Использование:
Code: ChDir(ExtractFileDir(Application.Exename)); ConcatFiles('sum.txt', ['project1.dpr','unit1.pas','unit2.pas']);
©Drkb::03178.
Объектно-ориентированный подход и современные мониторы транзакций.
| Объектно-ориентированный подход и современные мониторы транзакций |
Объектно-ориентированный подход и современные мониторы транзакций
В. Индриков, АО ВЕСТЬ
Объектно-ориентированный подход и мониторы транзакций? А где, собственно, связь? Если с ООП все, вроде бы, ясно, то мониторы - вопрос темный, да и, кажется, вообще из другой области. Зачем они вообще? "А затем," - отвечают нам, - "чтобы обеспечить высокую пропускную способность системы и повышает ее устойчивость к сбоям." "Помилуйте," - локтем отодвигает предыдущего оратора создатель сервера баз данных, - "мы это и без них прекрасно умеем - и на кластерах работаем, и транзакции мониторим." Тут вам и диспут, и острота схватки. Говорят и такое: "Многие ..., кто ... выбирает мониторы транзакций, применяет их не по назначению. Не так часто мониторы транзакций используются ради того, для чего они и предназначены, конкретно - поддержки сотен или тысяч одновременно работающих пользователей - такие внедрения составляют не более 1% рынка. Все остальные примеры свидетельствуют о том, что мониторы занимаются асинхронной передачей сообщений или играют роль связующего программного обеспечения в разнородных средах." (DATABASE Journal, N2 1996 стр. 77, перевод мой).
В этом изречении содержится, как минимум, две мысли. Первая - есть альтернативы мониторам транзакций. Вторая, спорная - мониторы предназначены для обработки тысяч транзакций на одной системе и ничего более. Самое забавное, что и те, кто продает мониторы, чаще всего думают также. И спорю с ними не я, а как раз те, кто применяет эти мониторы, и, если верить тексту, 99% пользователей использует их отнюдь не ради тех возможностей, которые "и так присутствуют в серверах БД." Я даже позволю себе предположить, что они, пользователи, нуждаются в мониторе транзакций, поскольку тот является средой разработки распределенных приложений. Средой, которая, очевидно, имеет какие-то плюсы.
И я даже готов был бы согласиться с тем, что среда эта не является объектно-ориентированной, если бы не обратившее на себя внимание пугающее сходство CSI (Client/Server Interactions) диаграмм в документации на монитор TopEnd и диаграмм сценариев в объектно-ориентированных методах Буча и Fusion. Речь не о принципиальном сходстве, это полбеды, а об изобразительном - повернув CSI на девяносто градусов против часовой стрелки, вы не найдете разницы, обозначения убийственно идентичны.
Причина в том, что, как только разговор выходит за рамки отношений между классами, а точнее, единственного, пожалуй, рассматриваемого в них вида отношений (наследования), большинство из ныне здравствующих ОО методов (почему-то их постоянно пытаются называть методологиями) предлагают набор изобразительных средств, существенно превосходящий по возрасту ОО подход - сценарии и диаграммы перехода состояний, анализ доменов и т.д. Причем в 3 из 5 случаев оказывается, что наследование существует само по себе, а все остальное - в стороне. Блистательным, с моей точки зрения, примером конгломерата из слабо связанных между собой подходов является метод Гради Буча. Наследование объявляется ключом к объектно-ориентированному подходу, все остальное - "недоразвитым", объектно-базирующимся подходом (вот вам еще одна загадка - что лучше, базироваться на объектах или ориентироваться на них?), и в то же самое время Рамбо (метод OMT) является одним из немногих, кому пришла в голову нестандартная мысль - сценарии и диаграммы перехода суперкласса должны наследоваться в подклассах. Между тем, даже и в этом случае мы далеки от разрешения всех проблем - имеет место эффект расщепления состояния в подклассе (state partitioning - S.Matsuoka, K.Wakita, A.Yonezawa, Inheritance Anomaly in Object-Oriented Concurrent Languages, University of Tokyo, 1991), заставляющий переопределять методы суперкласса. Одной из причин является то, что само понятие "состояние" никак не определяется, поэтому, что означает "унаследовать состояние" или "унаследовать переход", остается за рамками ОО метода. Да и само по себе наследование суть целый букет проблем: self проблема, конфликт с требованием атомарности операций, переписывание (overriding) методов по принципу "все или ничего" вместо декларированного в ООП "уточнения", трудности с интеграцией с СУБД, трудности в реализации множественных представлений (views) и координированного выполнения и т.д. (см, например, M.Askit, M.Bergmans Obstacles in Object-Oriented Development, TRESE Project, University of Twente; H. Lieberman, Using Prototypical Objects to implement shared behavior, OOPSLA '86).

Илл. 1.
Крайне интересной попыткой разрешить многие из трудностей с реализацией наследования и на деле позволить применять ООП в больших программных проектах (programming in large), является модель CFOM (Composition-Filters Object Model), разрабатываемая в Университете Твенте, Нидерланды. Она доводит до кристальной чистоты старую идею, гласящую, что сообщения, передаваемые объекту, и методы, обрабатывающие эти сообщения - не обязательно одно и то же, а сообщение представляет самостоятельный интерес. CFOM разводит объект-ядро (kernel object) и интерфейс. Объект-ядро полностью инкапсулирован, его структура недоступна извне, открыты только методы, но и те - не для всех, а только для интерфейса, являющегося своего рода оболочкой объекта. Интерфейс может содержать объекты (секция internals) или ссылки на внешние объекты (externals), а также фильтры. Фильтры задают правила обработки входящих (inputfilters) и, мало того - исходящих (outputfilters) сообщений (Ошибка! Источник ссылки не найден.). В простейшем случае сообщение передается ядру на выполнение, и выглядит это так: inner.doSmth. Inner - это и есть ядро. В общем же случае сообщение, попав в сито фильтров, может быть также модифицировано либо переадресовано одному из объектов, определенных в теле интерфейса, или внешним объектам.
Модель CFOM смело можно отнести к числу "недоразвитых" - вводя понятие объекта и класса, ее создатели отказались от введения отношений наследования. Сделано это по причинам, кратко уже упомянутым выше, и развернутое описание которых займет слишком много места. Каким же образом создатели CFOM ухитряются обойтись без наследования? Очень просто - включение и делегирование. Если вы хотите, чтобы объект objA класса A предоставлял и сервис класса B, вы включаете объект objB класса B в секцию internals интерфейса и помимо возможных прочих фильтров указываете такой: {inner.*, objB.*}. Понять, что делает этот фильтр, легко - все сообщения ('*' и означает "все"), распознаваемые ядром, передавать ядру, все сообщения, распознаваемые объектом objB (т.е. все сообщения класса B), передавать objB. С печально известными проблемами множественного наследования здесь сталкиваться не приходится - фильтры выполняются слева направо и сверху вниз. Если набор методы A и B пересекаются, и вы хотите, чтобы сообщение mess1 обрабатывалось в B, а не в A, то фильтр становится таким: {objB.mess1, inner.*, objB.*}. Если objB объявлен в секции externals, то это ссылка на внешний объект, и в этом случае фильтр {..., objB.*, ...} будет реализовывать делегирование в чистом виде.
На самом деле синтаксис фильтров несколько более сложен, и важную роль играют здесь условия (conditions) - особая группа методов ядра, не имеющих параметров и вырабатывающих значение булевского типа. Тот или иной фильтр может срабатывать или быть проигнорирован в зависимости от условий. Введение условий позволяет в рамках одной модели описать и переходы состояний - изменение состояния объекта и даже история изменения состояний объекта может находить свое отражение в изменении условиях, а те будут задавать тот или иной сценарий обработки сообщений. Введены также псевдопеременные: sender (№1 на Илл. 2) - идентифицирует объект, пославший сообщение; упоминавшаяся уже inner (№4 на Илл. 2) - ядро, т.е. собственно реализация той или иной совокупности сервисов; self - означает то же самое, что и self в Samlltalk или this в C++ - ссылка на сам объект в теле программного кода, принадлежащего этому объекту; message (№5) - метаданные, т.е. имя сообщения и список аргументов; server (№2) - объект, который первым принял сообщение. В приведенном выше примере сервером является объект objA. Если бы objA в свою очередь был бы включен в интерфейсную часть объекта objX (неважно, где бы он был объявлен - в секции internals или externals), то сервером стал бы objX. Сообщение, проходя через множество фильтров, может много раз поменять "направление", однако значение server не изменится. Данная псевдопеременная помогает объекту разобраться, в каком контекcте он получает сообщение. Например, public и private, реализованные в C++, легко воспроизводятся с использованием server.
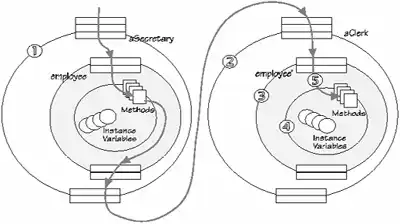
Илл. 2.
CFOM позволяет описать как статические свойства объекта, так и динамически изменить их. Во всяком случае self и inner могут быть статически связаны компилятором, а sender и server - в том случае, если они представлены константами. CFOM представлена языком Sina (по имени Ибн Сины), а тот, в свою очередь, реализован в рамках среды Smalltalk. Между тем, ничто не мешает использовать CFOM как метод моделирования. Метамодель CFOM в принципе может быть представлена средствами другой ОО модели, и выбрав CASE пакет, позволяющий писать скрипты для обработки метаданных, например, Rational Rose (методы Booch, OMT, UML) или ParadigmPlus (компания Platinum - Booch, OMT, UML, Fusion, Shlaer/Mellor, Martin/Odell OOIE, Coad/Yourdon), можно искусственно расширить оную, "другую", модель средствами CFOM (вот только готовы ли вы отказаться от наследования?).
Чем так удивительно хороша CFOM? Тем, что она позволяет изолировать друг от друга вещи несвязанные, и которые, тем не менее, оказываются поневоле перемешаны в одном и том же программном коде. Ядро в CFOM - это суть объекта, то, что он делает, все его прикладное наполнение, если угодно - бизнес-логика. Все остальное вынесено вовне: коммуникации между объектами, делегирование (читай - диалоги) выполнения тех или иных функций внешнему, в том числе и удаленному объекту, синхронизация и обеспечение конкурентного режима, динамическое преобразование сообщений и множественные представления (view). Поясним это на примерах:
Начнем с последнего - в зависимости от условий (conditions), а также от того, какой именно объект (sender) посылает запросы, принимающая сторона может в простейшем случае открывать или закрывать те или иные слоты, а в случае более сложном - динамически изменять цепочку обработки сообщения. Здесь вам и разграничение прав доступа, и базы данных, и модная ныне тема - деловые процессы (они же документооборот).
Необходимо заставить объект objB посылать сообщение не локальному внешнему объекту objC (класс C), а такому же, но удаленному, objCRemote. Включив objB в objA и задействуя в последнем фильтрацию исходящих сообщений, вы, не изменяя кода objB, организуете распределенные вычисления.
Объект objCRemote (напоминаю - класса C) может обслужить одновременно не более одного обращающегося к нему по сети клиента. Рассмотрим объект objM, принимающий все предназначенные objCRemote сообщения, организующего одну или множество очередей запросов и передающего эти запросы одному или нескольким объектам класса C. В результате будет обеспечен либо последовательный доступ к сервису класса C (множество клиентов - один экземпляр класса C), либо параллельный (каждому клиенту - собственный экземпляр), либо смешанный (экземпляров меньше, чем клиентов, запросы буферизуются).
Все посылаемые сообщения предварительно протоколируются
Необходимость изменения любого из аспектов - параллелизм, синхронизация, сценарий, замена локального вызова на удаленный - требует изменения лишь локального участка модели или кода, остальные не затрагиваются. Между тем, если вы пишете на Ada, то прикладная логика перемешана с логикой распараллеливания и синхронизации. А если вам захочется переписать программу на предмет возможности использования DCE/RPC, то заранее примите мои соболезнования.
Ну а мониторы-то тут причем? Или автор пытается подражать О'Генри - ни королей, ни капусты в романе, зато в заголовке - пожалуйста. На самом деле самые внимательные уже смогли найти в капусте (ОО методы) королей (мониторы). Вернемся к примерам 3 и 4. Что такое objM, который принимает от клиентов, протоколирует, буферизует и перенаправляет запросы? Что он, скажите мне, как не монитор транзакций?
И, коль скоро в теме заявлены современные мониторы, то нельзя не вспомнить о предельно современном, а именно - еще в "Памперсах" разгуливающем Microsoft Transaction Server (MTS). Начнем с того, что MTS целиком базируется на архитектуре COM - до удивления близкой рассмотренной выше CFOM (и там, и там расширение возможностей класса осуществляется посредством включения и делегирования - см. выше). MTS является, конечно, не моделью и не ОО методом, а реализацией вполне конкретного подхода. В то же время реализация эта весьма близка к той модели о которой мы говорили, и к тому же выводит наиболее массовую на нынешний момент технологию создания программных компонентов на новый уровень возможностей. Рассмотрим лишь некоторые из фрагментов архитектуры MTS.
Application Component (AC) сосредотачивает в себе прикладную логику. Его смело можно уподобить ядру объекта в CFOM. Ничего относящегося к распараллеливанию, опросу ресурсов и т.д. здесь нет. Пользуясь любым инструментом, позволяющим делать ActiveX компоненты, разработчик создает AC такой же, как и для однопользовательского локального приложения - все проблемы, не связанные с собственно бизнес-логикой, берет на себя монитор транзакций. Приложение, управляемое MTS, может работать с разными видами ресурсов, различаются два вида последних: Resource Managers (RM) и Resource Dispensers (RD). Разница в том, что RM устойчив к сбоям (последняя буква в ACID - atomicity, consistency, isolation, durability), а RD - не дает никаких гарантий, т.е. это ресурс "вообще". В качестве интерфейса к ресурсам MTS использует все тот же OLE.
Похожую концепцию предлагают и другие мониторы, такие как IBM Transaction Server и NCR TopEnd. Начнем с TopEnd. Созданный компанией NCR (изначально - под другим названием) и радикально переработанный где-то в 91-м, компанией, которая трудится с 60-х, и разные мониторы которой стоят на 40000 серверов, TopEnd учитывает сложившиеся реалии: клиент-сервер и графические станции - с одной стороны, а неуничтожимые мейнфреймы, терминалы и DOS - с другой. TopEnd предлагает два вида серверов - managed server (MS) и standard server (SS). SS служит исключительно целям поддержки процесса переноса уже имеющегося сервера приложений, разработанного каким-либо иным способом, на монитор TopEnd. Работать с SS - занятие достаточно утомительное, поскольку распараллеливанием обслуживания запросов в этом случае занимается сам программист. Другое дело MS - ведь он же "managed", т.е. его выполнением управляет сам монитор. MS выглядит практически так же, как и любая другая функция, написанная на C. Он подключается к TopEnd, и всей его дальнейшей жизнью управляют двое - TopEnd и администратор системы.
IBM Transaction Server двуглав, как российский герб. С одной стороны это Encina, монитор, также разработанный в начале 90-х компанией Transarc (являющейся теперь частью IBM) и реализующий архитектуру OSF/DCE. С другой стороны это CICS, известный монитор IBM, установленный на 70000 серверов и мейнфреймов. Если добавить сюда IMS-TP, TPF и Encina, то дух захватывает от числа инсталляций у IBM. Transaction Server базируется на сервисах и ядре Encina, обеспечивая в то же время и совместимость с CICS. В любом случае разработчику доступны и CICS, и Encina в "чистом виде". Encina работает с любым XA ресурсом, но не только. Например, входящая в базовый набор структурированная файловая система (SFS) не является XA ресурсом. SFS представляет из себя некоторую комбинацию DCE файловой системы с ISAM. Немного отклоняясь в сторону, скажу, что перенос наработок с Fox, Clipper, Paradox, Btreive на Encina и SFS существенно проще, чем на реляционный сервер БД. Encina и Microsoft оказываются в некотором смысле даже ближе , чем можно ожидать. В Encina используется язык описания интерфейсов (IDL), принятый в OSF/DCE при работе с удаленным вызовом процедур (RPC). Microsoft реализовал DCE/RPC в самой первой версии Windows NT, и IDL, используемый при описании COM интерфейсов (отчасти и CORBA IDL) более, чем близок к DCE/RPC IDL. Таким образом, некий набор сервисов рассматривается в Encina как целое, как интерфейс, и несложно показать, как увязать технику программирования данного монитора транзакций с ОО подходом CFOM (возможно, и каким-либо еще). В TopEnd нет понятия интерфейса, однако сервисы тоже не рассыпаны сами по себе. Существуют по сути очень близкое понятие product - совокупность сервисов (функций), помимо этого - function (например, "оформить билет") и function qualifier. Квалификатор функции - не более, чем номер, однако вносит особый шарм. Как оформление билета, так и продажа фунта изюму со склада и т.д. - операция, занимающая не один шаг. Наличие квалификаторов позволяет не создавать на каждый из них по собственной функции, а поделить на шаги единственную.
Итак, оставим в стороне разговоры о производительности и надежности - мониторы транзакций упрощают жизнь разработчику. Я ненамного перегну палку, если скажу, что человек, приступающий к созданию банковской, складской, бухгалтерской и т.д. задачи думает о ее функциональности, а не о том, как она будет работать в сети. То есть он пишет однопользовательскую по сути программу. В результате она прекрасно работает для, скажем, трех пользователей. А вот потом начинаются проблемы. Серьезным образом переработать приложение не удается, потому что параллельно с решением задачи производительности обычно требуется и доводить логику. Мониторы же (как минимум - рассмотренные выше) позволяют вынести все эти заботы на администратора системы. Мне как-то подсказали интересную аналогию - программирование для Windows. В одном случае вы должны писать WinMain и т.д., самостоятельно обрабатывать входящие сообщения. Используя же Delphi, VB, PowerBuilder или специально разработанную библиотеку C/C++ вы будете создавать обработчики событий (причем только тех, которые вас интересуют), не заботясь о том, откуда они берутся. Очень похоже
Серверы баз данных со всем справляются сами? Не думаю. Даже с мониторингом собственных ресурсов. Существует (и неплохо) компания Platinum, поставляющая, нет не мониторы транзакций, а утилиты для серверов БД, которые делают, казалось бы, все то же самое, что и штатные средства. Но при ближайшем рассмотрении оказывается, что не то: мониторинг более глубокий, статистика более детальная (как, например, насчет того, чтобы увидеть в реальном времени, что происходит в журнале транзакций?); средства администрирования глубже; наконец, то, чего просто нет у самого производителя СУБД. А даже сравнивая между собой только мониторы, которые, казалось бы, делают одно и то же, выясняешь, сколь по-разному можно это делать. О сравнении с СУБД и говорить нечего. Есть серверы БД, отводящие на каждое подсоединение 50КБ, есть те, что отводят 250КБ, а есть и такие, что отдают по 2МБ - так с каким сравнивать? Есть и ограничения, которые не слишком о себе заявляют, пока речь идет о централизованной задаче, например, пространство имен. О Microsoft TS говорить до появления Cairo преждевременно, но о других можно. TopEnd предлагает единое (вся сеть - один домен) глобальное пространство имен - вы обращаетесь к сервису, не зная, на каком сервере он "хранится" и будет выполняться. Encina интегрирована со службой каталогов DCE - CDS и позволяет, в случае необходимости разбивать сеть на ячейки, однако и в этом случае речь идет об именах, а не о "месторасположении сервиса". В случае РСУБД мы имеем нечто похожее на "имя_сервера.имя_базы(или схемы).имя_владельца.имя_таблицы(или хранимой процедуры". Репликация процедур смягчает, но не снимает эту проблему, а она о себе непременно заявит в большой и распределенной задаче.
Еще пример, связанный со временем жизни приложения. В связи с новым постановлением изменяется порядок расчетов (начисления и т.д.) чего-нибудь. Транзакции, начинающиеся с 1 апреля, проходят по новой схеме. В то же время начатые раньше этой даты, завершаются по старой. В этом случае до завершения всех "старых" транзакций, вы имеете дело с разными версиями сервиса, а не с разным сервисом. Имея доступ к метаинформации , конкретно - о дате посылки сообщения, начала транзакции и т.д., вы сможете решить эту проблему достаточно безболезненно. Имеете ли вы такую возможность в РСУБД? Или вам придется, чертыхаясь, срочно переделывать приложение и сопровождать его в этом виде в течение времени завершения всех "старых" транзакций. А потом, холодея, вы будете ждать нового изменения? А можете ли вы управлять на программном уровне общей памятью? А как насчет разграничения доступа - в Encina, например, реализовано 6 уровней плюс седьмой, если в системе установлена среда DCE. Плюс шифрация, включая использование собственных алгоритмов. Итак - пока РСУБД не будут решать соответствующие вопросы (не "для галочки", а на деле), говорить о том, что они "лучше" мониторов транзакций, рановато.
Еще один вопрос - "другие" средства middleware, "делающие ненужными мониторы". Во-первых, это появляющиеся в новых версиях пакетов для разработки front-end программ средства создания серверов приложений. Эта альтернатива действительно интересна, но не выше уровня рабочей группы. В дополнение к перечисленным выше ограничениям здесь мы не видим поддержки безотказной работы и балансировки нагрузки. По поводу серверов приложений в архитектуре CORBA можно сказать одно - сама по себе эта архитектура не является альтернативой, напротив - требует наличия монитора (как минимум, в виде соответствующих сервисов), но только на этот раз - CORBA совместимого. Хорошим примером является Microsoft - владея полностью технологией COM (OLE), компания почему-то создает именно монитор транзакций. Ну а Encina работает с SOM (реализация CORBA от IBM).
В числе других "убийц" чаще всего называют ПО передачи сообщений. Так вот MOM (message -oriented middleware) не предоставляет технологии создания серверов приложений - речь идет только о гарантированной доставке сообщений, доставке в оговоренный интервал времени, частичной поддержке транзакций. Но кто (что) укладывает сообщения в очереди и кто занимается их выборкой - это вне компетенции MOM. Оно либо должно быть внедрено в СУБД, монитор транзакций и т.п., либо работать совместно с ними или какими-либо другими серверами приложений. Есть примеры и того, и другого - опция Recoverable Queuing System (RQS) для TopEnd, и Recoverable Transaction Queuing (RTQ) - неотъемлемая часть Encina. RTQ и RQS обеспечивают отложенное выполнение запроса. Компания IBM поставляет MQSeries - в чистом виде MOM - наверное, чтобы убить Encina. Ну, а если всерьез, то MQS чаще всего служит для связывания между собой разных мониторов или иных серверов приложений. TopEnd никогда не будет работать с RTQ, а Encina - с RQS. А MQSeries, являясь с точки зрения монитора транзакций XA-ресурсом, может их объединить, "приклеив" также Lotus Notes, приложение, разработанное на Distributed PowerBuilder или Distributed Visual Basic. После появления MQS для Windows'95 речь уже заходит о поддержке мобильных клиентов (мониторы этого не могут). MQS поддерживает собственные транзакции, однако распределенные, вовлекающими несколько узлов - нет, и в роли координатора может выступать монитор. Таким образом, MQS может быть существенным подспорьем монитору в плане поддержки отложенного, асинхронного в полном смысле, выполнения (отложенного - не обязательно на послезавтра, речь может идти и о десятой доле секунды) как между сервером и сервером, так и между клиентом и сервером. MQS может использоваться в качестве интегрирующей среды между другими классами серверов приложений. Однако альтернативой мониторам транзакций MOM не является, что подтверждается простым сравнением функционального набора того и другого.
Таким образом, мониторы транзакций живы и, судя по всему, будут жить, пусть даже и в другом обличье. Мониторы транзакций являются не только средством поддержки, мониторинга и администрирования времени выполнения. Современные мониторы транзакций предоставляют очень надежную (с точки зрения технологии программирования) платформу разработки приложений. Проблема в том, для приложений из 5 экранных форм сказывается непривычность. А вот выигрыш сказывается позже и в по-настоящему сложных системах. Данная платформа разработки не является объектно-ориентированной в общепринятом смысле - нет речи о классах и наследовании. Однако она перекликается с наиболее продуманными ОО методами. Она близка последним не по букве, но по духу. В конечном итоге это и является главным, так как и многочисленные создатели ОО методологии, и создатели мониторов транзакций пытаются решить проблему создания приложений функционально сложных, распределенных, разнородных и сохраняющих свою жизнеспособность в течение долгого времени.
ВЕСТЬ АО 115446, Москва, Коломенский проезд,1а тел: (095) 115-6001, факс: (095) 112-2333 www.vest.msk.ru.
©Drkb::02455.
| Объекты и TRegistry. |
Кто-нибудь знает, как сохранить общие настройки шрифтов моей формы/пенели/списка и пр. пр. в регистрах; конечно, можно легко обойтись построчным сохранением, но, к примеру, в случае сохранения свойств шрифтов количество строк выйдет за пределы разумного - кто нибудь может подсказать мне решение покороче и полегче?
Delphi имеет маленький секрет, позволяющий рекурсивно сохранять в регистрах любые публичные свойства объектов. В качестве примера покажем как это работает для TFont.
| Рисунки и другие объекты MS Word. |
Используя доступ к Word.Application из приложений Delphi, можно вставлять в текст документа записи, рисунки и другие объекты. Сложные документы в формате Word обычно могут содержать не только таблицы или текст, но также записи, линии и фигуры, объекты WordArt, рисунки, графику и многое другое.
Все эти объекты можно разделить на две группы: те, которые являются внутренними объектами Word, и внешние объекты, создаваемые внешними по отношению к самому Word серверами OLE. Все объекты, рассмотренные в 1-4 части статьи, - это внутренние объекты.
Кто программирует в Visual Basic в среде Word и в Delphi, тот может дальше сам развивать тему "Суперфункций". Все просто. Объекты, коллекции и методы, которые работают в среде Word, переносятся почти без изменений в среду Delphi. Главное здесь - применить немного изобретательности и находчивости. Можно использовать палитру компонентов Servers, которая есть в Delphi, начиная с 5-й версии. Выбор между готовыми компонентами и работой "напрямую" с Word.Application зависит от профессионализма, сложности поставленных задач, отпущенного времени и главное - от вкусов и стиля программирования. Это индивидуально для каждого, кто занимается разработкой сложных и не очень сложных приложений на Delphi и других языках программирования. Я свой выбор остановил на работе с Word.Application, так как это дает больше гибкости и возможностей при решении сложных и нестандартных задач
Рассмотрим еще несколько необходимых внутренних и использование некоторых внешних объектов, их создание и управление из приложений на Delphi.
Одним из часто используемых объектов является Textbox. Для его создания используем коллекцию Shapes(формы) и ее метод AddTextbox. Объект коллекции Shapes имеет атрибут - имя, его можно считать, можно изменить и обращаться к объекту не только через индекс, но и через имя. В функцию создания объекта Textbox передаем в качестве аргументов координаты и размеры области, а возвращаем имя объекта. Она выглядит следующим образом.
Code: Function CreateTextBox (Left,Top,Width,Height:real; Var name:string):boolean; Const msoTextOrientationHorizontal=1; Begin. CreateTextBox:=true; Try. Name:=W.ActiveDocument.Shapes.AddTextbox. (msoTextOrientationHorizontal,Left,Top,Width,Height).Name; Except. CreateTextBox:=false; End; End;
Не устанавливается цвет панели.
| Не устанавливается цвет панели |
Code: Unit Unit1; {©Drkb v.3(2007): www.drkb.ru}. Interface. Uses. Windows, Messages, SysUtils, Variants, Classes, Graphics, Controls, Forms, Dialogs, ExtCtrls, XPMan; Type. TForm1 = class(TForm). Panel1: TPanel; XPManifest: TXPManifest; Procedure FormCreate(Sender: TObject); End; Var. Form1: TForm1; Implementation. {$R *.dfm}. Uses. Themes; Type. TMyPanel = class(TPanel). Public. Constructor Create(AOwner: TComponent); override; End; { TMyPanel }. Constructor TMyPanel.Create(AOwner: TComponent); Begin. Inherited Create(AOwner); If ThemeServices.ThemesEnabled then. ControlStyle := ControlStyle - [csParentBackground] + [csOpaque]; End; Procedure TForm1.FormCreate(Sender: TObject); Var. R: TRect; Begin. With TMyPanel.Create(Self) do. Begin. Parent := Self; Color := clGreen; R := Panel1.BoundsRect; R.Left := R.Left + 300; R.Right := R.Right + 300; BoundsRect := R; End; End; End.
Автор: Smike.
Взято из http://forum.sources.ru.
Можно отключать стили XP и для отдельных контролов (темы должны быть включены и манифест лежать на форме):
Code: Unit Unit1; {©Drkb v.3(2007): www.drkb.ru}. Interface. Uses. Windows, Messages, SysUtils, Variants, Classes, Graphics, Controls, Forms, Dialogs, ExtCtrls, StdCtrls, ComCtrls, XPMan; Type. TForm1 = class(TForm). Button1: TButton; Button2: TButton; Button3: TButton; Button4: TButton; Button5: TButton; XPManifest1: TXPManifest; Procedure FormCreate(Sender: TObject); Private. Procedure Unload2Themes(var M:TMSG); message WM_USER+1; Public. { Public declarations }. End; Var. Form1: TForm1; Implementation. {$R *.dfm}. Function SetWindowTheme(hwnd: HWND; pszSubAppName: LPCWSTR; PszSubIdList: LPCWSTR): HRESULT; stdcall; external 'uxtheme.dll'; Procedure TForm1.Unload2Themes(var M: TMSG); Begin. SetWindowTheme(Button4.Handle, ' ', ' '); SetWindowTheme(Button5.Handle, ' ', ' '); SetWindowTheme(Form1.Handle, ' ', ' '); End; Procedure TForm1.FormCreate(Sender: TObject); Begin. PostMessage(Handle,WM_USER+1,0,0). End; End.
Автор: Krid.
Взято из http://forum.sources.ru.
©Drkb::00590.
| ICQ2000 - сделай сам (статья). |
Автор: Alexander Vaga.
WEB-сайт: http://icq2000cc.hobi.ru.
Урок №1.
Прежде чем приступить к изложению своего небольшого проектика ... скажу сразу…. написан он на Делфи. Кто огорчится , кто обрадуется. Для кого языковой барьер не помеха, а для кого непреодолимое препятствие. Лично я постигал все перелести протоколов ICQ на кодах написанных на С++. Главное - видеть "главное". А мне нравится Делфи. На нем отправить пакет данных в интернет наверное проще, чем записать его в обычный файл.
Самые общие сведения о протоколахм ICQ.
Существует около десятка версий ICQ-клиентов. И у каждого - своя версия протокола. Но не смотря на это, их всего два. Есть ICQ, работа, которых с сервером основана на протоколе UDP, и есть ICQ общающиеся с сервером по протоколу TCP. Немного подробнее:
ICQ на протоколе UDP.
С нее, собственно, и начиналась история ICQ.
Это были версии протоколов 1,2,3,4 и 5. Это были аськи ICQ97, ICQ98, ICQ99. Т.к. использован протокол UDP, то постоянного соединения клиент-сервер не существует. Пакет передал. Получил подтверждение, и баста. Не получил подтверждение - передай повторно.
Но об этих протоколах уже можно (и нужно) забыть. Они поддерживаются сервером весьма неохотно, потому, что в какой-то момент компания Mirabilis растворилась в компании America OnLine (AOL). После этого ICQ начала работать на протоколе AOL Instant Messenger (AIM). Это и есть вторая группа протоколов ICQ.
ICQ на протоколе TCP.
Это версии протоколов 7,8. А может уже и 9,10,11 и т.д.
По сути дела в ICQ20xx используется протокол от AOL Inastant Messenger. И по этому признаку эти два продукта - родные братья. Хоть я и спользовал информацию по прортоколу v8 (ICQ2000b) но рассматривать буду протокол v7 (ICQ2000a). Потому, что эта версия у меня была установлена и именно ее пакеты я использовал для анализа и отладки своего детища. Это различие не имело ровным счетом никакого значения.
Но, как говорится: "ближе к телу".
Вы вправе задать вопрос: "Как же это все будет выглядеть?".
Это выглядит примерно так.
Сами понимаете, что номера ICQ и имена клиентов - полностью вымышленные. Любые совпадения с реальными людьми - чистая случайность. Конечно же, изображения принадлежат своим уважаемым владельцам, поэтому дальше их и не будет.
Как видно на скриншоте, это не просто аська, а - мультиаська! Т.е. можно находиться в онлайне сразу под несколькими UIN-ами одновременно. Иногда это бывает полезно и даже необходимо. В интернете есть конечно примочки для одновременного запуска нескольких копий ICQ, но ничто так не умиляет, как сделанное своими руками. И все же для понимания работы протокола - это излишество, поэтому я оставил только самое необходимое.
Думаю, что не стоит в самом начале нагружать разными сводными таблицами с описанием пакетов протокола. Я буду делать это по мере необходимости. Тем более, что из всего их множества, поначалу не все они будут и нужны.
Для работы вам потребуются только стандартные компоненты Делфи-5. Нет нужды устанавливать какие-то вспомогательные библиотеки или пакеты.
С помощью моего ICQ-клиента можно:
Логиниться к серверу;
Отображать состояние клиентов;
Передавать и принимать сообщения;
Регистрировать (register) новый UIN на сервере;
Удалять (unregister) UIN с сервера;
Просматривать и обновлять информацию о клиентах из контактного списка;
Производить поиск клиентов по имени, по e-mail, по UIN-у;
Включать найденных клиентов в контактный список;
Вести журнал сообщений и пакетов.
Но изначально приложение будет иметь самую минимальную функциональность. UIN и пароль у вас уже должны быть. Будем логиниться на сервере, менять свой статус, принимать сообщения. Весь TCP-трафик идет только через сервер. Так проще и этот способ в комбинации с некоторыми другими параметрами позволит скрыть ваш IP-адрес от любопытных глаз. Наверное, поэтому я не рассматриваю прямые соединения между клиентами. Разумеется, что будем рассматривать протокол v7. На нем работает ICQ2000a.
Итак, приступим...
Все пакеты данных (и от клиента к серверу, и от сервера к клиенту) упаковываются в т.н. FLAP-протокол. Он находится в самом низу иерархии. Ниже показана структура FLAP-пакета:
FLAP.
Command Start byte: $2A.
Channel ID byte.
Sequence Number word.
Data Field Length word.
Data variable.
Каждый FLAP-пакет имеет заголовок c фиксированной длиной и, следующий за ним блок данных (переменной длины). Длина заголовка равна 6-и байтам.
FLAP-заголовок содержит такие поля:
Однобайтовый идентификатор начала пакета (Command Start). Его значение всегда равно $2A. С ним можно сверяться при приеме пакетов.
Идентификатор канала (Channel ID). Он может принимать четыре значения:
1 - канал установления соединения;
2 - канал обмена данными (основная фаза работы: какие-либо полезные данные передаются только в этой фазе);
3 - канал ошибок. (на практике мне не попадался :);
4 - канал разъединения. (это проще, чем написано).
На 99.9% времени протокол работает в канале 2.
Последовательный номер пакета (Sequence Number). В начале обмена данными это поле устанавливается случайным образом, а затем увеличивается на единицу при передаче каждого последующего пакета. Обычно такие поля используются для обеспечения целостности данных (например, когда используется UDP-протокол). Но в нашем случае используется TCP-соединение и этого вполне достаточно для обеспечения целостности передаваемых пакетов. Просто нужно следовать правилу формирования этого поля при передаче пакетов и можно забыть о нем. (На приеме я его никак не контролировал).
Длина блока данных (Data Field Length). Указывает на длину блока данных, который следует сразу же за заголовком. Это очень важное поле. Зная его, мы знаем сколько данных нужно прочитать из входного потока. Ошибись мы хоть на один байт и синхронизация потока будет нарушена.
Блок данных FLAP-пакета. Его длина указана в FLAP-заголовке. В нем находится вся полезная информация для обмена ICQ-клиента и сервера.
При приеме (обработке) FLAP-пакетов очень важно не потерять синхронизацию пакетов ( что просто недопустимо ). Нужно всегда читать 6-и байтовый залоговок, а далее считывать только, то количество данных, которое указано в заголовке. При соблюдении этого правила можно быть уверенным, что прочитанный блок данных будет содержать достоверную информацию. Потеря данных неприемлема в AIM стандарте. Все это на самом деле не трудно обеспечить.
Труднее разобраться в структуре самого блока данных. А напичкан он весьма разнообразными структурными единицами. Видать оччень много народу постаралось для этого. Впечатление такое, что взяли и скрестили старые версии v2 - v5 ICQ-протокола с самим AIM-протоколом. Это вам еще предстоит увидеть. Вот например, для представления обычных текстовых строк , использовано 3 или 4 различных варианта. Представляете себе строку в формате C++ или в формате Pascal, с нулем в конце или без него, с однобайтовой длиной или двубайтовой, а порядок следования байтов в слове? Черт ногу сломает. А может это специально сделано? Мне кажется, что впопыхах!!!
Попробуем разобраться.
Делфи-проект nICQ в начале будет состоять из 3-х модулей: Types, Packet, Main.
В модуле Types находятся константы и объявлены некоторые записи.
В модуле Packet - процедуры и функции для записи/чтения FLAP-пакетов.(Большинство процедур из этого модуля просто адаптированы из других проектов ICQ).
Название модуля Main говорит само за себя.
До того, как начать тестирование, вам следует ввести свой UIN, password, NickName. Внесите эти данные в файл nICQ.ini:
[User].
Uin=199222333.
Nick=My Nick.
Password=mypass.
... и можно запускать. Список контактов нам пока не нужен. Он появится позже. А сейчас будет вполне достаточно, если список контактов будет состоять только из вашего собственного UINа. Жмем на единственную кнопку, а в отладочном окне будет отображаться протокол работы. При выборе одного из пунктов Popup-меню, вызывается процедура icq_Login. Что в ней? Смотрим:
Code: Procedure TForm1.icq_Login(Status : longint); Begin. // определяем свой IP-адрес. Local_IP := Get_my_IP; // преобразуем его в DIM_IP. StrToIP(Local_IP,DIM_IP); // Запоминаем, какой будет наш статус. ICQStatus := Status; // если ClientSocket открыт, то закроем его. If CLI.Active then. CLI.Close; // установим флажок isAuth, // это значит, что сначала мы коннектимся к серверу. // авторизации. UIN и пароль передаются именно ему. IsAuth := true; // устанавливаем флажок isHDR, // он говорит нам о том, что, самые первые данные , // из ClientSocket следует интерпретировать как. // FLAP-заголовок. IsHDR := true; // заполняем поля Host и Port в ClintSocket, // адрес сервера авторизации: 'login.icq.com' // и его порт: 5190. CLI.Address :=''; CLI.Host := 'login.icq.com'; CLI.Port := 5190; // не забываем и про TMemo. M(Memo,'>>>>>>>>>> login.icq.com:5190 <<<<<<<<<<<'); // ... и собственно CONNECT. CLI.Open; End;
(А вот и подходящий момент, чтобы вспомнить о вашем подключении к интернету. Проблемы с получением CONNECTa могут возникнуть, если вы выходите в интернет из LAN через PROXY-сервер. Все зависит от того, как он настроен. Если он предоставляет выход в интернет только для основных сервисов (http,ftp,smtp,pop), то тут уж извините. А если на нем присутствует нормальный маскарадинг, то все будет OK).
Итак, что же дальше..? Желанный CONNECT должен наступить немного раньше конца света :) Мы подсоединились к серверу авторизации и он первым выдаст нам пакет данных. Что делать? Как принять? Куда его засунуть? Об этом мой расказ на следующей странице.
Итак, рассмотрим механизм приема FLAP-пакетов. Прием пакетов - это обработчик события onReadData нашего ClientSocket. Задача этого обработчика сводится только к приему FLAP-пакетов и формировании из них связного списка типа FIFO (первым пришел, первым и ушел). Главное корректно отработать границы пакетов.
Каждый пакет принимается в два захода:
Сначала принимаем только заголовок FLAP-пакета (всего 6 байт);
Затем, узнав из заголовка длину блока данных, принимаем последний (ни байтом больше, ни байтом меньше).
Приняв полный пакет, формируем из него элемент списка FIFO и присоединяем его к списку. Смотрим, как это сделано у меня. Для прима заголовка и блока данных FLAP-пакета объявлены два массива: FLAP и FLAP_DATA соответственно.
Code: Procedure TForm1.CLI_ReadData(Sender:TObject; Socket:TCustomWinSocket); Var num,Bytes,fact : integer; PFIFO,CurrFIFO : PFLAP_Item; Buf : array[0..100] of byte; Begin. // узнаем, сколько всего данных уже есть в буфере ClientSocketa. Num := Socket.ReceiveLength; // в icq_Login мы установили isHdr, т.к. сначала ожидаем заголовок. If isHDR then begin. // если есть как минимум 6 байт, то читаем 6 байт заголовка в FLAP. If num>=6 then begin. Socket.ReceiveBuf(FLAP,6); // из заголовка узнаем длину блока данных FLAP-пакета. NeedBytes := swap(FLAP.Len); // сбрасываем в начало индекс массива FLAP_DATA. Index := 0; // сбпасываем, чтобы следующее чтение было в FLAP_DATA. // и выходим из обработчика. IsHDR := false; End else begin. // вообще-то ситуация, когда в Sockete меньше 6-и байт. // пока никак не контролируется (возникает очень редко :). // отмечаю этот факт только в окне отладки. M(Memo,'!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!'); Socket.ReceiveBuf(buf,num); M(Memo,Dim2Hex(@(buf),num)); M(Memo,'!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!'); End; // if not isHDR then чтение в FLAP_DATA. End else begin. // сколько байт читать уже известно: NeedBytes. Bytes := NeedBytes; // читаем их в FLAP_DATA[Index]. Fact := Socket.ReceiveBuf(FLAP_DATA[index],Bytes); // если в Sockete было данных меньше чем нужно, // педвинем Index и NeedBytes для следующего входа в обработчик. Inc(index,fact); Dec(NeedBytes,fact); If NeedBytes = 0 then begin. // если весь блок данных FLAP-пакета уже в FLAP_DATA, // тогда выделаем память для элемента списка FIFO (PFLAP_Item). New(pFIFO); // копируем заголовок. PFIFO^.FLAP := FLAP; PFIFO^.Next := nil; // выделяем память для блока данных и копируем его. GetMem(pFIFO^.DATA,index); Move(FLAP_DATA,PFIFO^.Data^,swap(FLAP.Len)); // добавляем указатель на PFLAP_Item в список. CurrFIFO:=HeadFIFO; If HeadFIFO<>nil then begin. While CurrFIFO<>nil do. If CurrFIFO^.Next=nil then begin. CurrFIFO^.Next:=pFIFO; Break; End else CurrFIFO:=CurrFIFO^.Next; End else HeadFIFO:=pFIFO; // устанавливаем isHDR (в true) уже для прима заголовка. // последующих FLAP-пакетов. IsHDR := true; End; End; End;
Дальнейшая обработка списка FIFO - это задача уже другой процедуры.
Итак, в обработчике события ClientSocket.onRead_Data из FLAP-пакетов формируется список FIFO. Обработку этого списка производит таймерная процедура MainT. Ее задача заключается в следующем:
Взять из очереди FLAP-пакет (если очередь не пуста);
Сформировать из него временный объект (запись) типа PPack. (Для его обработки в модуле Packet находятся соответствующие функции и процедуры);
Направить его на вход одного из двух обработчиков;
После обработки удалить временный объект.
Code: Procedure TForm1.MainTTimer(Sender: TObject); Var FindFIFO : PFLAP_Item; Tmp : PPack; Begin. // закроем вход в таймер (реентерабельность нам не нужна). MainT.Enabled := false; // проверим не пуста ли очередь. While HeadFIFO<>nil do begin. // если есть ожидающие пакеты, то берем первый из них. FindFIFO := HeadFIFO; // и корректируем очередь. If HeadFIFO^.Next=nil then HeadFIFO := nil. Else HeadFIFO := HeadFIFO^.Next; // создаем временный Pak. Tmp := PacketNew; // переносим в него данные из пакета очереди. // сначала FLAP-заголовок. PacketAppend(tmp,@FindFIFO^.FLAP,sizeof(FLAP_HDR)); // затем блок данных. PacketAppend(tmp,FindFIFO^.DATA,swap(FindFIFO^.FLAP.Len)); // освобождаем пакет, который из очереди. FreeMem(FindFIFO^.DATA,swap(FindFIFO^.FLAP.Len)); Dispose(FindFIFO); // пропишем его дамп в файл "<твой UIN>.log". DebugFILE(tmp,'< '); // если в данный момент мы соединены с сервером авторизации. If isAuth then. // то напавим пакет в обработчик AuthorizePart. AuthorizePart(tmp). Else. // либо в основной обработчик. WorkPart(tmp); // удалим временный Pak. PacketDelete(tmp); End; // откроем вход в таймер. MainT.Enabled := true; End;
Вполне логично, что дальше надо рассмотреть работу процедуры AuthorizePart, т.к. самый первый FLAP-пакет попадет именно в нее.
Перед рассмотрением работы обработчика AuthorizePart надо немного поговорить и о протоколе.
Перед тем, как подключиться к ICQ-серверу и начать работать мы должны пройти авторизацию на Authorization Server. Его адрес - login.icq.com:5190.
Необходимо:
Соединиться с Authorization Server;
Передать ему пакет с UINом и паролем;
Получить от него IP-адрес и порт основного сервера и Cookie (256 байт случайных данных). Cookie - это будет наш пропуск при последующем (после авторизации) коннекте к основному рабочему серверу;
Разьединиться с Authorization Server.
Именно к Authorization Server инициируется соединение в процедуре icq_Login.
Сервер отвечает нам маленьким пакетом:
FLAP.
Command Start 2A.
Channel ID 01.
Sequence Number XX XX.
Data Field Length 00 04.
Data 00 00 00 01.
В нем только лишь 00 00 00 01. Для нас - это сигнал начать передачу пакета с авторизационными данными (с UINом и паролем).
Сейчас уже пора разобраться и с форматом блока данных FLAP-пакета.
Можно сказать, что показанный выше пакет совсем не имеет никакой структуры: просто DWORD и все. В большинстве случаев в FLAP-пакете размещены данные, которые упакованы еще в один протокол: т.н. SNAC. В этом случае пакет данных выглядит так:
FLAP.
Command Start 2A.
Channel ID 02.
Sequence Number word.
Data Field Length word.
SNAC.
Family ID word.
SubType ID word.
Flags[0] byte.
Flags[1] byte.
Request ID dword.
SNAC Data variable.
SNAC.
SNAC - это обычное содержимое блока данных FLAP-пакета в основной рабочей фазе соединения. Т.е. SNАСи посылаются только через Сhаnnе1 ID = 2.
В любом FLAP-пакете может находиться только один пакет SNAC.
Прием (анализ) и передача SСАСов - это то основное, что предстоит делать, чтобы реализовать все функции ICQ-клиента. Будь то передача списка контактов, или изменение нашего статуса, или получение и передача сообщений, или запрос информации о любом клиенте, для любого запроса и ответа на него есть свой SNAC (FamilyID, SubTypeID). Из сказанного видно, что вся смысловая информация помещена в SNАСи. И UINы, и никнэймы, и и-мэйлы с хоумпэйджами. Конечно же они не просто так накиданы в SNАСи. Они там размещены в юнитах, которые называются TLV.
TLV.
TLV дословно означает - "Type, Length, Value" ("Тип, Длина, Значение"). Его структура такая:
TLV.
(T)ype code word.
(L)ength code word.
(V)alue field variable length.
В TLV упаковывается все, что используется в ICQ-протоколе: текстовые строки, байты, слова, двойные слова, другие массивы и т.д. и т.п.. На тип содеожимого TLV указывает Type code. Чаще всего TLV располагаются внутри SNАСов, но это не является обязательным условием. Они могут также напрямую использоваться в блоке данных FLAP-пакета. Именно напрямую (т.е. без использования SNАСов) TLV задействованы на этапе авторизации.
Этот механизм мы и рассмотрим именно сейчас, т.к. мы соединены уже с Authorization Server и получили от него добро в виде DWORD=00000001 на передачу нашего UINа и пароля.
Code: Procedure TForm1.AuthorizePart(p:PPack); Var ss : string; T : integer; Tmp : PPack; Begin. // позиционируемся на начало блока данных, пропустив заголовок. PacketGoto(p,sizeof(FLAP_HDR)); // если FLAP-данные содержат лишь 00000001, // то это самое начало сессии. If (swap(p^.Len)=4)and. (swap(p^.SNAC.FamilyID)=0)and. (swap(p^.SNAC.SubTypeID)=1) then begin. M(Memo,'< Authorize Server CONNECT'); // каждый раз, когда начинается новая TCP-сессия, // присваиваем SEQ случайное начальное значение. SEQ := random($7FFF); // в ответ надо передать пакет с UINом и паролем. // создаем объект-пакет типа PPack: в нем формируется. // FLAP-заголовок с Chanel_ID=1. Tmp := CreatePacket(1,SEQ); // сначала надо вставить такой же DWORD=00000001. // (еще надо помнить о порядке следования байтов в DWORD !!!). PacketAppend32(tmp,DSwap(1)); // далее в поле данных добавляются несколько TLV. // это наш UIN - TLV(1). TLVAppendStr(tmp,$1,s(UIN)); // и закодированный пароль - TLV(2). TLVAppendStr(tmp,$2,Calc_Pass(PASSWORD)); // описывать содержимое других TLV особого смысла нет. TLVAppendStr(tmp,$3, 'ICQ Inc. - Product of ICQ (TM).2000a.4.31.1.3143.85'); TLVAppendWord(tmp,$16,$010A); TLVAppendWord(tmp,$17,$0004); // 4 - для ICQ2000a. TLVAppendWord(tmp,$18,$001F); TLVAppendWord(tmp,$19,$0001); TLVAppendWord(tmp,$1A,$0C47); TLVAppendDWord(tmp,$14,$00000055); TLVAppendStr(tmp,$0F,'en'); TLVAppendStr(tmp,$0E,'us'); // посылаем пакет через ClientSocket. // (здесь tmp-пакет будет также и удален). PacketSend(tmp); M(Memo,'> Auth Request (Login)'); End else. // на это сервер ответит так: // его ответ содержит TLV(1) - т.е. наш UIN. If (TLVReadStr(p,ss)=1)and(ss=s(UIN))then begin. // если это так, то считаем следующий TLV. T := TLVReadStr(p,ss); Case T of. // если это TLV(5) - значит это адрес и порт основного сервера. 5: g>begin // BOS-IP:PORT. M(Memo,'< Auth Responce (COOKIE)'); // запоминаем и адрес и порт. WorkAddress := copy(ss,1,pos(':',ss)-1); WorkPort := strtoint(copy(ss,pos(':',ss)+1, Length(ss)-pos(':',ss))); // за ними должен быть и TLV(6) - т.н. COOKIE (256 байт). // принимаем его прямо в переменную sCOOKIE. // (он пригодится при коннекте к основному серверу). If (TLVReadStr(p,sCOOKIE)=6) then begin; // COOKIE получен и значит пора разъединяться. // формируем пустой пакет с Channel_ID=4. Tmp:=CreatePacket(4,SEQ); // ChID=4. // который и передаем. PacketSend(tmp); // закрываем свой ClientSocket. OfflineDiscconnect1Click(self); // говорим себе, что авторизация пройдена. IsAuth := false; // настраиваем ClientSocket на адрес:порт. // основного (BOS) сервера. CLI.Address := WorkAddress; CLI.Host := ''; CLI.Port := WorkPort; M(Memo,''); M(Memo,'>>> Connecting to BOS: '+ss); // и коннектимся к нему. CLI.Open; { ******************************************* } { в этом месте заканчивается этап авторизации }. { ******************************************* } End; End; // а, например, в случае неверного UINа или пароля. // мы получим TLV(4) и TLV(8). 4,8: begin. M(Memo,'< Auth ERROR'); M(Memo,'TLV($'+inttohex(T,2)+') ERROR'); M(Memo,'STRING: '+ss); If pos('http://',ss)>0 then begin. // и даже можем загрузить в браузер присланный нам URL. // с описанием ошибки. // Web.Navigate(ss); // {это навигатор с панели компонентов Делфи}. End; TLVReadStr(p,ss); M(Memo,ss); // конечно же закрываем ClientSocket. OfflineDiscconnect1Click(self); M(Memo,''); End; End; End; End;
Эта незнакомая IDE! (статья).
Небольшой список приёмов для эффективной работы.
IDE - интегрированная среда разработки Дельфи. Все хоть чуть чуть соприкасавшиеся с Дельфи знают эту простую и интуитивно понятную среду. Тем ни менее, эта среда имеет огромное количество функций, которые не столь очевидны для пользователя и не очень хорошо документированы. Целью этой статьи является рассказать о некоторых приёмах работы в среде Дельфи, не столь очевидных даже для профессионалов. Описание базируется на Дельфи 7, но подавляющее большинство приёмов будет доступно и в других версиях, как ранних, так и поздних.
Текстовый редактор.
1) Отмеченный блок текста можно сдвинуть вправо или влево нажатием Ctrl-Shift-U или Ctrl-Shift-I - это особенно удобно при форматировании текста, оформлении процедур, циклов и т.п.
2) Отмеченный блок текста можно сохранить в файл непосредственно, минуя стадии создания файла и т.п. Нажмите Ctrl-K и затем W - откроется диалог сохранения файла выберите имя и блок будет сохранён в виде отдельного файла. Вообще-то редактор дельфи берёт начало ещё от очень древнего Word star редактора(речь идёт о начале 80х годов), на базе которого был сделан IDE для Turbo Pascal. В том Wordstar очень многие функции были реализованы через префиксы. Т.е. нажимается какой-то префикс, и потом клавиша функции. Такими префиксами в Дельфи остались Ctrl-K и Ctrl-O - сами по себе эти комбинации ничего не делают, но после их нажатия следующая буква определяет функциональность. Итак Ctrl-K,W - записывают выделенный блок в файл (от слова Write - писать).
3) Содержимое текстового файла можно легко загрузить по месту курсора (вставить в текущий текст) нажав Ctrl-K,R (Read). При нажатии комбинации откроется диалог открытия файла.
4) Переходы на метки. Скорее всего это почти все знают, но тем ни менее. Можно запомнить текущую позицию курсора поставив метку, и потом перейти к метке. Всего меток можно поставить до 10 штук. Метка ставится нажатием Ctrl-Shift+ цифра, переход к поставленной метке по нажатию Ctrl+цифра. Для тех кто в танке: нажмите Ctrl-Shift+1 затем пролистайте текущий файл куда-нибудь вверх или вниз, нажмите Ctrl-1 и курсор перескочит на запомненную позицию.
5) Чтобы открыть в редакторе исходник файла указанный в Uses, поставте курсор на имя модуля и нажмите Ctrl-Enter. Исходник сразу будет открыт в новом окне. Только 2 замечания: во-перывых это не обязательно должно быть имя модуля из uses, редактор будет пробовать открыть любой файл по имени слова над которым стоит курсор, во-вторых IDE должно знать где искать файл, если в списке путей этого файла нет, IDE его не найдёт и просто откроет диалог открытия файла.
6)Вертикальные блоки - очень удобная фишка. Можно выделить вертикальный блок текста и манипулировать им. Для выделения вертикального блока можно воспользоваться клавиатурой: Удерживая Shift и Alt перемещать курсор или мышкой - для этого при выделении мышкой удерживайте Alt нажатым. Для выхода из режима отметки вертикального блока используйте или мышку - выделив что-нибудь без Alt или используя Ctrl+O, K. Ещё один способ перейти в режим выделения вертикальным блоком - это нажать Ctrl+O, C и после этого блоки будут вертикальными при выделении их клавиатурой.
7) Строковые блоки - ещё один вид блоков пришедших из wordstar и сейчас подзабытых. В этом случае редактор выделяет строку целиком, вне зависимости от того где стоит курсор. Иногда удобно. Перейти в режим строкового блока можно комбинацией Ctrl+O, L.
8) Удалить целую строку можно нажав Ctrl-Y, а нажатие Ctrl-T приводит к удалению конца слова (от позиции курсора до конца слова), применение Ctrl+Shift+Y позволяет удалить весь текст от курсора до конца строки.
9) Можно вставить любой символ в текст при помощи Ctrl-P, после нажатия этой комбинации следующий символ с клавиатуры не будет восприниматься как управляющий а будет введен в текст, например Ctrl-P и потом Ctrl-A вставят в текст символ #1.
10) Копирование без буффера обмена. Ещё одна удобная фишка, пришедшая со времён ДОС. Наверное все встречались с ситуацией когда например в буффере обмена лежит название объекта, но чтобы вставить его надо скопировать кусок кода. Если копировать по привычному Ctrl-C/Ctrl-V то предыдущая информация в буффере исчезнет. На этот случай есть 2 удобных приёма. Во первых можно скопировать блок клавиатурой без использования буффера обмена - выделите блок текста, нажмите Ctrl-K, C - блок скопирован, содержимое буффера обмена не пострадало. Второй способ - мышкой: отмечаем блок, удерживая нажатым Ctrl перетаскиваем блок на новое место - блок копируется.
11) Макросы! Редактор Дельфи позволяет запомнить нажатые клавиши и потом произвести точно такую-же последовательность нажатий. Делается это следующим образом. Допустим у нас есть код:
Table1.fieldByName('aaaaa').asString:='чего-то там';
Table1.fieldByName('sdweewr').asString:='чего-то там 1';
Table1.fieldByName('sdfsdfga').asString:='чего-то там2';
Table1.fieldByName('a').asString:='чего-то там 4';
Table1.fieldByName('pyoruw').asString:='чего-то там 5';
Этот код надо заменить на аналогичный, но с использованием параметров, причём добавить ещё переменную v. В конечном итоге мы хотим каждую строку преобразовать в нечто типа:
Table1.params.parambyname('aaaaa').value:='чего-то там'+v;
Если строк очень много то процесс переделки может быть весьма трудоёмкий. Что мы делаем:
- ставим курсор на первую букву первой строки.
- нажимает Ctrl-Shift-R (начать запись макро) с этого момента все нажатия на клавиатуре будут запоминаться, поэтому действуем осторожно чего попало не нажимая:
- нажимаем Ctrl-вправо и удаляем fieldByName.
- печатаем на его место params.parambyname.
- нажимаем Ctrl-вправо пока курсор не станет на asString (просто вправо жать нельзя так как значение имени поля у нас разной длинны в разных строках).
- удаляем asString нажатием delete.
- записываем value.
-нажимаем End и клавишу влево.
- записываем +v.
- теперь нажимаем клавишу вниз и клавишу home - чтобы курсор стал на начало следующей строки.
- нажимает Ctrl-Shift-R- закончить запись макро.
Теперь по нажатию Ctrl-Shift-P редактор будет обрабатывать любую текущую строку так же как и ту над которой работали мы.
12) Быстрый поиск. Нажмите Ctrl-E и начинайте печатать слово которое вы хотите найти - редактор будет искать по мере ввода слова...
13) Чтобы вставить в текст GUID (CLSID) - нажмите Ctrl-Shift-G.
14) Все знают что после точки Дельфи выдаёт список доступных методов и свойств объекта, а как вызвать этот список вручную, если он уже исчез? - нажмите Ctrl-Space. Кстати нажатие Ctrl-Shift-Space приведёт к появлению всплывающей подсказки о параметрах функции или метода, если нажатие произведено когда курсор стоит после скобки, например напишите write( и нажмите Ctrl-Shift-Space - будет выведен hint о параметрах функции.
15) Путём нажатия Ctrl+Shift+Up и Ctrl+Shift+Down можно быстро перейти от тела метода к его объявлению и наоборот. Аесли нажать Ctrl-Shift-C на методе то удет автоматически создано его объявление в классе и наоборот, если есть объявление метода в классе - то будет создан шаблон для его реализации.
16) Если кликнуть на идентификаторе с нажатым Ctrl, то курсор перейдёт на объявление этого идентификатора. А если нажать Ctrl-Shift-B на имени класса, то будет выведена вся иерархия данного класса.
17) Если нажать Ctrl-O, O то по текущему положению курсора будут выведены все опции компилляции установленные для проекта.
18) Можно изменить регистр букв выделенного текста на противоположный нажав Ctrl+O, U, а нажатие Ctrl+K, E приведёт к переводу текущего слова в нижний регистр (Ctrl+K, F - в верхний).
19) Ctrl+O, G позволит вам быстро перейти к строке по её номеру.
20) Alt+[ и Alt+] осуществляют поиск парных скобок, что удобно при сложных выражениях.
Отладчик:
1) Наверное все знают функции трассировки F7/F8, но есть ещё одна - Shift-F7 - она аналогична F7 т.е. трассирует программу с заходом в каждую процедуру, но в дополнении ещё отлавливает и случающиеся события и трассирует их.
2) Ctrl-F3 - вызов стека вызовов функций. Крайне удобная штука - в точке останова можно заглянуть в него и выяснить кто вызывал данную процедуру, увидеть всю цепочку вызовов и быстро перейти к вызывающей функции.
3) Ctrl-F7 - позволяет посмотреть любую переменную, изменить её значение, и даже выполнить какой-нибудь код прямо в процессе отладки. Его же можно использовать и как калькулятор по мере разработки программы. Кстати, если надо просмотреть значение переменной типа TStrings - например memo.lines то не надо писать memo.lines.text - так как при этом текст не будет разбит на строки, пишите memo.lines.gettext - это сделает вывод значения гораздо более читаемым. Кстати есть и ещё одна особенность - при выводе значения TStrings, а так же массивов и т.п. "объёмных" структур просмотрщик выводит только первые несколько килобайт, поэтому не волнуйтесь, если у вас вдруг просмотрщик покажет только кусок значения - это не глюк, это особенность просмотрщика, скомпиллированный код работает правильно.
4) При наличии многочисленных ошибок компилляции можно легко переходить к последующей/предыдущей ошибке нажатием Alt-F8/Alt-F7.
©Drkb::00044.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
| IDEA шифрование |
Автор: Матвеев Игорь
IDE highlighting the incorrect line.
On one project, the IDE insists on highlighting the incorrect line.
For different conditions. For example, when a syntax error is.
Highlighted, the line above the error is highlighted or when I set.
Breakpoints by choosing a blue dot in the gutter, it does not.
"line up" with the text line. How can I fix this?
This condition is usually caused by opening the file in a different.
Editor than the editor provided by the IDE. If a line of code is.
Somehow modified and then saved back to the disk using only a carriage.
Return for a line terminating character (instead of a carriage return.
+ line feed sequence), the IDE may get confused. To fix the problem,
Load the file into an editor that will save each line with a carriage.
Return + line feed sequence.
Примечание от Vit: ошибка исправлена в Дельфи 7.
©Drkb::00007.
| Прибавить час |
Тип TDateTime, используемый для передачи даты и времени, это тип double, у которого целая часть определяет день, а дробная время от полуночи. То есть, если прибавить ко времени 1, то дата изменится на один день, а время не изменится. Если прибавить 0.5, то прибавится 12 часов. Причем этот метод работает даже в том случае, когда меняется дата, месяц или год.
| Плавающая панель |
Кто-нибудь пробовал создать форму, подобную "отстегивающимся" панелькам (FreeDoc)? Я попробовал и вот что получилось...
| Мигание кнопки приложения |
Code: Procedure TForm1.Timer1Timer(Sender: TObject); Begin. FlashWindow(Application.Handle, True); End;
©Drkb::01780.
DelphiWorld 6.0.
| Пирамидальная сортировка |
Итак, мы постепенно переходим от более-менее простых к сложным, но эффективным методам. Пирамидальная сортировка является первым из рассматриваемых методов, быстродействие которых оценивается как O(n log n).
В качестве некоторой прелюдии к основному методу, рассмотрим перевернутую сортировку выбором. Во время прохода, вместо вставки наименьшего элемента в левый конец массива, будем выбирать наибольший элемент, а готовую последовательность строить в правом конце.
Пример действий для массива a[0]... a[7]:
44 55 12 42 94 18 06 67 исходный массив
44 55 12 42 67 18 06 |94 94 <-> 67.
44 55 12 42 06 18 |67 94 67 <-> 06.
44 18 12 42 06 |55 67 94 55 <-> 18.
06 18 12 42 |44 55 67 94 44 <-> 06.
06 18 12 |42 44 55 67 94 42 <-> 42.
06 12 |18 42 44 55 67 94 18 <-> 12.
06 |12 18 42 44 55 67 94 12 <-> 12.
Вертикальной чертой отмечена левая граница уже отсортированной(правой) части массива.
Рассмотрим оценку количества операций подробнее. Всего выполняется n шагов, каждый из которых состоит в выборе наибольшего элемента из последовательности a[0]..a[i] и последующем обмене. Выбор происходит последовательным перебором элементов последовательности, поэтому необходимое на него время: O(n). Итак, n шагов по O(n) каждый - это O(n2).
Произведем усовершенствование: построим структуру данных, позволяющую выбирать максимальный элемент последовательности не за O(n), а за O(logn) времени. Тогда общее быстродействие сортировки будет n*O(logn) = O(n log n).
Эта структура также должна позволять быстро вставлять новые элементы (чтобы быстро ее построить из исходного массива) и удалять максимальный элемент (он будет помещаться в уже отсортированную часть массива - его правый конец).
Итак, назовем пирамидой(Heap) бинарное дерево высоты k, в котором
· все узлы имеют глубину k или k-1 - дерево сбалансированное.
·
при этом уровень k-1 полностью заполнен, а уровень k заполнен слева направо, т.е форма пирамиды имеет приблизительно такой вид:

· выполняется "свойство пирамиды": каждый элемент меньше, либо равен родителю.
Как хранить пирамиду? Наименее хлопотно - поместить ее в массив.
 Соответствие между геометрической структурой пирамиды как дерева и массивом устанавливается по следующей схеме:
·
в a[0] хранится корень дерева
·
левый и правый сыновья элемента a[i] хранятся, соответственнно, в a[2i+1] и a[2i+2]
· никаких дополнительных переменных, нужно лишь понимать схему.
· узлы хранятся от вершины и далее вниз, уровень за уровнем.
· узлы одного уровня хранятся в массиве слева направо.
Запишем в виде массива пирамиду, изображенную выше.. Слева-направо, сверху-вниз: 94 67 18 44 55 12 06 42. На рисунке место элемента пирамиды в массиве обозначено цифрой справа-вверху от него. Восстановить пирамиду из массива как геометрический объект легко - достаточно вспомнить схему хранения и нарисовать, начиная от корня. Фаза 1 сортировки: построение пирамиды
Hачать построение пирамиды можно с a[k]...a[n], k = [size/2]. Эта часть массива удовлетворяет свойству пирамиды, так как не существует индексов i,j: i = 2i+1 ( или j = 2i+2 )... Просто потому, что такие i,j находятся за границей массива.
Следует заметить, что неправильно говорить о том, что a[k]..a[n] является пирамидой как самостоятельный массив. Это, вообще говоря, не верно: его элементы могут быть любыми. Свойство пирамиды сохраняется лишь в рамках исходного, основного массива a[0]...a[n].
Далее будем расширять часть массива, обладающую столь полезным свойством, добавляя по одному элементу за шаг. Следующий элемент на каждом шаге добавления - тот, который стоит перед уже готовой частью.
Чтобы при добавлении элемента сохранялась пирамидальность, будем использовать следующую процедуру расширения пирамиды a[i+1]..a[n] на элемент a[i] влево:
1. Смотрим на сыновей слева и справа - в массиве это a[2i+1] и a[2i+2] и выбираем наибольшего из них.
1. Если этот элемент больше a[i] - меняем его с a[i] местами и идем к шагу 2, имея в виду новое положение a[i] в массиве. Иначе конец процедуры.
Новый элемент "просеивается" сквозь пирамиду.Code: template<class T> void downHeap(T a[], long k, long n) { // процедура просеивания следующего элемента // До процедуры: a[k+1]...a[n] - пирамида // После: a[k]...a[n] - пирамида T new_elem; long child; new_elem = a[k]; while(k <= n/2) { // пока у a[k] есть дети child = 2*k; // выбираем большего сына if( child < n && a[child] < a[child+1] ) child++; if( new_elem >= a[child] ) break; // иначе a[k] = a[child]; // переносим сына наверх k = child; } a[k] = new_elem; }
Пишем игры на MIDletPascal.
| Пишем игры на MIDletPascal. |
Введение
В последнее время, игры для мобильных устройств, приобретают всё большую популярность. В частности, достаточно широко распространены Java игры для сотовых телефонов. Каждый владелец современного телефона, имеет на руках готовую игровую платформу, способную развлечь своего хозяина в любой момент. Именно из-за этого факта, большая часть разработчиков компьютерных игр переметнула на рынок мобильных устройств… Итак, “нормальные” люди пишут Java игры естественно на языке Java (J2ME). Но т.к. цели у нас пока не слишком грандиозные… идём выбирать что-нибудь проще. Из наиболее простых языков (надстроек) знаю лишь два: Mobile BASIC и MIDletPascal. Как раз о последнем и пойдёт речь в данной статье, т.к. он имеет хоть и скудные, но более продвинутые возможности в отличии от первого. Материал данной статьи не является полным описанием возможностей MIDletPascal, это более похоже на вводный курс, демонстрирующий применение наиболее необходимых для написания игр возможностей языка.
Установка и настройка

Прежде чем начать, нам необходимо иметь 2 вещи: компилятор и эмулятор. Первый предназначен для компиляции Pascal кода в Java байткод. А при помощи второго мы будем лицезреть наши достижения не “тревожа”, по пустякам, телефон… Пишем на MIDletPascal следовательно компилятор берём с официального сайта http://midletpascal.com. На момент написания данного материала, последней версией считалась “MIDletPascal, Version 2.02” за 14 января 2006 г. Эмулятором будет “Kwyshell MidpX Emulator”.Для тех, кто не хочет качать среду интегрирующуюся в explorer и портящую его внешнюю красоту своими безобразными кнопками с такими же безобразными иконками советую скачать урезанную его версию :) Итак, первым делом нам необходимо установить сам MIDletPascal. После успешного окончания установки, запускаем его и приступаем к настройке работы с эмулятором. Для этого заходим в пункт меню “Configure – Program options…” и во вкладке “Emulator” добавляем новый (или изменяем свойства стандартного). В “Run command” необходимо прописать путь к скачанному нами эмулятору и параметры его запуска. Эта строка должна выглядеть приблизительно так “C:\MP\Midp2Exe.exe -jar %JAR% -r”. Сохраняем изменения и возвращаемся к главному окну программы. Теперь всё готово для начала работы в новой для нас среде. Создаём новый шаблон проекта “File – New Project…”. Выбрав имя будущего проекта и его месторасположение на диске, жмём на “Create”. В окне редактора появится банальный код банальной до слёз программы выводящей “Hello world!”. Можно скомпилировать и запустить мидлет нажатием “F9”, ничего сверхъестественного мы не увидим, но будет приятно когда хоть что-то аналогичное “созданное Вами” запустится на любимой моторолке, нокии или что там у Вас...
Первая программа

Я надеюсь, что Вы не впервые сели за Pascal и хоть какой-то опыт написания программ на этом замечательном языке у Вас имеется, так что давайте попробуем написать “продвинутый Hello World!” попутно разучив методы работы с некоторыми функциями и принцип написания мидлетов вцелом. Темой будет звёздное небо (аналог стандартной заставки в Windows) и парящий над ним (сами знаете какой) текст…
Code: Program Hello; Type. // Описываем тип-элемент Звезда. TStar = record. X, Y, Z : Integer; // Положение в пространстве. End; Const. MAX_STARS = 150; // Кол-во звёздочек. HELLO = 'HELLO WORLD!'; // "Та самая надпись" :). SPEED = 200; // Скорость, в единицах/сек. Var. I : Integer; // Наши звёздочки :). Stars : array [1..MAX_STARS] of TStar; // Ширина и высота дисплея. Scr_W : Integer; Scr_H : Integer; // Время. Time, dt : Integer; // Рисует текущую звёздочку (i), цвета (c). Procedure SetPix(c: Integer); Var. Sx, sy : Integer; Begin. // Данные действия, проецируют 3D точку на 2D полоскость дисплея. Sx := trunc(scr_W / 2 + Stars[i].X * 200 / (Stars[i].Z + 200)); Sy := trunc(scr_H / 2 - Stars[i].Y * 200 / (Stars[i].Z + 200)); SetColor(c, c, c); // Устанавливаем цвет. Plot(sx, sy); // Выводим пиксель этого цвета. End; Begin. // Для начала, получим размеры экрана. Scr_W := GetWidth; Scr_H := GetHeight; // Затем, случайным образом раскидаем звёздочки. Randomize; For i := 1 to MAX_STARS do. Begin. Stars[i].X := random(scr_W * 4) - scr_W * 2; Stars[i].Y := random(scr_H * 4) - scr_H * 2; Stars[i].Z := random(1900); End; // Очистка содержимого дисплея (чёрный цвет). SetColor(0, 0, 0); FillRect(0, 0, scr_W, scr_H); Time := GetRelativeTimeMs; // Главный цикл отрисовки. Repeat. Dt := GetRelativeTimeMs - time; // Сколько мс прошло, с прошлой отрисовки. Time := GetRelativeTimeMs; // Засекаем время. For i := 1 to MAX_STARS do. Begin. // Затираем звёздочку с предыдущего кадра. SetPix(0); // Изменяем её позицию в зависимости прошедшего с последней отрисовки времени. Stars[i].Z := Stars[i].Z - SPEED * dt/1000; // Если звезда "улетела" за позицию камеры - генерируем её вдали. If Stars[i].Z <= -200 then. Begin. Stars[i].X := random(scr_W * 4) - scr_W * 2; Stars[i].Y := random(scr_H * 4) - scr_H * 2; Stars[i].Z := 1900; // Откидываем звезду далеко вперёд :). End; // Рисуем звёздочку в новом положении (цвет зависит от Z координаты). SetPix(trunc(255 - 255 * (Stars[i].Z + 200) / 2100)); End; // Выводим текст по центру экрана. SetColor(255, 0, 0); DrawText(HELLO, (scr_W - GetStringWidth(HELLO))/2, 0); // Всё что было нами нарисовано - выводим на дисплей. Repaint; Until GetKeyClicked = KE_KEY0; // Закрыть приложение при нажатии "0". End.
Собственно, запустив эту программу на своём телефоне, Вашему счастью не будет предела.
Вывод спрайтов
Рисование точек, эллипсов, прямых это весело по началу. Но вскоре захочется вставить какой-нибудь рисунок, картинку, спрайт и т.п. Как раз для этих случаев MIDletPascal имеет в своём распоряжении набор функций для работы с графикой загруженной из внешних файлов или ресурсов. Итак, для опытов с графикой, предлагаю попытаться вспомнить о старой, и многими уже давно забытой игре на Dendy - "Battle City". Для начала нам понадобится 4 изображения одного и того же танка повёрнутого на углы pi/2 * n. Эти изображения должны быть в виде png файлов размером 16х16 пикселей, с именами вида tankN.png (где N – порядковый номер изображения, начиная с 0). Почему такие мелкие? Да потому, что далеко не на всех телефонах стоят дисплеи с разрешением выше 128х128 (по крайней мере, так было на момент написания статьи ;).

Нарисовав это чудо техники, создадим новый проект, и первым же делом добавим эти файлы в ресурс при помощи “Project – Import resource file…”. Наш танк должен уметь ездить по нажатию на соответствующие клавиши и ни в коем случае не выезжать за пределы поля! Приступим к написанию кода:
Code: Program Tank; Const. SPEED = 1; // Скорость движения танка. Var. I : Integer; // Внешний вид танка при различных углах поворота. Tank : array [0..3] of image; Dir : Integer; // направление. X, Y : Integer; // позиция. Key : Integer; Begin. // Инициализация. For i := 0 to 3 do // Подгружаем все картинки из ресурса. Tank[i] := LoadImage('/tank' + chr(48 + i) + '.png'); // 48 - код нуля. Dir := 0; // смотрим строго направо. X := 32; // позиция танка по X. Y := 32; // и по Y соответственно :). // Подготовка поля вывода. SetColor(0, 0, 0); FillRect(0, 0, GetWidth, GetHeight); // Отрисовка и обработка ввода. Repeat. // Стираем танк. FillRect(X, Y, 16,16); // Получаем код зажатой клавиши. Key := GetKeyPressed; // Вот что бывает, когда нет возможности использовать case ;). If key = KE_KEY6 then. Begin. Dir := 0; X := X + SPEED; End else. If key = KE_KEY8 then. Begin. Dir := 1; Y := Y + SPEED; End else. If key = KE_KEY4 then. Begin. Dir := 2; X := X - SPEED; End else. If key = KE_KEY2 then. Begin. Dir := 3; Y := Y - SPEED; End; // контролируем выход за границы экрана. If X < 0 then X := 0; If Y < 0 then Y := 0; If X > GetWidth - 16 then X := GetWidth - 16; If Y > GetHeight - 16 then Y := GetHeight - 16; // Рисуем танк новой позиции. DrawImage(tank[dir], X, Y); // Вывод этого безобразия на экран и задержка на 20 мс. Repaint; Delay(20); Until GetKeyClicked = KE_KEY0; // Закрыть приложение при нажатии "0". End.
Целью написания полноценной игры я не задавался, так что оставлю врагов, стрельбу и препятствия на Вашей совести… ;).
Звук и Музыка
Игры, как правило, состоят не только из поочерёдно сменяющихся картинок, но и имеют хоть какое-то, но звуковое сопровождение. MIDletPascal поддерживает проигрывание всего одного аудиопотока! Т.е. слышать звук разрывающихся снарядов, под пятую сонату Бетховена не получится. Это есть жирный минус и один из многих камней в огород MIDletPascal. Впрочем, разработчики оставили возможность подключения своих модулей написанных на Java… но мы же пишем на Pascal! ;) Итак, мы имеем возможность проигрывания midi, wav, mp3 и au файлов. Но в то же время, накладываются ограничения самого телефона, и об этом не стоит забывать. Существует возможность loop’инга, т.е. проигрывания одного и того же звука несколько раз подряд. Прежде чем что-либо писать, необходимо найти какой-нибудь midi файл, и обозвав его “music.mid” добавить в ресурс проекта. Теперь можно приступать к написанию кода. Далее опишу код простой программки выводящей пучок “болтающихся под музыку щупалец”, заодно познакомив с некоторыми математическими функциями:
Code: Program vis; Const. S = 12; // Кол-во щупалец. N = 8; // Кол-во звеньев в каждом из них. Var. I, j : Integer; X, y : Real; Tx, ty : Real; K, d : Real; // Углы поворота звеньев относительно друг-друга. A : array [1..N] of Real; // Длина одного звена. Len : Real; Begin. // Инициализация звука. If not OpenPlayer('/music.mid', 'audio/midi') then // загрузка музыки. Halt; // ошибка при загрузке (не поддерживается midi формат или звук отключен). If not SetPlayerCount(-1) then // проигрывать бесконечное число раз. Halt; If not StartPlayer then // начать проигрывание. Halt; // Нам необходимо создать что-то графическое... // Расчёт длины звена, в зависимости от размеров экрана. If GetWidth > GetHeight then. Len := GetHeight/2/N. Else. Len := GetWidth/2/N; Randomize; K := random(360) * pi / 180; D := pi * 2 / S; // просто оптимизиация. // Главный цикл. Repeat. // Расчёт коэфицента поворота. If random(50) = 0 then. K := random(360) * pi / 180; // Поворот всех щупалец. A[1] := a[1] + sin(k)/10; // Интерполяция углов между щупальцами. For i := 2 to N do. A[i] := a[i] + (a[i - 1] - a[i]) * 0.1; // Рисуем результат (под музыку ;). SetColor(0, 0, 0); FillRect(0, 0, GetWidth, GetHeight); // Стираем всё. For j := 0 to S - 1 do. Begin. X := 0.5 * GetWidth; Y := 0.5 * GetHeight; For i := 2 to N do. Begin. SetColor(255, trunc(255 - 255 * i/N), 255); // Немного школьной тригонометрии :). Tx := x + cos(j * d + a[i]) * len; Ty := y + sin(j * d + a[i]) * len; DrawLine(trunc(x), trunc(y), trunc(tx), trunc(ty)); X := tx; Y := ty; End; End; // Вывод на дисплей. Repaint; Until GetKeyClicked = KE_KEY0; // Закрыть приложение при нажатии "0". StopPlayer; End.
Самыми медленными операциями в этой программе являются вызовы тригонометрических функций (sin и cos). Существует возможность их оптимизации при помощи использования заранее рассчитанных таблиц значений. Помимо этого, скорость работы данного приложения на различных телефонах может быть различной...
Заключение
Хочу сказать несколько слов по поводу MIDletPascal IDE... До Delphi IDE ему, конечно же, дальше некуда, и постоянно выскакивающие ошибки при компиляции, суть которых не понятна (часто обычный pascal код разобрать не может :) Но вцелом, среда достаточно удобная. Сам язык является по сути “обрезанным” паскалем. Имеются записи (record), массивы (array) и другие полезные “штучки”, но никакого ООП присущего той же Java не имеется. Т.е. язык по сути является обычным процедурным паскалем без некоторых операторов (case например) Также имеются дополнительные возможности, такие как: работа с HTTP, отправка SMS, стандартный пользовательский интерфейс, подключение Java модулей и др. Но при серьёзном подходе к написанию мидлетов, MIDletPascal будет ограничивать Вас везде, куда бы Вы ни сунулись… ;).
Ссылки по теме
- http://mobilebasic.com - http://midletpascal.com - http://www.j2meforums.com/yabbse/index.php?board=4.
XProger.
©Drkb::00335.
Пишем программу мониторинга за памятью.
| пишем программу мониторинга за памятью |
Сегодня мы попытаемся написать программу, которая будет показывать состояние памяти компа. Для начала определим что она будет делать. Ну самое главное что нам нужно, это сотояние физической памяти и загруженность ее в %. А дальше, по своему вкусу, добавим еще состояние виртуальной и страничной памяти. Начнем. Создай новый проект на Делфи ( File->New->Application). Теперь подумай, как тебе удобней отображать состояние памяти. Для меня лучше в Label, но можно и Edit. Ну это на твое усмотрение. Кидай на форму 7 компонентов Label (в них будет отображаться значение) и еще 7 (это будут пояснения: загруженность, всего физической, использовано физической, всего страничной, использовано страничной, всего виртуальной, использовано виртуальной). Какие не нужны, те отбрось ;) . Теперь кинь таймер (из вкладки System). Это будет наш главный элемент., поэтому поставь интервал по своему усмотрению (у меня он 400). Этот интервал будет отвечать за частоту обновления полей. Ну и для красоты брось ProgressBar ( из вкладки Win32). У тебя должно получиться что-то типа этого: Теперь приступим непосредственно к кодингу. Весь код мы будем писать в процедуру запуска таймера. А вот и код:
Code: Procedure TForm1.Timer1Timer(Sender: TObject); Var m: TMemoryStatus; temp: integer; Begin m.dwLength:=sizeof(m); GlobalMemoryStatus(m); With m do begin //Загруженность памяти. Label1.caption:=IntToStr (dwMemoryLoad)+' %'; // Всего физической. Label2.caption:=IntToStr (dwTotalPhys)+' байт'; // Свободно физической. Label3.caption:=IntToStr (dwAvailPhys)+' байт'; // Всего страничной. Label4.caption:=IntToStr (dwTotalPageFile)+' байт'; // Свободно страничной. Label5.caption:=IntToStr (dwAvailPageFile)+' байт'; // Всего выиртуальной. Label6.caption:=IntToStr (dwTotalVirtual)+' байт'; //Свободно виртуальной. Label7.caption:=IntToStr (dwAvailVirtual)+' байт'; //Загруженность на ProgressBar1. Progressbar1.Max:= dwTotalPhys; Progressbar1.Position:=dwTotalPhys-dwAvailPhys; End; End;
Вот в принципе и все. Если ты используешь Edit, то вместо labelX.caption пиши EditX.text , где х-номер компонента. И последнее, чтобы pogressBar выглядела лучше, измени свойство Smooth равным True. Если у тебя возникнут какие-либо вопросы, предложения, пожелания, прошу отправлять их мне по адресу: crazy_script@mail.ru.
Источник: http://delphi.dax.ru.
©Drkb::02078.
Содержание.
- Назад в будущее.
- Назначение портов.
- Обзор HTTP.
- Обзор средств проектирования информационных систем.
- Пакеты и язык управления заданиями.
- "Некорректные" вещественные значения.
- Некоторые дополнительные возможности.
- Обмен информацией между Вашими программами в сети по почтовым каналам.
- Обнаружение разъединения.
- Немного относительно методов упаковки данных.
- Немного о джойстиках.
- Немного философии.
- Очень простой пример поиска информации в реестре.
- Настройка системы безопасности DCOM сервера.
- Настройки листа и печать в MS Excel.
- Местоположение символа в строке.
- Место занимаемое таблицей.
- Математические основы реляционных СУБД.
- Обучающее руководство по PostgreSQL.
- Метод Дихотомии.
- Объединить 2 файла.
- Объектно-ориентированный подход и современные мониторы транзакций.
- Не устанавливается цвет панели.
- Эта незнакомая IDE! (статья).
- IDE highlighting the incorrect line.
- Пишем игры на MIDletPascal.
- пишем программу мониторинга за памятью.