Автостопом по Python.
Tablib.
Tablib — это библиотека Python, которая преобразует данные в различные форматы, сохраняет их в объекте класса Dataset, а несколько объектов типа Datasets — в объекте класса Databook. Объекты класса Dataset хранятся в форматах JSON, YAML, DBF и CSV (файлы в этих форматах можно импортировать), наборы данных могут быть экспортированы в форматах XLSX, XLS, ODS, JSON, YAML, DBF, CSV, TSV и HTML. Библиотека Tablib выпущена Кеннетом Ритцем (Kenneth Reitz) в 2010 году, имеет интуитивный дизайн API, характерный для всех проектов Ритца.
Читаем небольшую библиотеку.
Tablib — это библиотека, а не приложение, поэтому не имеет четко определенной точки входа, как в случае с HowDoI и Diamond.
Загрузите Tablib из GitHub:
$ git clone https://github.com/kennethreitz/tablib.git.
$ virtualenv — p python3 venv.
$ source venv/bin/activate.
(venv)$ cd tablib.
(venv)$ pip install — editable.
(venv)$ python test_tablib.py # Run the unit tests.
Читаем документацию Tablib.
Документация Tablib (http://docs.python-tablib.org/) начинается с упоминания варианта использования, затем в ней более подробно описываются возможности библиотеки: она предоставляет объект типа Dataset, который имеет строки, столбцы и заголовки. Вы можете выполнять операции ввода/вывода из разных форматов для объекта типа Dataset. В разделе, содержащем более сложные варианты использования, говорится, что вы можете добавлять к строкам теги и создавать унаследованные столбцы, которые являются функциями других столбцов.
Используем Tablib.
Tablib — это библиотека, а не исполняемый файл, как в случае с HowDoI или Diamond, поэтому вы можете открыть интерактивную сессию Python и использовать функцию help() для исследования API. Рассмотрим пример применения класса tablib.Dataset, разных форматов данных и способа работы I/O:
>>> import tablib.
>>> data = tablib.Dataset().
>>> names = ('Black Knight', 'Killer Rabbit').
>>>
>>> for name in names:
… ····fname, lname = name.split().
… ····data.append((fname, lname)).
…
>>> data.dict.
[['Black', 'Knight'], ['Killer', 'Rabbit']].
>>>
>>> print(data.csv).
Black,Knight.
Killer,Rabbit.
>>> data.headers=('First name', 'Last name').
>>> print(data.yaml).
- {First name: Black, Last name: Knight}.
- {First name: Killer, Last name: Rabbit}.
>>> with open('tmp.csv', 'w') as outfile:
… ····outfile.write(data.csv).
…
64.
>>> newdata = tablib.Dataset().
>>> newdata.csv = open('tmp.csv'). read().
>>> print(newdata.yaml).
- {First name: Black, Last name: Knight}.
- {First name: Killer, Last name: Rabbit}.
Читаем код библиотеки Tablib.
Структура файлов, находящихся в каталоге tablib/, выглядит так:
Tablib.
|- __init__.py.
|- compat.py.
|- core.py.
|- formats/
|- packages/
Каталоги tablib/formats/ и tablib/packages/ рассматриваются в следующих разделах.
Python поддерживает строки документации на уровне модулей, как и строки документации, которые мы уже описали, — строковые литералы, являющиеся первым выражением в функции, классе или методе. На сайте Stack Overflow приведены полезные советы о том, как задокументировать модули (http://stackoverflow.com/a/2557196). Для нас это означает, что существует еще один способ исследовать исходный код — мы можем ввести команду head *.py в терминальной оболочке, находясь на верхнем уровне пакета, чтобы показать все строки документации модуля. Вот что мы увидим для библиотеки Tablib:

Мы узнали следующее.
 API высшего уровня (содержимое файла __init__.py доступно в каталоге tablib после выполнения оператора import tablib) имеет всего девять точек входа: классы Databook и Dataset упоминаются в документации, detect может использоваться для определения форматирования, import_set и import_book должны импортировать данные, а последние три класса — InvalidDatasetType, InvalidDimensions и UnsupportedFormat — выглядят как исключения (если код следует принципам PEP 8, мы можем сказать, какие объекты являются пользовательскими классами на основе их регистра).
 Tablib/compat.py — это модуль совместимости. Беглый взгляд на него покажет, что он обрабатывает проблемы совместимости между Python 2 и Python 3 аналогично HowDoI, разрешая разные местоположения и имена к одинаковым символам, которые будут использованы в tablib/core.py.
 В файле tablib/core.py в соответствии с его именем реализуются объекты Tablib вроде Dataset и Databook.
Примеры из структуры Tablib.
Главная особенность, которую мы хотим подчеркнуть в Tablib, — отсутствие использования классов в модулях в tablib/formats/ (это идеально иллюстрирует наше утверждение, что не нужно везде применять классы). Далее мы приведем фрагменты кода, демонстрирующие использование синтаксиса декоратора в Tablib, а также задействуем класс property (https://docs.python.org/library/functions.html#property) для создания унаследованных атрибутов вроде ширины и высоты набора данных. Помимо этого, покажем, как динамически он регистрирует форматы файлов, чтобы избежать дупликации шаблонного кода для разных типов формата (CSV, YAML и т. д.).
В последних двух подразделах мы рассмотрим, как Tablib использует зависимости, полученные от третьей стороны, а затем обсудим свойство __slots__ объектов нового класса. Вы можете пропустить эти разделы и при этом продолжать жить счастливой питонской жизнью.
Отсутствие ненужного объектно-ориентированного кода в форматах (использование пространств имен для группирующих функций).
Каталог форматов содержит все определенные для ввода/вывода форматы файлов. Имена модулей _csv.py, _tsv.py, _json.py, _yaml.py, _xls.py, _xlsx.py, _ods.py и _xls.py начинаются с нижнего подчеркивания — это указывает пользователю библиотеки, что свойства не предназначены для непосредственного использования. Мы можем перейти в каталог formats и выполнять поиск классов и функций. Команда grep ^class formats/*.py показывает отсутствие определений классов, а команда grep ^def formats/*.py — что каждый модуль содержит одну или несколько следующих функций:
• detect(stream) определяет формат файла, основываясь на содержимом потока;
• dset_sheet(dataset, ws) форматирует клетки для таблиц Excel;
• export_set(dataset) экспортирует набор данных в заданный формат, возвращая отформатированную строку в новом формате (для Excel возвращает объект bytes или бинарную строку в Python 2);
• import_set(dset, in_stream, headers=True) заменяет содержимое набора данных содержимым входного потока;
• export_book(databook) экспортирует объекты Datasheet в Databook в заданном формате, возвращая объект типа string или bytes;
• import_book(dbook, in_stream, headers=True) заменяет содержимое databook содержимым входного потока.
Это примеры применения модулей как пространств имен (в конце концов, они же являются отличной штукой) для разделения функций вместо того, чтобы использовать ненужные классы. Мы узнаем предназначение каждой функции по ее имени, например formats._csv.import_set(), formats._tsv.import_set() и formats._json.import_set() импортируют наборы данных из файлов в формате CSV, TSV и JSON соответственно. Другие функции отвечают за экспорт данных и определение формата файла (где это возможно) для каждого доступного Tablib формата.
Дескрипторы и декораторы свойств (используйте неизменяемость, когда это идет на пользу API).
Tablib — наша первая библиотека, в которой используется синтаксис декораторов Python, описанный в подразделе «Декораторы» раздела «Структурируем проект» главы 4. Синтаксисом предусмотрено указывать символ @ перед именем функции, вся конструкция размещается над другой функцией. Декоратор изменяет (или декорирует) функцию, которая находится под ним. В следующем фрагменте кода свойство изменяет функции Dataset.height и Dataset.width, делая их дескрипторами — классами, в которых определен хотя бы один из следующих методов: __get__(), __set__() или __delete__() (геттер, сеттер и метод удаления). Например, поиск атрибута Dataset.height приведет к срабатыванию функции-геттера, сеттера или удаления в зависимости от контекста применения атрибута. Такое поведение присуще только новым классам (их мы вскоре обсудим). Для получения более подробной информации о дескрипторах обратитесь к довольно полезному руководству по Python по адресу https://docs.python.org/3/howto/descriptor.html.
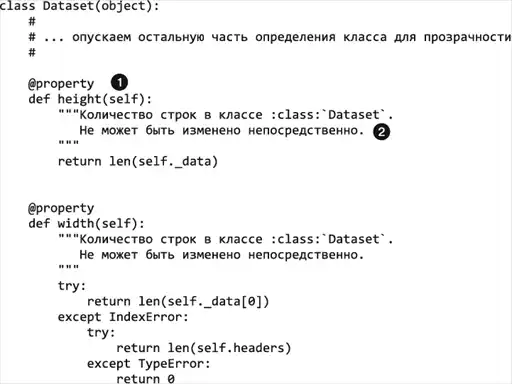
Именно так используется декоратор. В данном случае свойство изменяет Dataset.height, чтобы оно вело себя как свойство, а не как связанный метод. Он может работать только с методами классов.
Когда свойство применяется как декоратор, атрибут height вернет высоту Dataset, но вы не можете задать высоту множества данных, вызвав Dataset.height.
Так выглядят атрибуты height и width при использовании:
>>> import tablib.
>>> data = tablib.Dataset().
>>> data.header = ("amount", "ingredient").
>>> data.append(("2 cubes", "Arcturan Mega-gin")).
>>> data.width.
2.
>>> data.height.
1.
>>>
>>> data.height = 3.
Traceback (most recent call last):
····File "<stdin>", line 1, in <module>
AttributeError: can't set attribute.
Доступ к data.height можно получить так же, как и к любому другому атрибуту, но изменить его значение вы не можете — оно высчитывается на основе данных и всегда актуально. Такой дизайн API весьма эргономичен: конструкцию data.height проще ввести на клавиатуре, чем data.get_height(); понятно, что означает data.height. Поскольку значение этого свойства выводится на основе данных (значение свойства нельзя задать, для него определена только функция-геттер), можно не переживать, что значение свойства рассинхронизируется с реальными данными.
Декоратор свойства можно применить только к атрибутам классов и только к тем классам, которые наследуют от base object object (например, class MyClass(object), а не class MyClass() — в Python 3 всегда выполняется наследование от объекта).
Один и тот же инструмент используется при создании API для импорта и экспорта данных в Tablib для разных форматов (Tablib не хранит строку для каждого формата). Вместо этого применяются Dataset-атрибуты csv, json и yaml, они похожи на свойства Dataset.height и Dataset.width, показанные в предыдущем примере: вызывают функцию, которая генерирует результат из сохраненных данных или преобразует входной формат и затем заменяет основные данные. Но существует только один набор данных.
Когда свойство data.csv находится с левой стороны знака «равно», вызывается функция-сеттер для этого свойства, которая преобразует dataset из формата CSV. Когда свойство data.yaml находится с правой стороны знака «равно» или стоит отдельно, вызывается функция-геттер для создания строки в заданном формате на основе внутреннего набора данных. Рассмотрим пример.
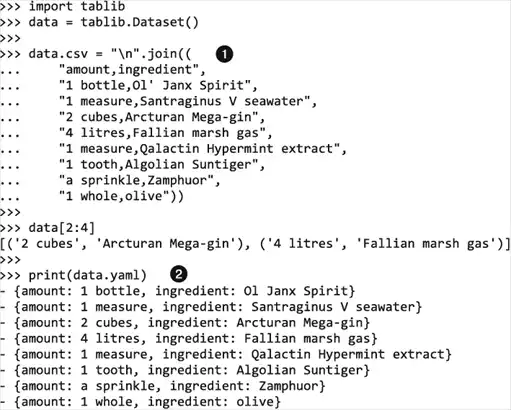
Свойство data.csv, которое стоит с левой стороны от знака «равно» (оператора присваивания), вызывает функцию formats.csv.import_set(), передавая data в качестве первого аргумента, и строку, содержащую ингредиенты Пангалактического Грызлодера, в качестве второго аргумента.
 Свойство data.yaml, стоящее отдельно, вызывает функцию formats.yaml.export_set(), передавая data в качестве аргумента, выводя строку в формате YAML для функции print().
Функции для получения, установки и удаления данных могут быть привязаны к единому атрибуту с помощью property. Его сигнатура выглядит так: property(fget=None, fset=None, fdel=None, doc=None), fget определяет функцию-геттер (formats.csv.import_set()), fset — функцию-сеттер (formats.csv.export_set()), а fdel — функцию удаления данных (оставлена пустой). Далее мы увидим код, в котором программно устанавливаются свойства форматирования.
Форматы файлов, зарегистрированные программно (не повторяйте дома).
Tablib помещает все подпрограммы для форматирования в подпакет formats. Это делает чище основной модуль core.py — и целый пакет становится модульным; добавлять новые форматы файлов будет нетрудно. Несмотря на то что можно копировать фрагменты практически идентичного кода и импортировать поведение при импорте и экспорте для каждого формата отдельно, все форматы программно загружаются в свойства, названные в честь каждого формата, в класс Dataset.
В следующем примере кода мы выводим все содержимое файла formats/__init__.py, поскольку файл не так велик и мы хотим показать, как определяется formats.available.
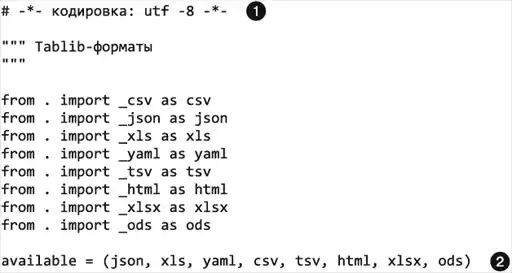
В этой строке интерпретатору Python явно указывается, что файл имеет кодировку UTF-8[63].
Определение formats.available находится в файле formats/__init__.py. Его также можно получить с помощью функции dir(tablib.formats), но приведенный выше список более прост для восприятия.
В файле core.py вместо примерно 20 (безобразных и сложных для поддержки) повторяющихся описаний функции для каждого формата код импортирует каждый формат программно, вызывая функцию self._register_formats() в конце метода __init__() класса Dataset. Рассмотрим фрагмент кода, в котором приводится метод Dataset._register_formats().

Символ @classmethod является декоратором (они подробно описаны в подразделе «Декораторы» подраздела «Структурируем проект» главы 4). Декоратор модифицирует метод _register_formats() таким образом, что он начинает передавать в качестве первого аргумента класс объекта (Dataset), а не его экземпляр (self).
Параметр formats.available определен в файле formats/__init__.py и содержит все доступные форматы.
 В этой строке setattr присваивает значение атрибуту с именем fmt.title (то есть Dataset.csv или Dataset.xls). Это значение особенное: функция property(fmt.export_set, fmt.import_set) превращает Dataset.csv в свойство.
 Если свойство fmt.import_set не будет определено, возникнет исключение AttributeError.
 Если функции импорта нет, попробуйте присвоить лишь поведение экспорта.
 Если нет ни функции импорта, ни функции экспорта, не присваивайте ничего.
 Каждый из форматов файлов определен здесь как свойство, имеет описательную строку документации. Строка документации будет сохранена, когда функция property() будет вызвана в точке или
 для присвоения дополнительного поведения.
 \t и \n — управляющие последовательности, которые представляют собой, соответственно, символ табуляции и новую строку. Все они перечислены в документации к строковым литералам Python (https://docs.python.org/3/reference/lexical_analysis.html#index-18).
Зависимости, полученные от третьей стороны, в пакетах (пример их использования).
Зависимости Tablib в данный момент поставляются с кодом — в каталоге packages, но могут в будущем быть перемещены в систему надстроек. Каталог packages содержит сторонние пакеты, используемые внутри Tablib, чтобы гарантировать совместимость; другой вариант — указание версий в файле setup.py, который будет загружен и установлен в момент установки Tablib. Этот прием рассматривается в разделе «Зависимости, получаемые от третьей стороны» раздела «Структурируем проект» главы 4. Для Tablib был выбран вариант поведения, позволяющий снизить количество зависимостей, который нужно загружать пользователям, и поскольку иногда для Python 2 и Python 3 требуются разные пакеты, в этом случае включаются оба пакета. (Соответствующий пакет импортируется, функции вызываются с помощью их обычного имени в файле tablib/compat.py.) Таким образом, Tablib может иметь одну базу кода вместо двух — по одной для каждой версии Python. Раз каждая из зависимостей имеет собственную лицензию, на верхний уровень каталога проекта был добавлен документ NOTICE, в котором перечисляются лицензии каждой зависимости.
Экономим память с помощью свойства __slots__ (оптимизируйте c осторожностью).
Скорости Python предпочитает читаемость. Его дизайн, афоризмы, из которых состоит его дзен, и раннее влияние, которое на него оказали языки вроде ABC (http://bit.ly/abc-to-python), — все это заставляет ставить дружелюбие к пользователю над производительностью (более подробно об оптимизации мы поговорим в разделе «Скорость» главы 8).
Использование свойства __slots__ в Tablib — этот тот случай, когда оптимизация имеет значение. Данная ссылка выглядит несколько странно, она доступна только для новых классов (они описаны через несколько страниц), но мы хотим показать, что при необходимости вы можете оптимизировать Python.
Подобная оптимизация полезна только в том случае, если у вас имеется много небольших объектов, поскольку она сократит отпечаток каждого объекта класса на размер одного словаря (крупные объекты сделают такую небольшую экономию нерелевантной, а для малого количества объектов такая экономия не стоит затраченных усилий).
Рассмотрим фрагмент из документации __slots__ (http://bit.ly/__slots__-doc).
По умолчанию объекты классов имеют словарь для хранения атрибутов. Он занимает слишком много места, если объекты имеют малое количество переменных объекта. Использование места может стать особенно заметным при создании большого количества объектов. Ситуацию можно изменить путем объявления __slots__ в описании класса. Объявление __slots__ принимает последовательность переменных объекта и резервирует достаточный объем памяти для каждой переменной. Место экономится, поскольку для каждой переменной теперь не создается __dict__.Обычно вам не следует об этом беспокоиться: обратите внимание, что свойство __slots__ не появляется в классах Dataset или Databook — только в классе Row, но поскольку рядов данных может быть очень много, использование __slots__ выглядит хорошим решением. Класс Row не показан в tablib/__init__.py, поскольку является вспомогательным классом для класса Dataset, для каждой строки создается один объект такого класса.
Рассмотрим, как выглядит определение __slots__ в самом начале определения класса Row:
Class Row(object):
····"""Внутренний объект Row. Используется в основном для фильтрации.""".
····__slots__ = ['_row', 'tags'].
····def __init__(self, row=list(), tags=list()):
········self._row = list(row).
········self.tags = list(tags).
····#
····#… и т. д…
····#
Проблема в том, что больше не существует атрибута __dict__, в котором хранятся объекты класса Row, но функция pickle.dump() (вызывается для сериализации объектов) по умолчанию использует __dict__ для сериализации объектов, если только не определен метод __getstate__(). Аналогично во время десериализации (процесса, который читает сериализованные байты и восстанавливает объект в памяти), если метод __setstate__() не определен, метод pickle.load() загружает данные в атрибут объекта __dict__. Рассмотрим, как это обойти.
Class Row(object):
····#
····#… пропускаем другие определения…
····#
····def __getstate__(self):
········slots = dict().
········for slot in self.__slots__:
············attribute = getattr(self, slot).
············slots[slot] = attribute.
········return slots.
····def __setstate__(self, state):
········for (k, v) in list(state.items()):
············setattr(self, k, v).
Для получения более подробной информации о методах __getstate__() и __setstate__() и сериализации обратитесь к документации __getstate__ (http://bit.ly/__getstate__-doc).
Примеры из стиля Tablib.
Мы подготовили лишь один пример использования стиля в Tablib — перегрузка операторов (это позволяет рассмотреть детали модели данных Python). Настройка поведения ваших классов позволит разработчикам, использующим ваш API, писать хороший код.
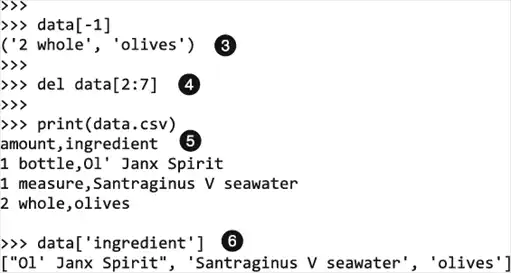
Перегрузка операторов (красивое лучше, чем уродливое). В этом фрагменте кода приводится перегрузка операторов Python, чтобы выполнять операции для строк или столбцов набора данных. В первом фрагменте кода показывается интерактивное применение квадратных скобок [] как для численных индексов, так и для имен столбцов, а во втором — код, который использует это поведение.
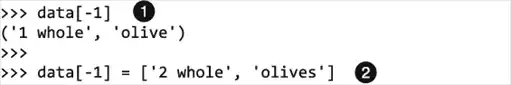
Если вы указываете в квадратных скобках числа, этот оператор вернет строку, которая находится в заданной позиции.
Благодаря этому оператору присваивания с квадратными скобками…
… вместо исходной одной оливки у вас становится две.
Здесь выполняется удаление с помощью вырезки — 2:7 указывает на числа 2, 3, 4, 5, 6, но не 7.
Взгляните, насколько сокращается рецепт после выполнения.
Вы также можете получить доступ к столбцам с помощью имени.
В части кода класса Dataset, которая определяет поведение оператора «квадратные скобки», показывается, как обрабатывать доступ по имени столбца и номеру строки.

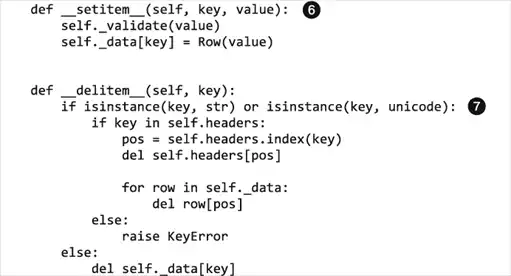
Во-первых, проверим, что именно мы ищем — столбец (True, если key является строкой) или строку (True, если key является числом или вырезкой).
Этот код проверяет наличие ключа в self.headers и затем…
…явно вызывает исключение KeyError, поэтому, если вы получаете доступ по имени столбца, поведение будет таким же, как и у словаря. Весь блок if/else необязателен для работы функции — если его опустить, исключение ValueError будет сгенерировано функцией self.headers.index(key) в том случае, если ключа нет в self.headers. Единственным его предназначением является предоставление пользователю библиотеки более информативной ошибки.
Здесь определяется, чем является ключ — числом или вырезкой (вроде 2:7). Если вырезкой, _results будет списком, а не объектом класса Row.
Здесь обрабатывается вырезка. Поскольку строки возвращаются как кортежи, значения представляют собой неизменяемые копии реальных данных — и данные из набора (которые хранятся в списках) не будут случайно повреждены в результате присваивания.
 Метод __setitem__() может изменить одну строку, но не столбец. Это сделано намеренно, так как не существует способа изменить содержимое всего столбца; с точки зрения целостности данных такое решение не самый плохой выбор. Пользователь всегда может преобразовать столбец и внедрить его в любую позицию с помощью одного из методов insert_col(), lpush_col() или rpush_col().
Метод __delitem__() удалит столбец или строку, используя ту же логику, что и метод __getitem__().
Для получения более подробной информации о перегрузке операторов и других особых методах смотрите документацию Python о специальных именах методов (http://bit.ly/special-method-names).
- 1.
- 2.
- 3.
- 4.
- 5.
- 6.
- 7.
- 8.
- 9.
- 10.
- 11.
- 12.
- 13.
- 14.
- 15.
- 16.
- 17.
- 18.
- 19.
- 20.
- 21.
- 22.
- 23.
- 24.
- 25.
- 26.
- 27.
- 28.
- 29.
- 30.
- 31.
- 32.
- 33.
- 34.
- 35.
- 36.
- 37.
- 38.
- 39.
- 40.
- 41.
- 42.
- 43.
- 44.
- 45.
- 46.
- 47.
- 48.
- 49.
- 50.
- 51.
- 52.
- 53.
- 54.
- 55.
- 56.
- 57.
- 58.
- 59.
- 60.
- 61.
- 62.
- 63.
- 64.
- 65.
- 66.
- 67.
- 68.
- 69.
- 70.
- 71.
- 72.
- 73.
- 74.
- 75.
- 76.
- 77.
- 78.
- 79.
- 80.
- 81.
- 82.
- 83.
- 84.
- 85.
- 86.
- 87.
- 88.
- 89.
- 90.
- 91.
- 92.
- 93.
- 94.
- 95.
- 96.
- 97.
- 98.
- 99.
- 100.
- 101.
- 102.
- 103.
- 104.
- 105.
- 106.
- 107.
- 108.
- 109.
- 110.
- 111.
- 112.
- 113.
- 114.
- 115.
- 116.
- 117.
- 118.
- 119.
- 120.
- 121.
- 122.
- 123.
- 124.
- 125.
- 126.
- 127.
- 128.
- 129.
- 130.
- 131.
- 132.
- 133.
- 134.
- 135.
- 136.
- 137.
- 138.
- 139.
- 140.
- 141.
- 142.
- 143.
- 144.
- 145.
- 146.
- 147.
- 148.
- 149.
- 150.
- 151.
- 152.
- 153.
- 154.
- 155.
- 156.
- 157.
- 158.
- 159.
- 160.
- 161.
- 162.
- 163.
- 164.
- 165.
- 166.
- 167.
- 168.
- 169.
- 170.
- 171.
- 172.
- 173.
- 174.
- 175.
- 176.
- 177.
- 178.
- 179.
- 180.
- 181.
- 182.
- 183.
- 184.
- 185.
- 186.
- 187.
- 188.
- 189.
- 190.
- 191.
- 192.
- 193.
- 194.
- 195.
- 196.
- 197.
- 198.
- 199.
- 200.
- 201.
- 202.
- 203.
- 204.
- 205.
- 206.
- 207.
- 208.
- 209.
- 210.
- 211.
- 212.
- 213.
- 214.
- 215.
- 216.
- 217.
- 218.
- 219.
- 220.
- 221.
- 222.
- 223.
- 224.
- 225.
- 226.
- 227.
- 228.
- 229.
- 230.
- 231.
- 232.
- 233.
- 234.
- 235.
- 236.
- 237.
- 238.
- 239.
- 240.
- 241.
- 242.
- 243.
- 244.
- 245.
- 246.
- 247.
- 248.
- 249.
- 250.
- 251.
- 252.
- 253.
- 254.
- 255.
- 256.
- 257.