Автостопом по Python.
Nltk.
Natural Language ToolKit (nltk) — это инструмент для анализа текста. Изначально выпущен Стивеном Бердом (Steven Bird) и Эдвардом Лопером (Edward Loper), чтобы помочь студентам усвоить курс Берда о Natural Language Processing (NLP), преподававшийся в University of Pennsylvania в 2001 году. Со временем вырос до размеров большой библиотеки, покрывающей множество языков и содержащей алгоритмы, связанные с последними исследованиями в области. Доступен под лицензией Apache 2.0, его загружают из PyPI более 100 000 раз в месяц. Его создатели выпустили книгу Natural Language Processing with Python (издательство O’Reilly): информация изложена в виде курса, который познакомит вас с Python и NLP.
Вы можете установить nltk из командной строки с помощью pip[113]. Он полагается на библиотеку NumPy, поэтому сначала установите ее:
$ pip install numpy.
$ pip install nltk.
Если вы используете Windows и не можете заставить работать NumPy, установленный с помощью pip, можете попробовать выполнить инструкции, приведенные по адресу http://bit.ly/numpy-install-win, на ресурсе Stack Overflow.
Размер и область видимости библиотеки могут отпугнуть некоторых пользователей, поэтому рассмотрим небольшой пример, иллюстрирующий, насколько просто работать с этим инструментом. Для начала нам понадобится получить набор данных (http://www.nltk.org/data.html) из отдельно загружаемого набора корпусов (http://www.nltk.org/nltk_data/), включая инструменты для тегирования для нескольких языков и набора данных, на которых будут тестироваться алгоритмы. Они имеют лицензию, отличающуюся от лицензии nltk, поэтому убедитесь, что вы проверили лицензию выбранного набора данных. Если знаете название корпуса текста, который нужно загрузить (в нашем случае это Punkt tokenizer[114], который мы можем использовать для разбиения текстовых файлов на предложения или отдельные слова), можете сделать это с помощью командной строки:
$ python3 — m nltk.downloader punkt — dir=/usr/local/share/nltk_data.
Или можете загрузить его в рамках интерактивной сессии — stopwords содержит список слов, из-за которых значительно увеличивается общее количество слов текста вроде the, in или and во многих языках:
>>> import nltk.
>>> nltk.download('stopwords', download_dir='/usr/local/share/nltk_data').
[nltk_data] Downloading package stopwords to /usr/local/share/nltk_data…
[nltk_data] Unzipping corpora/stopwords.zip.
True.
Если вы не знаете название необходимого вам корпуса, можете запустить интерактивный загрузчик из интерпретатора Python, вызвав метод nltk.download() без передачи первого аргумента:
>>> import nltk.
>>> nltk.download(download_dir='/usr/local/share/nltk_data').
Далее можно загрузить самую свежую версию набора данных и запустить ее в обработку. В этом фрагменте кода мы загружаем сохраненную копию «Дзена Питона»:
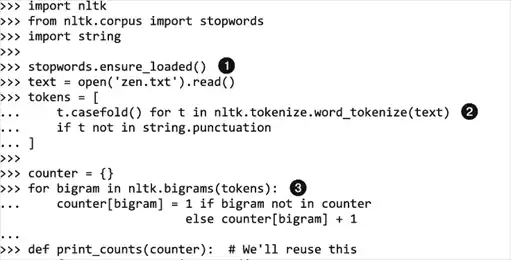
 Корпуса загружаются медленно, поэтому нам нужно сделать это для того, чтобы действительно загрузить корпус stopwords.
 Токенизатор требует наличия обученной модели — Punkt tokenizer (используемый по умолчанию) поставляется с моделью, обученной для английского языка (также выбран по умолчанию).
 Биграмма — это пара соседних слов. Мы проходим по биграммам и считаем, сколько раз они встречаются.
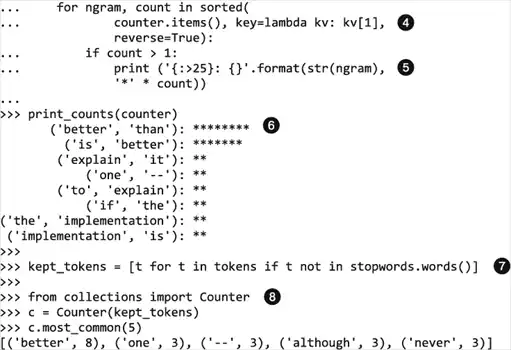
 Ключом для функции sorted() является количество элементов, они отсортированы в обратном порядке.
 Конструкция '{:>25}' выравнивает справа строку с общей длиной, равной 25 символам.
 Наиболее часто встречающейся биграммой «Дзена Питона» является фраза better than («лучше, чем»).
 В этот раз для того, чтобы избежать большого количества слов the и is, мы удалим stopwords.
 В версиях Python 3.1 и выше для подсчета можно использовать метод collections.Counter.
В этой библиотеке еще много интересного — выделите выходные и исследуйте ее!
- 1.
- 2.
- 3.
- 4.
- 5.
- 6.
- 7.
- 8.
- 9.
- 10.
- 11.
- 12.
- 13.
- 14.
- 15.
- 16.
- 17.
- 18.
- 19.
- 20.
- 21.
- 22.
- 23.
- 24.
- 25.
- 26.
- 27.
- 28.
- 29.
- 30.
- 31.
- 32.
- 33.
- 34.
- 35.
- 36.
- 37.
- 38.
- 39.
- 40.
- 41.
- 42.
- 43.
- 44.
- 45.
- 46.
- 47.
- 48.
- 49.
- 50.
- 51.
- 52.
- 53.
- 54.
- 55.
- 56.
- 57.
- 58.
- 59.
- 60.
- 61.
- 62.
- 63.
- 64.
- 65.
- 66.
- 67.
- 68.
- 69.
- 70.
- 71.
- 72.
- 73.
- 74.
- 75.
- 76.
- 77.
- 78.
- 79.
- 80.
- 81.
- 82.
- 83.
- 84.
- 85.
- 86.
- 87.
- 88.
- 89.
- 90.
- 91.
- 92.
- 93.
- 94.
- 95.
- 96.
- 97.
- 98.
- 99.
- 100.
- 101.
- 102.
- 103.
- 104.
- 105.
- 106.
- 107.
- 108.
- 109.
- 110.
- 111.
- 112.
- 113.
- 114.
- 115.
- 116.
- 117.
- 118.
- 119.
- 120.
- 121.
- 122.
- 123.
- 124.
- 125.
- 126.
- 127.
- 128.
- 129.
- 130.
- 131.
- 132.
- 133.
- 134.
- 135.
- 136.
- 137.
- 138.
- 139.
- 140.
- 141.
- 142.
- 143.
- 144.
- 145.
- 146.
- 147.
- 148.
- 149.
- 150.
- 151.
- 152.
- 153.
- 154.
- 155.
- 156.
- 157.
- 158.
- 159.
- 160.
- 161.
- 162.
- 163.
- 164.
- 165.
- 166.
- 167.
- 168.
- 169.
- 170.
- 171.
- 172.
- 173.
- 174.
- 175.
- 176.
- 177.
- 178.
- 179.
- 180.
- 181.
- 182.
- 183.
- 184.
- 185.
- 186.
- 187.
- 188.
- 189.
- 190.
- 191.
- 192.
- 193.
- 194.
- 195.
- 196.
- 197.
- 198.
- 199.
- 200.
- 201.
- 202.
- 203.
- 204.
- 205.
- 206.
- 207.
- 208.
- 209.
- 210.
- 211.
- 212.
- 213.
- 214.
- 215.
- 216.
- 217.
- 218.
- 219.
- 220.
- 221.
- 222.
- 223.
- 224.
- 225.
- 226.
- 227.
- 228.
- 229.
- 230.
- 231.
- 232.
- 233.
- 234.
- 235.
- 236.
- 237.
- 238.
- 239.
- 240.
- 241.
- 242.
- 243.
- 244.
- 245.
- 246.
- 247.
- 248.
- 249.
- 250.
- 251.
- 252.
- 253.
- 254.
- 255.
- 256.
- 257.