Автостопом по Python.
Веб-клиенты.
Протокол передачи гипертекста (Hypertext Transfer Protocol, HTTP) — это протокол приложения, предназначенный для распределенных, объединенных информационных систем, использующих гипермедиа. Является основным способом обмена данными во Всемирной сети. Данный раздел посвящен вопросу получения данных из Интернета с помощью библиотеки Requests.
Модуль стандартной библиотеки Python urllib предоставляет большую часть функциональности HTTP, которая вам может понадобиться, но на низком уровне для нее характерно выполнение немало объема работы для решения относительно простых задач (вроде получения данных от сервера HTTPS, который требует аутентификации). В документации к модулю urllib.request говорится, чтобы вы использовали вместо него библиотеку Requests.
Requests работает со всеми запросами HTTP в Python, что позволяет выполнить бесшовную интеграцию с веб-сервисами. Нет необходимости добавлять вручную строки запроса в ваши URL или выполнять кодирование ваших данных для команды POST. Поддержание соединений (устойчивые соединения HTTP) и объединение соединений HTTP в пулы доступны благодаря классу request.sessions.Session, поддерживаемому библиотекой urllib3 (https://pypi.python.org/pypi/urllib3), которая встроена в библиотеку Requests (это значит, что вам не нужно устанавливать ее отдельно). Вы можете получить ее с помощью pip:
$ pip install requests.
В документации к Requests (http://docs.python-requests.org/en/latest/index.html) более подробно описывается все то, что мы будем рассматривать далее.
API для сети.
Практически все — от Бюро переписи населения США до Национальной библиотеки Нидерландов — имеют API; его вы можете использовать для получения данных, которыми они хотят поделиться. Некоторые из этих API, вроде Twitter и Facebook, позволяют вам (или приложениям, которые вы используете) модифицировать эти данные. Возможно, вы слышали о термине RESTful API. REST расшифровывается как representational state transfer («передача состояния представления») — это парадигма, на которой основан способ проектирования HTTP 1.1, но она не является стандартом, протоколом или требованием. Однако большинство поставщиков API для веб-сервисов следуют принципам проектирования RESTful.
Воспользуемся кодом для того, чтобы проиллюстрировать распространенные термины:

 Метод является частью протокола HTTP. В RESTful API разработчик выбирает, какое действие предпримет сервер, и указывает его вам в документации к API. По адресу http://bit.ly/http-method-defs содержится список всех методов, самые распространенные из них GET, POST, PUT и DELETE. Зачастую «глаголы HTTP» соответствуют своим именам — получают, изменяют или удаляют данные.
 Базовый URI является корнем API.
 Клиенты будут указывать конкретный элемент, для которого им нужны данные.
 Вы можете задать и другие типы мультимедиа.
Этот код выполнил запрос HTTP к ресурсу http://pypi.python.org/pypi/requests/json, который является бэкендом JSON для PyPI. Если вы взглянете на него в браузере, то увидите большую строку JSON. В библиотеке Requests возвращаемым значением для запроса HTTP будет объект типа Response:
>>> import requests.
>>> response = requests.get('http://pypi.python.org/pypi/requests/json').
>>> type(response).
<class 'requests.models.Response'>
>>> response.ok.
True.
>>> response.text····# Эта команда возвращает весь текст ответа.
>>> response.json()··# Эта команда преобразует текст ответа в словарь.
PyPI вернул текст в формате JSON. Не существует правила, которое регулирует формат отправляемых данных, но во многих API используются JSON или XML.
Анализ JSON. Нотация объектов Javascript (Javascript Object Notation, JSON) полностью соответствует своему имени: используется для определения объектов в JavaScript. Библиотека Requests имеет встроенный анализатор JSON в объектах типа Response.
Библиотека json (https://docs.python.org/3/library/json.html) может анализировать JSON, расположенный в строках или файлах, и помещать его в словарь Python (или список, если это вам так удобнее). Она также преобразует словари или списки Python в строки JSON. Например, в следующей строке содержатся данные JSON:
Json_string = '{"first_name": "Guido", "last_name":"van Rossum"}'.
Проанализировать ее можно следующим образом:
Import json.
Parsed_json = json.loads(json_string).
Теперь вы можете использовать эти данные как словарь:
Print(parsed_json['first_name']).
"Guido".
Вы также можете преобразовать следующий словарь в JSON:
D = {
····'first_name': 'Guido',
····'last_name': 'van Rossum',
····'titles': ['BDFL', 'Developer'],
}
Print(json.dumps(d)).
'{"first_name": "Guido", "last_name": "van Rossum",
··"titles": ["BDFL", "Developer"]}'.
Simplejson для ранних версий Python. Библиотека json была добавлена в Python 2.6. Если вы используете более раннюю версию Python, можете загрузить из PyPI библиотеку simplejson (https://simplejson.readthedocs.org/en/latest/). Simplejson предоставляет такой же API, как и модуль стандартной библиотеки json, но обновляется чаще, чем Python. Разработчики, работающие с более старыми версиями Python, все еще могут использовать функциональность, доступную в библиотеке json, импортировав simplejson. Вы можете выбрать simplejson как полноценную замену для json следующим образом: Import simplejson as json. После импортирования библиотеки simplejson под именем json все предыдущие примеры будут работать так же, как если бы вы использовали стандартную библиотеку json.Анализ XML.
В стандартной библиотеке есть анализатор XML (методы parse() и fromstring() класса xml.etree.ElementTree), но this использует библиотеку Expat и создает объект ElementTree, сохраняющий структуру XML. Это значит, что требуется итерировать по нему и опрашивать потомков, дабы получить содержимое. Если нужно лишь получить данные, обратитесь к untangle или xmltodict. Вы можете установить их командой pip:
$ pip install untangle.
$ pip install xmltodict.
• untangle (https://github.com/stchris/untangle). Принимает документ XML и возвращает объект Python, чья структура отражает узлы и атрибуты документа. Например, такой файл XML:
<?xml version="1.0" encoding="UTF-8"?>
<root>
····<child name="child1" />
</root>
Можно загрузить следующим образом:
Import untangle.
Obj = untangle.parse('path/to/file.xml').
Можно получить имя элемента-потомка:
Obj.root.child['name'] # is 'child1'.
• xmltodict (http://github.com/martinblech/xmltodict). Преобразует XML в словарь. Например, такой файл XML:
<mydocument has="an attribute">
··<and>
····<many>elements</many>
····<many>more elements</many>
··</and>
··<plus a="complex">
····element as well.
··</plus>
</mydocument>
Можно загрузить в объект типа OrderedDict (из модуля collections стандартной библиотеки Python):
Import xmltodict.
With open('path/to/file.xml') as fd: doc = xmltodict.parse(fd.read()).
Можно получить доступ к элементам, атрибутам и значениям:
Doc['mydocument']['@has'] # is u'an attribute'.
Doc['mydocument']['and']['many'] # is [u'elements', u'more elements'].
Doc['mydocument']['plus']['@a'] # is u'complex'.
Doc['mydocument']['plus']['#text'] # is u'element as well'.
С помощью xmltodict можно преобразовать словарь обратно в XML, вызвав функцию unparse(). Она имеет потоковый режим, подходящий для обработки файлов, не помещающихся в память, а также поддерживает пространства имен.
Скраппинг сайтов.
Сайты не всегда предлагают данные в удобных форматах вроде CSV или JSON, но HTML представляет собой структурированные данные — здесь вступает в дело скраппинг.
Скраппинг сайтов — это использование компьютерной программы для анализа веб-страницы и сбора необходимых данных в формате, наиболее удобном для вас (при этом сохраняя их структуру).
 По мере того как сайты предлагают свои API, они явно просят вас не использовать скраппинг: API открывает вам доступ только к тем данным, которыми владельцы сайта желают поделиться. Перед тем как начать скраппинг, прочтите условия использования целевого сайта и будьте законопослушным гражданином.
Lxml.
Lxml (http://lxml.de/) — это довольно обширная библиотека, написанная для выполнения быстрого анализа документов XML и HTML. Позволяет обрабатывать некоторый объем некорректной разметки.
Загрузите ее с помощью pip:
$ pip install lxml.
Используйте метод requests.get, чтобы получить веб-страницу с данными, преобразуйте их с помощью модуля html и сохраните результат в дереве:
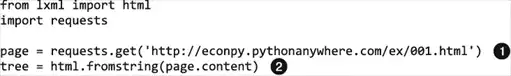
Это реальная веб-страница, и данные, которые мы показываем, тоже реальные (вы можете посетить эту страницу в браузере).
 Мы используем свойство page.content, а не page.text, поскольку метод html.fromstring() неявно ожидает получить объект типа bytes.
Теперь дерево содержит весь файл HTML и имеет удобную структуру. Мы можем пойти двумя путями: использовать XPath (http://lxml.de/xpathxslt.html) или CSSSelect (http://lxml.de/cssselect.html). Оба этих способа стандартные для указания пути с помощью дерева HTML, они определены и поддерживаются World Wide Web Consortium (W3C) и реализованы как модули в lxml. В этом примере мы используем XPath. Руководство по XPath (http://www.w3schools.com/xsl/xpath_intro.asp) поможет вам начать работу.
Существуют различные инструменты для получения XPath элементов изнутри вашего браузера вроде Firebug for Firefox или Chrome Inspector. Если используете Chrome, щелкните правой кнопкой мыши на элементе, выберите пункт меню Inspect element (Инспектировать элемент), подсветите код, снова щелкните правой кнопкой и выберите Copy XPath (Скопировать XPath).
После небольшого анализа мы видим, что данные на нашей странице содержатся в двух элементах: div (с заголовком buyer-name) и span (имеющий класс item-price):
<div title="buyer-name">Carson Busses</div>
<span class="item-price">$29.95</span>
Зная это, мы можем создать корректный запрос XPath и использовать lxml-функцию xpath, как показано в примере:
# Это создаст список покупателей:
Buyers = tree.xpath('//div[@title="buyer-name"]/text()').
# Это создаст список цен.
Prices = tree.xpath('//span[@class="item-price"]/text()').
Посмотрим, что получилось:
>>> print('Buyers: ', buyers).
Buyers: ['Carson Busses', 'Earl E. Byrd', 'Patty Cakes',
'Derri Anne Connecticut', 'Moe Dess', 'Leda Doggslife', 'Dan Druff',
'Al Fresco', 'Ido Hoe', 'Howie Kisses', 'Len Lease', 'Phil Meup',
'Ira Pent', 'Ben D. Rules', 'Ave Sectomy', 'Gary Shattire',
'Bobbi Soks', 'Sheila Takya', 'Rose Tattoo', 'Moe Tell'].
>>>
>>> print('Prices: ', prices).
Prices: ['$29.95', '$8.37', '$15.26', '$19.25', '$19.25',
'$13.99', '$31.57', '$8.49', '$14.47', '$15.86', '$11.11',
'$15.98', '$16.27', '$7.50', '$50.85', '$14.26', '$5.68',
'$15.00', '$114.07', '$10.09'].
- 1.
- 2.
- 3.
- 4.
- 5.
- 6.
- 7.
- 8.
- 9.
- 10.
- 11.
- 12.
- 13.
- 14.
- 15.
- 16.
- 17.
- 18.
- 19.
- 20.
- 21.
- 22.
- 23.
- 24.
- 25.
- 26.
- 27.
- 28.
- 29.
- 30.
- 31.
- 32.
- 33.
- 34.
- 35.
- 36.
- 37.
- 38.
- 39.
- 40.
- 41.
- 42.
- 43.
- 44.
- 45.
- 46.
- 47.
- 48.
- 49.
- 50.
- 51.
- 52.
- 53.
- 54.
- 55.
- 56.
- 57.
- 58.
- 59.
- 60.
- 61.
- 62.
- 63.
- 64.
- 65.
- 66.
- 67.
- 68.
- 69.
- 70.
- 71.
- 72.
- 73.
- 74.
- 75.
- 76.
- 77.
- 78.
- 79.
- 80.
- 81.
- 82.
- 83.
- 84.
- 85.
- 86.
- 87.
- 88.
- 89.
- 90.
- 91.
- 92.
- 93.
- 94.
- 95.
- 96.
- 97.
- 98.
- 99.
- 100.
- 101.
- 102.
- 103.
- 104.
- 105.
- 106.
- 107.
- 108.
- 109.
- 110.
- 111.
- 112.
- 113.
- 114.
- 115.
- 116.
- 117.
- 118.
- 119.
- 120.
- 121.
- 122.
- 123.
- 124.
- 125.
- 126.
- 127.
- 128.
- 129.
- 130.
- 131.
- 132.
- 133.
- 134.
- 135.
- 136.
- 137.
- 138.
- 139.
- 140.
- 141.
- 142.
- 143.
- 144.
- 145.
- 146.
- 147.
- 148.
- 149.
- 150.
- 151.
- 152.
- 153.
- 154.
- 155.
- 156.
- 157.
- 158.
- 159.
- 160.
- 161.
- 162.
- 163.
- 164.
- 165.
- 166.
- 167.
- 168.
- 169.
- 170.
- 171.
- 172.
- 173.
- 174.
- 175.
- 176.
- 177.
- 178.
- 179.
- 180.
- 181.
- 182.
- 183.
- 184.
- 185.
- 186.
- 187.
- 188.
- 189.
- 190.
- 191.
- 192.
- 193.
- 194.
- 195.
- 196.
- 197.
- 198.
- 199.
- 200.
- 201.
- 202.
- 203.
- 204.
- 205.
- 206.
- 207.
- 208.
- 209.
- 210.
- 211.
- 212.
- 213.
- 214.
- 215.
- 216.
- 217.
- 218.
- 219.
- 220.
- 221.
- 222.
- 223.
- 224.
- 225.
- 226.
- 227.
- 228.
- 229.
- 230.
- 231.
- 232.
- 233.
- 234.
- 235.
- 236.
- 237.
- 238.
- 239.
- 240.
- 241.
- 242.
- 243.
- 244.
- 245.
- 246.
- 247.
- 248.
- 249.
- 250.
- 251.
- 252.
- 253.
- 254.
- 255.
- 256.
- 257.